Придумал себе эксперимент. Дал исправление одного и того же бага с публикацией сайта на сервер пятью нейронкам. Две его починили (Claude Code и Codex), три сломали ещё больше. Хочется записать первых двух в лучшие, но один баг с публикацией сайта не даёт точной картины: на нём видна манера работы конкретной ИИ-модели. Зато видно, какая ошибка опаснее. Непочиненный баг заметен сразу. А вот правку, после которой рядом перестало работать то, что работало, принимать было опасно. Главный вопрос в ней для меня один: как поймать такую поломку до того, как правка уйдёт в проект.
Можно ли выбрать лучшую нейросеть для программирования по одному исправленному багу
Нельзя: даже таблица из 500 задач почти не различает лидеров. Речь о SWE-bench Verified, бенчмарке, то есть наборе задач с автоматической проверкой, по которому сравнивают нейросети для кода. Задачи в нём взяты из реальных проблем на GitHub и отобраны людьми вместе с OpenAI.
Два лучших результата в Verified решают по 396 задач из 500. Из 500 задач только в 164 результаты первой десятки участников различаются (Liu и соавторы, arXiv). Парный тест, который проверяет, не случайна ли разница между соседями по таблице, не разделил ни одну из 29 соседних пар в первой тридцатке. Я думал, хотя бы часть соседей разойдётся. Составители обзора таблицы на LLMLearner и сами предупреждают, что малые разрывы могут ничего не значить, и советуют сравнивать при одной оболочке и одинаковых настройках.
Оболочка — программа вокруг нейросети, через которую та читает файлы проекта и запускает команды. Такую работу называют агентным режимом, так работает, например, Claude Code. По тем же данным Liu и соавторов, у одной нейросети разброс между оболочками доходит до 29,8 процентного пункта доли решённых задач, а у всей первой тридцатки он 8,8 пункта. Обвязка меняет результат сильнее, чем разница между первым и тридцатым местом.
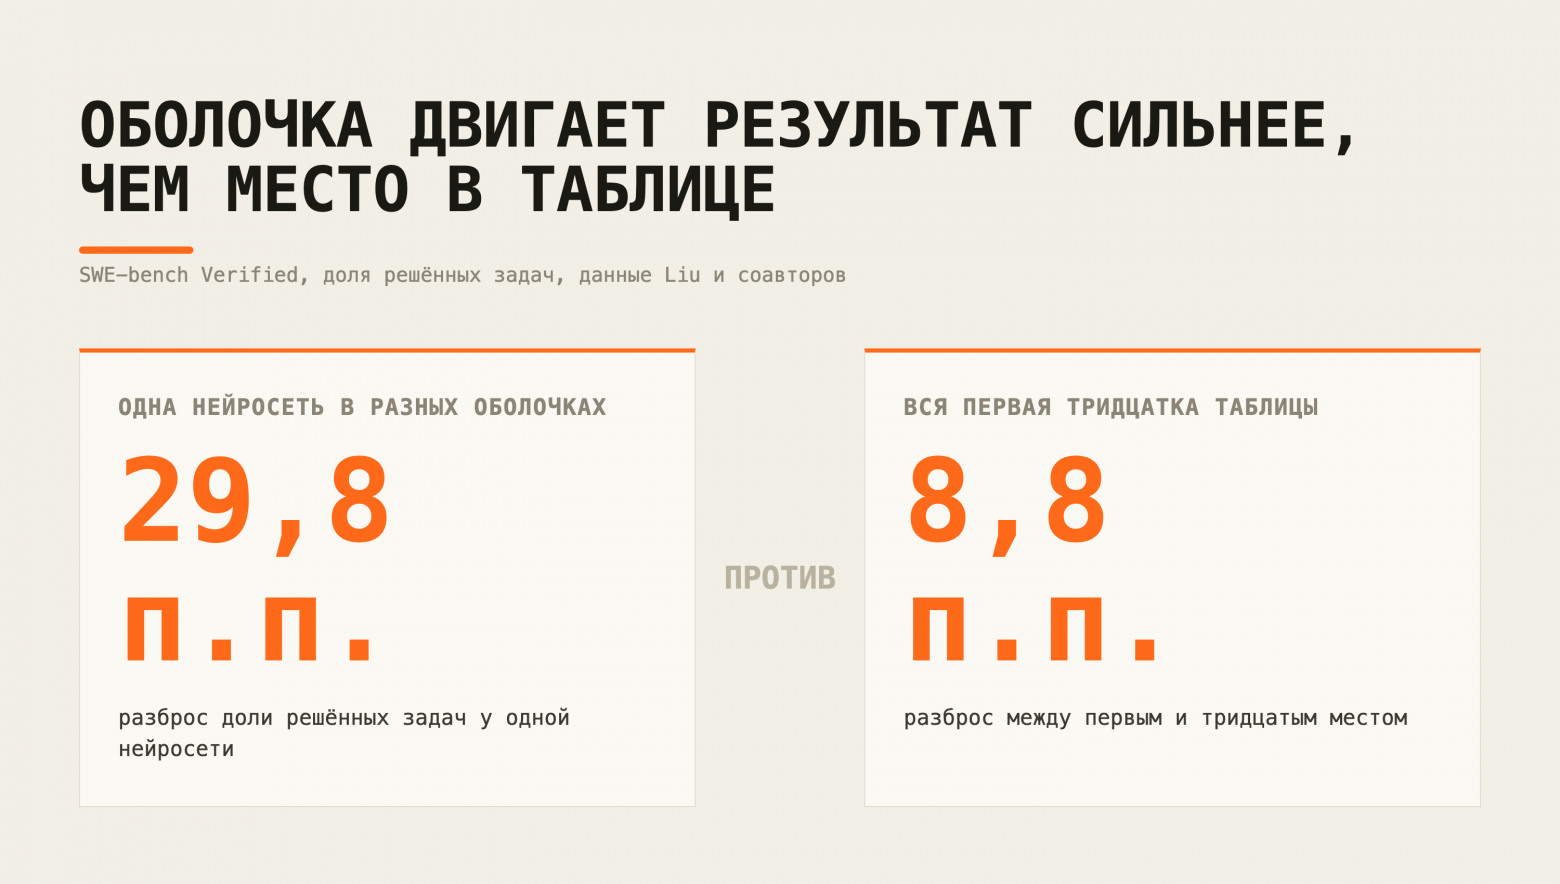
Если 500 задач не разделяют соседей, один баг не разделит их тем более. Две починки и три поломки в моём опыте говорят о том, как эти нейросети повели себя на одном баге. На другом расклад может выйти другим.
Почему правка нейросети задевает код за пределами задачи
Нейросеть ломает соседний код, когда правит больше, чем просили, и не проверяет, что стало с остальным. Поломку того, что раньше работало, разработчики зовут регрессией. Про исходный баг вы хотя бы знаете, регрессию находите позже.
Про проверку прямо пишет Anthropic в документации Claude Code: если агенту нечего запустить, чтобы узнать, готова ли работа, он останавливается, когда она выглядит готовой. Роль тестов тогда достаётся человеку, и ошибка ждёт, пока он её заметит.
Лишние правки видны в разборе бенчмарка SlopCodeBench на TechRadar. Код агентов вышел в 2,2 раза многословнее и запутаннее по структуре, чем в 48 Python-проектах, которые поддерживают люди. По ходу работы над задачей многословность росла в 89,8% прогонов, запутанность в 80%. Чем больше строк задевает правка, тем больше места для регрессии. Поэтому в diff, то есть в списке строк, которые изменила нейросеть, первым делом стоит смотреть, сколько строк и файлов она тронула.
Почему правка нейросети может пройти все автотесты и всё равно сломать рабочий код
Прошедших тестов мало: код может пройти тесты и всё равно упустить важные случаи или сломать то, что работало. Это называют подгонкой под тесты, на SWE-bench её отдельно изучали Ahmed и соавторы.
Авторы работы Probe to Generate усилили тесты и заново проверили десять лучших агентов для починки кода: доля решённых задач упала на 4,2–9,0%. По их оценке, многие принятые раньше правки проскочили через дыры в тестах и не делали всего, что требовала задача.
Поэтому отчёт нейросети о починке сам по себе ничего не доказывает, а проверять стоит сами изменения в коде и прогон тестов.
Codex или Claude Code: кому отдать правку в своём проекте
По одному багу победителя не назвать, хотя я работаю и в Claude Code, и в Codex. Результат даёт пара из нейросети и оболочки, а среду агента вы во многом настраиваете сами: режим подтверждений, файл правил, проверки. В Claude Code новые сессии в терминале и VS Code по умолчанию стартуют в авто-режиме, где команды выполняются без подтверждения каждой (документация Anthropic). Чем реже вы подтверждаете шаги, тем внимательнее стоит смотреть на итог.
Правку разумно отдавать той нейросети, чью работу на ваших задачах легче проверить: она меняет мало строк, пишет тест на баг и не трогает файлы, о которых её не просили. Это видно за несколько задач в своём проекте, таблица лидеров тут не подскажет.
Что написать в задаче, чтобы нейросеть не переписывала лишний код
Если просить нейросеть исправить код без границ, она может взяться и за соседнюю функцию. В агентном режиме ей доступен контекст репозитория, то есть файлы проекта, которые она успела прочитать, и править она может любой из них. Поэтому ограничения лучше задать до правки:
назвать файл и функцию, где сидит баг;
описать, как баг воспроизвести и что должно получиться;
прямо написать, что остальной код трогать нельзя;
попросить сначала план правки, а код писать после вашего ответа;
попросить тест, который падает до правки и проходит после.
Постоянные запреты удобно держать в файле правил для ИИ-агента: тогда их не нужно повторять в каждой задаче.
Что проверить в правке нейросети перед тем, как принять её в проект
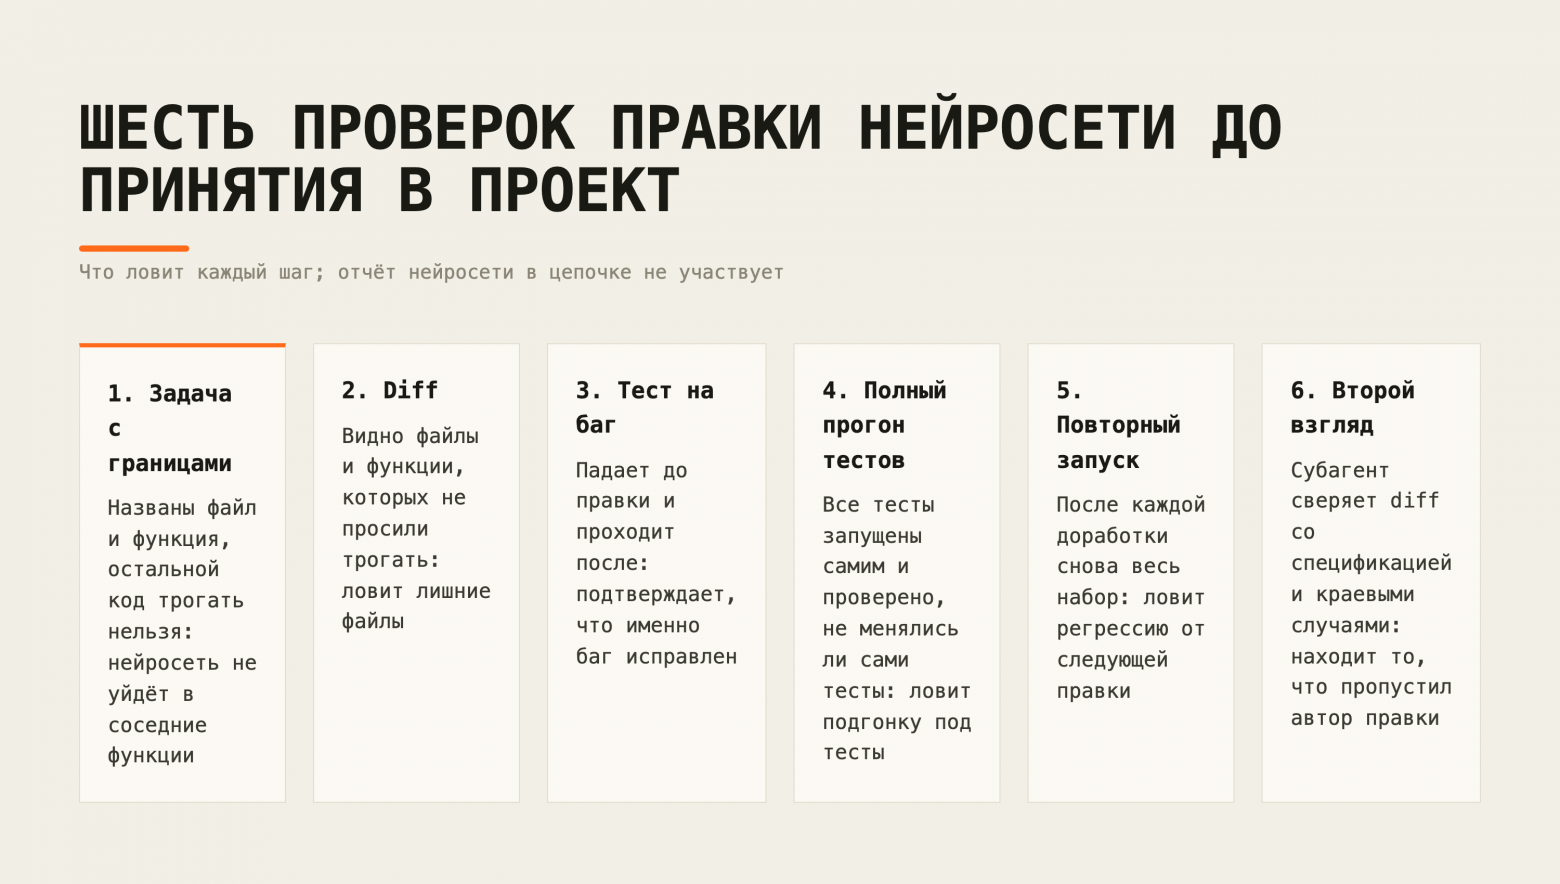
Весь diff. Открыть изменения и найти файлы и функции, которых не просили трогать. Правка в три строки в одной функции и правка на двести строк в шести файлах по риску разные, хотя обе называются починкой.
Границы задачи. Сверить изменения с тем, о чём просили. Переименованная переменная, переписанная соседняя функция или удалённая проверка ввода — повод вернуть правку.
Тест на сам баг. Он падает до правки и проходит после. Если нейросеть его не написала, попросить.
Полный прогон тестов. Запустить все тесты самому, в своём окружении, и заглянуть, не меняла ли нейросеть сами тесты. Попросить нейросеть назвать команду запуска проверок; если тестов в проекте нет, пусть сначала напишет тест, воспроизводящий баг.
Повторный запуск после доработок. После каждой новой просьбы что-то поправить снова прогнать весь набор: следующая правка может задеть то, что прошло в прошлый раз.
Второй взгляд. Документация Claude Code предлагает поручить субагенту, то есть отдельному экземпляру нейросети, проверить diff по спецификации и тестам на краевые случаи, то есть на необычные входные данные, без замечаний про стиль. Там же описан стоп-хук: скрипт проверки, который возвращает Claude Code к работе, пока проверка не пройдёт.
Правку нейросети принимает человек по изменённым строкам и тестам
Выбирать нейросеть для кода по одному удачному или неудачному исправлению нельзя: на одном баге видна манера работы, рейтинга из него не собрать. Опаснее не та ИИ-модель, которая баг не починила, а та, что уверенно отчиталась о починке и задела соседний код. От этого защищают узкая постановка задачи, просмотр diff и прогон тестов, с каким бы сервисом вы ни работали. Решение о правке принимает человек: по тому, что изменилось в diff, и по тестам, которые он запустил сам.



Комментарии 0