Я юрист и много работаю с документами Microsoft Office, в основном с Word. Договоры, приложения, дополнительные соглашения. Часто это файлы, которые уже несколько раз прошли между сторонами: с комментариями, исправлениями и своей историей согласования.
Когда я начал пользоваться ИИ, довольно быстро возникло желание автоматизировать всю эту работу. Обсудить с моделью, что нужно изменить, и получить готовый документ. Чтобы не сидеть потом в Word и не переносить правки из чата вручную.
В итоге получилось. Но сначала я потратил много сил на подход, который для моей задачи оказался слишком ограниченным.
От чата к работе с файлами
ИИ я использую примерно с весны 2023 года, с выхода GPT‑4 (2023 год). За это время хорошо увидел, как менялась работа с такими инструментами.
Сначала всё происходило в чате. Подробно описываешь ситуацию, вставляешь условие договора, объясняешь, на чьей ты стороне и что тебя беспокоит. Получаешь ответ, обсуждаешь формулировку, что-то уточняешь.
Это помогало. Но сбор контекста и работа с самим документом оставались на мне. Модель предложила удачный вариант пункта, теперь его надо найти в договоре, аккуратно заменить, проверить соседние положения и при необходимости добавить комментарий.
Потом появились проекты и другие способы собрать материалы в одном месте. Стало удобнее: можно приложить договор, переписку и дополнительные документы, задать общие инструкции. Уже не приходится при каждом вопросе заново объяснять всю сделку.
Следующий заметный для меня шаг произошёл с появлением агентских сред. Под этим я понимаю обвязку вокруг модели, которая позволяет ей работать с файлами, запускать код, получать результат и продолжать задачу. В некоторых средах ещё и подключать субагентов.
Тогда запрос «посмотри документы и подготовь изменения» стал означать гораздо больше, чем «напиши ответ в чат».
И у меня возник довольно простой вопрос. Если агент уже умеет разбирать Word-файл и читать XML внутри, почему он не может сам внести туда согласованные правки?
Первая попытка: заранее описать каждую операцию
Сначала я пошёл по пути строгого контроля. Сделал MCP-сервер с заранее определёнными операциями над документом. MCP здесь нужен для того, чтобы подключённая модель могла вызывать инструменты сервера.
Логика выглядела разумно: модель решает, что нужно изменить, а обычный код отвечает за то, чтобы корректно выполнить операцию. Найти нужный текст, проверить исходное состояние, внести исправление, убедиться, что ничего лишнего не затронуто.
На практике я столкнулся с тем, насколько разными бывают документы, которые на экране выглядят почти одинаково.
Файл .docx представляет собой ZIP-пакет. Внутри находятся XML-части с текстом, стилями, комментариями и другими элементами документа. Даже обычный абзац состоит из отдельных фрагментов текста со своими свойствами.
Поэтому фраза, которую я вижу в Word как одну строку, внутри может быть разбита на несколько частей. Рядом окажется комментарий, часть текста уже будет помечена как вставленная, другая как удалённая. Всё это может находиться в ячейке таблицы.
Для юриста это обычный рабочий документ после нескольких раундов переговоров. Для программы, которая должна аккуратно заменить несколько слов, уже появляется много условий.
Особенно если требуется сохранить прежние исправления. Мне ведь нужно добавить свою правку в существующую историю, чтобы другая сторона могла понять, что изменилось именно сейчас.
Первая версия поддерживала определённые случаи и отказывалась выполнять операции, которые выходили за эти границы. Чтобы обработать очередной документ, приходилось расширять набор правил и проверок.
Постепенно я понял, что занимаюсь разработкой всё более сложного редактора Word. А исходная задача была гораздо скромнее: избавить себя от ручного переноса правок. Я не думаю, что такой подход в принципе неправильный. Но для моих документов поддерживать все нужные варианты оказалось слишком тяжело.
А что, если способ правки выберет сама модель?
Следующая мысль пришла из повседневной работы с агентами: современные модели уже довольно хорошо пишут код. В том числе код для разбора конкретного файла. Так почему я заранее ограничиваю модель набором операций, которые успел реализовать сам?
Я попробовал другую конструкцию. Сервер предоставляет доступ к выбранным документам и среду для исполнения Python. Модель изучает файл, при необходимости разбирает XML и пишет код под конкретное изменение.
Если нужный фрагмент устроен необычно, агент может сначала посмотреть его структуру. Если выполнение закончилось ошибкой, получает эту ошибку и может скорректировать код. Для этого не требуется добавлять в сервер новую команду под каждый случай.
Эту версию я назвал Veqtor Workspace.
Сейчас у сервера четыре MCP-инструмента:
workspace_infoобъясняет, как устроена рабочая среда;document_taskсоздаёт задачу с рабочей копией документа и сохраняет результат;run_pythonвыполняет код, который написала модель;check_docxпомогает сравнить исходный файл с результатом и при необходимости получить превью.
При этом я сохранил ограничения на доступ и запись. В моей реализации Python работает локально, без сетевого доступа, с выбранными файлами и отдельной рабочей папкой. Исходная версия сохраняется. Перед записью результата сервер проверяет, не изменился ли исходный файл за время работы.
Модель получила свободу выбирать способ редактирования внутри этой среды.
Есть и вспомогательные функции для чтения документа и подготовки точечных замен. Пользоваться ими необязательно: если для конкретного случая нужен другой способ, агент может написать свой код.
Проверка документа тоже осталась. Но её результат нужно понимать в контексте задания. Например, если я прямо попросил удалить комментарий, отличие от исходного файла ожидаемо. Сам факт изменения ещё ничего не говорит о том, правильно ли выполнена работа.
MCP здесь оказался удобным способом подключать эту среду к разным клиентам. Сам сервер не содержит языковой модели: рассуждает тот Claude или та модель Chat GPT, с которыми я работаю (к слову, последнее время мне больше нравится Astra в юридических задачах).
И ещё одна техническая деталь: это работа с сохранённым файлом, а не управление открытым окном Word. Несохранённые изменения в редакторе сервер не видит.
Что получилось на практике
В моих проверках с Claude и моделями OpenAI этот подход сработал. Агент смог прочитать документы, разобраться в нужном фрагменте и подготовить файл с исправлениями в режиме Track Changes.
Для меня особенно важным оказалось то, как именно выглядят изменения.
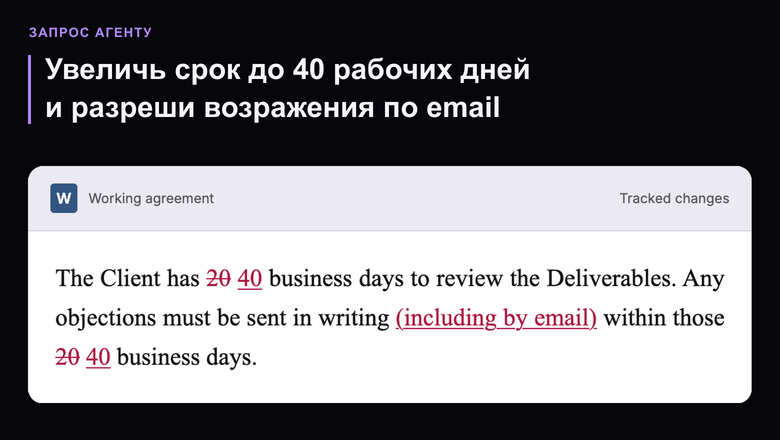
Если нужно поменять срок с 30 на 45 дней, я хочу увидеть замену числа. Когда вместо этого весь абзац помечен как удалённый и вставленный заново, другой стороне приходится ещё раз сравнивать весь текст (на практике, это очень плохой способ внесения правок, очень не люблю когда кто то так делает).
В новой схеме удалось получать точечные правки: менять нужное слово, число или фрагмент, сохраняя окружающий текст. В Word это обычные исправления, которые можно просмотреть, принять или отклонить.
Пример требования к агенту может выглядеть так:
В этом пункте замени 30 дней на 45. Сохрани остальные формулировки, форматирование, существующие исправления и комментарии. Новое изменение внеси в режиме правок.
Здесь важен весь запрос. Просто получить в конце текст с числом 45 недостаточно. Нужно ещё сохранить документ, с которым продолжат работать другие люди.
В результате у меня изменилась сама последовательность действий. Я обсуждаю с моделью содержание, согласовываю необходимые изменения и прошу внести их в файл. После этого открываю результат и проверяю его. Переносить каждую формулировку из чата в Word уже не требуется.
Конечно, сложности формата от этого не исчезли. Модель может выбрать неудачный способ редактирования, затронуть лишний текст или неправильно понять старые исправления. Просмотр XML и автоматическая проверка также не заменяют проверку отображения в Word.
Поэтому за содержание и итоговый документ я по-прежнему отвечаю сам. Автоматизировать удалось именно ту часть, которая меня раздражала: механическое внесение уже определённых изменений.
Отдельно уточню про локальность. Код обработки файла выполняется на моём компьютере. Но при использовании облачной модели прочитанный текст может передаваться ей через результаты вызовов инструментов. Это нужно учитывать при выборе документов и среды работы.
Что я теперь думаю про такую архитектуру
После этого опыта у меня появилось ощущение, что для некоторых задач мы будем всё меньше заранее описывать каждый возможный сценарий.
Особенно там, где входные данные очень разные. Два договора могут содержать одинаковую фразу, но хранить её внутри совершенно по-разному. Модели можно дать возможность изучить конкретный случай и подобрать способ обработки уже после этого.
При этом детерминированный код никуда не исчезает. Написанный моделью Python тоже исполняется обычным образом. Вопрос в том, кто и когда выбирает последовательность действий: разработчик заранее или агент при работе с конкретным документом.
Для себя я пока разделил это так: доступ к файлам, сохранение исходников и запись результата остаются под контролем сервера. Способ чтения и редактирования выбирает модель. У неё есть инструменты проверки, а окончательный результат смотрю я.
У гибкости есть цена. Агенту приходится разбираться в файле, писать и запускать код, иногда исправлять собственные ошибки. Готовая функция для хорошо известного случая может быть быстрее и предсказуемее. Но в моём сценарии возможность обработать очередной нестандартный документ оказалась важнее, чем заранее иметь отдельную операцию для каждого варианта.
Я совершенно не разработчик. В лучшем случае вайбкодер, если пользоваться этим словом. Поэтому мне интересно мнение тех, кто строит такие системы профессионально.
Насколько, по-вашему, перспективна архитектура, в которой сервер предоставляет рабочую среду и ограничения доступа, а код для конкретной задачи пишет модель? Где вы бы провели границу между такой свободой и заранее реализованными операциями?


Комментарии 0