Генерировать программный код, создавать трехмерные модели, обрабатывать фотографии и даже запускать генерацию изображений сегодня можно непосредственно на ноутбуке. Причем для этого необязательно покупать дорогую рабочую станцию с профессиональной видеокартой или собирать отдельный сервер с несколькими GPU. В этой статье я хочу показать, как организовать локальную ИИ‑станцию на базе MAIBENBEN X17F с процессором AMD Ryzen 9 8940HX и видеокартой NVIDIA GeForce RTX 5060.
Введение
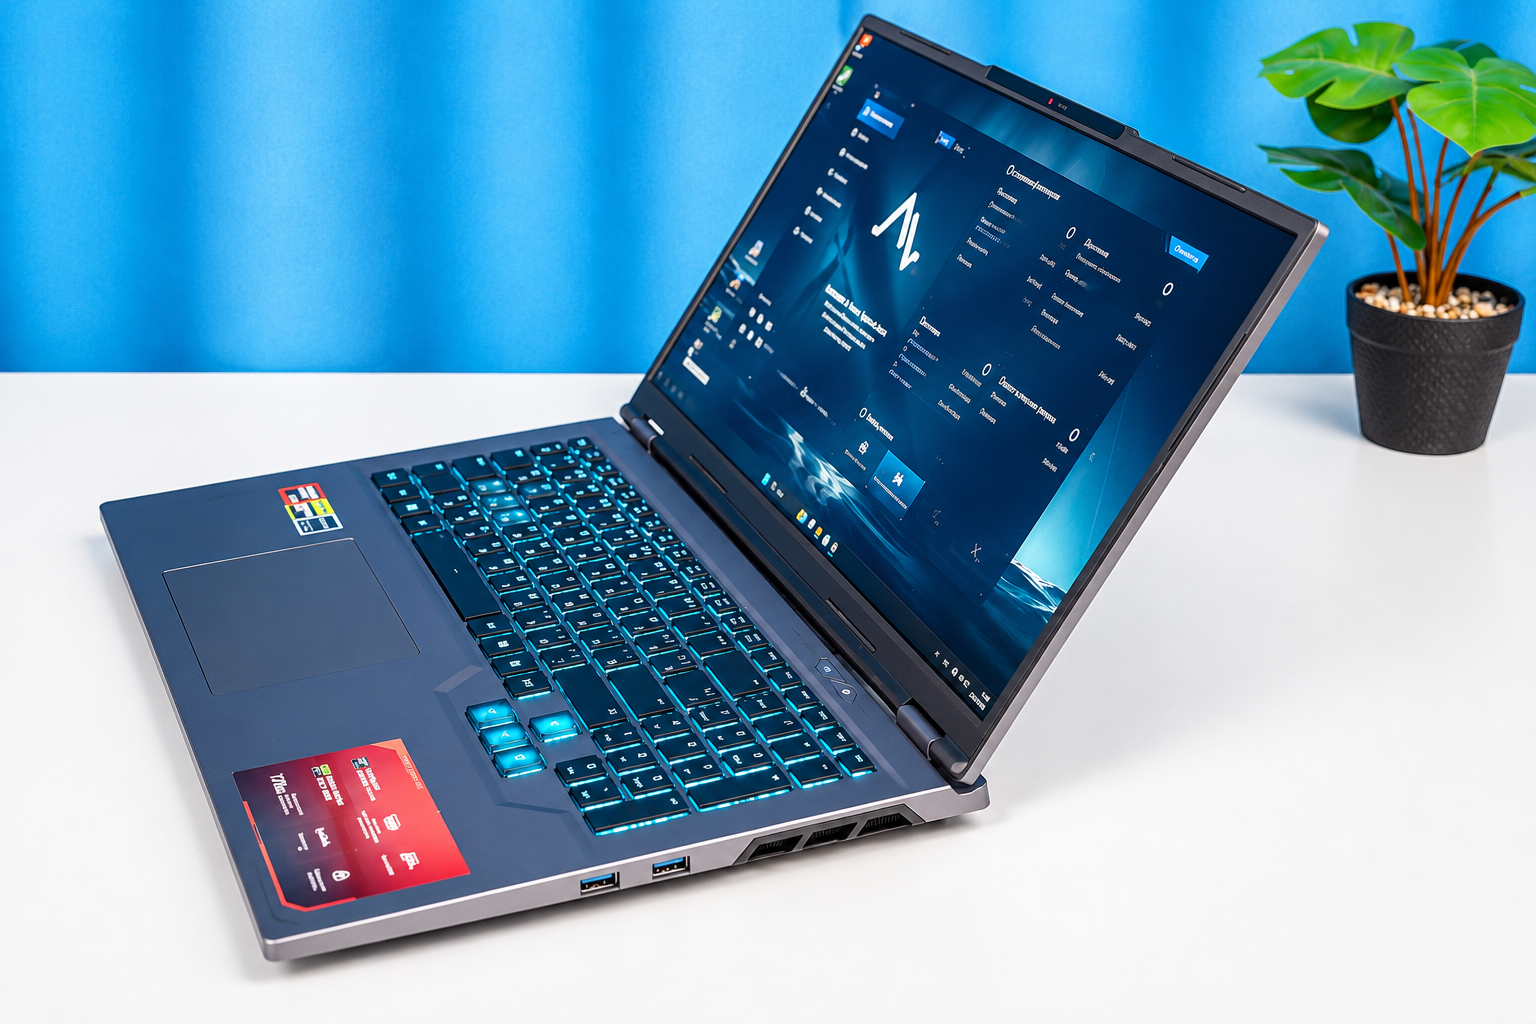
Собственно говоря, на игровом ноутбуке можно не только играть, но и вполне себе настроить связку с локальной LLM. Мне стало интересно, насколько хорошо ноутбук «тянет» модели Qwen3.8-Flash‑Next Coder IQ1_M, DeepSeek‑Coder‑V2-Lite Q2_K (и еще пара для сравнения),и насколько хорош получается сам код. Я прогнал одни и те же задачи через разные модели и два движка, собрал телеметрию раз в секунду (температура, ватты, память, токены) и посчитал два независимых рейтинга. Тестирую вот на таком ноутбуке — MAIBENBEN X17F с процессором AMD Ryzen 9 8940HX и видеокартой NVIDIA GeForce RTX 5060. На борту 24 Гб системной памяти и 8 Гб видеопамяти. Экран 17.3" дюйма, довольно широкий — помещаются два полноценных окна для работы рядом. Для игр и работы с кодом такого экрана вполне достаточно.
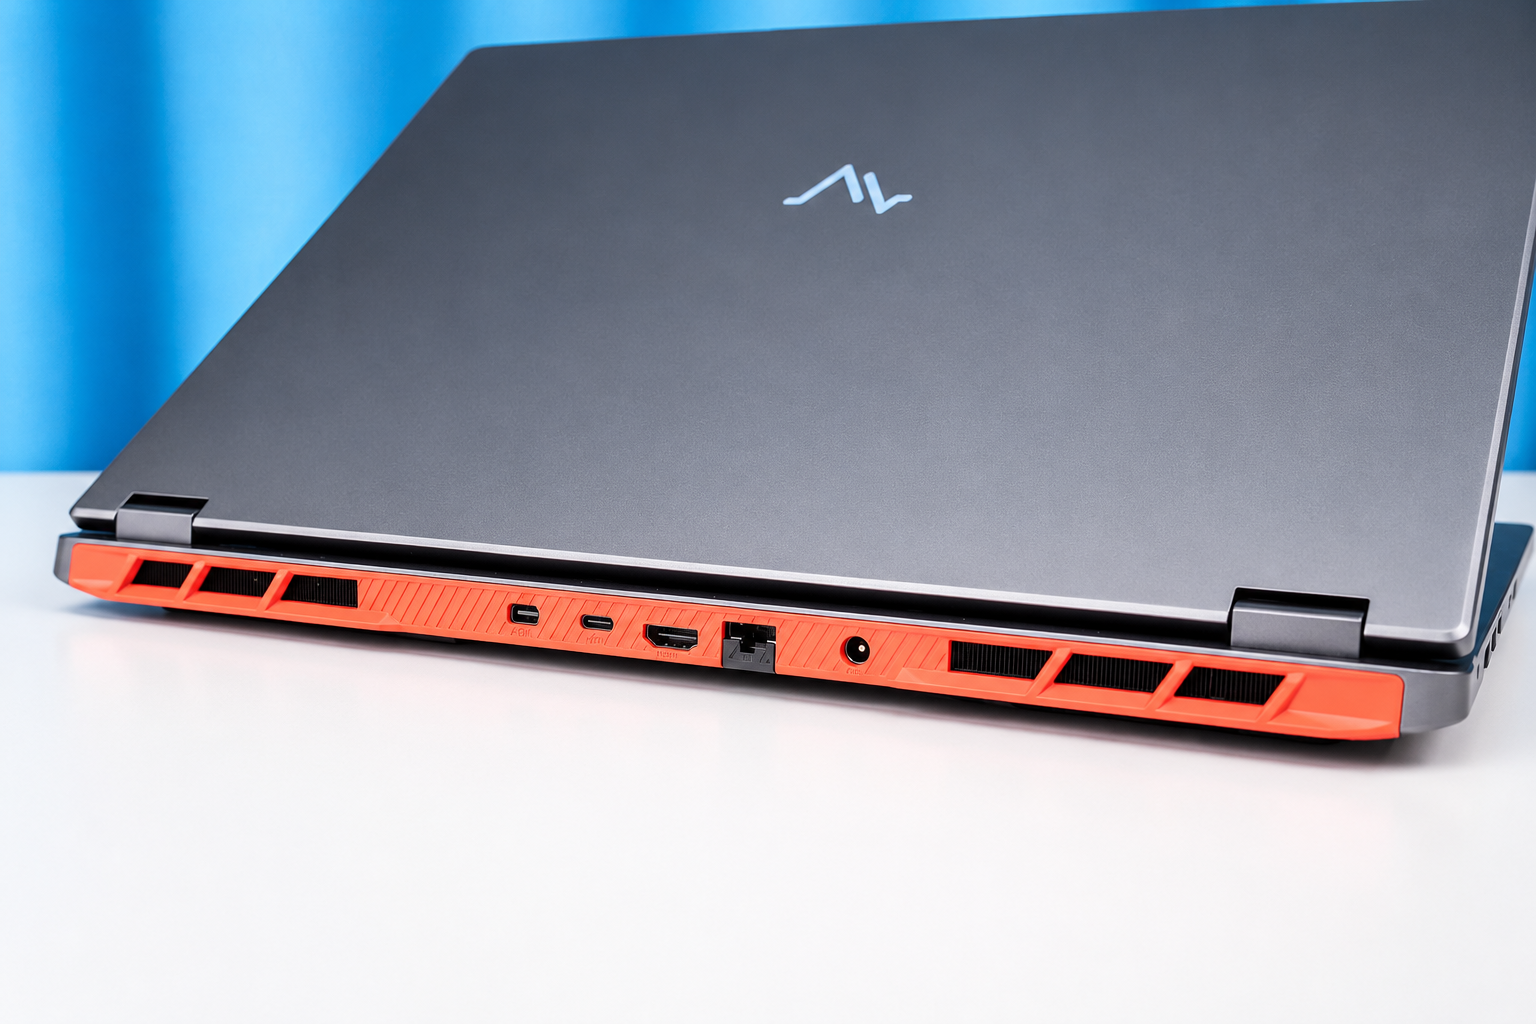
Для удобства работы можно внешнюю USB‑докстанцию или установить для дополнительного охлаждения вентиляторную подставку. Про нагрев и охлаждение этого ноутбука расскажу чуть ниже.
Сразу скажу, что для подобных тестов нужно переводить ноутбук в «турбо», «игровой» или иной «производительный режим», чтобы ноутбук не переключался бы на интегрированный видеочип. В данной модели предусмотрена как отдельная клавиша режимов, так и специальное приложение для выбора профиля производительности.
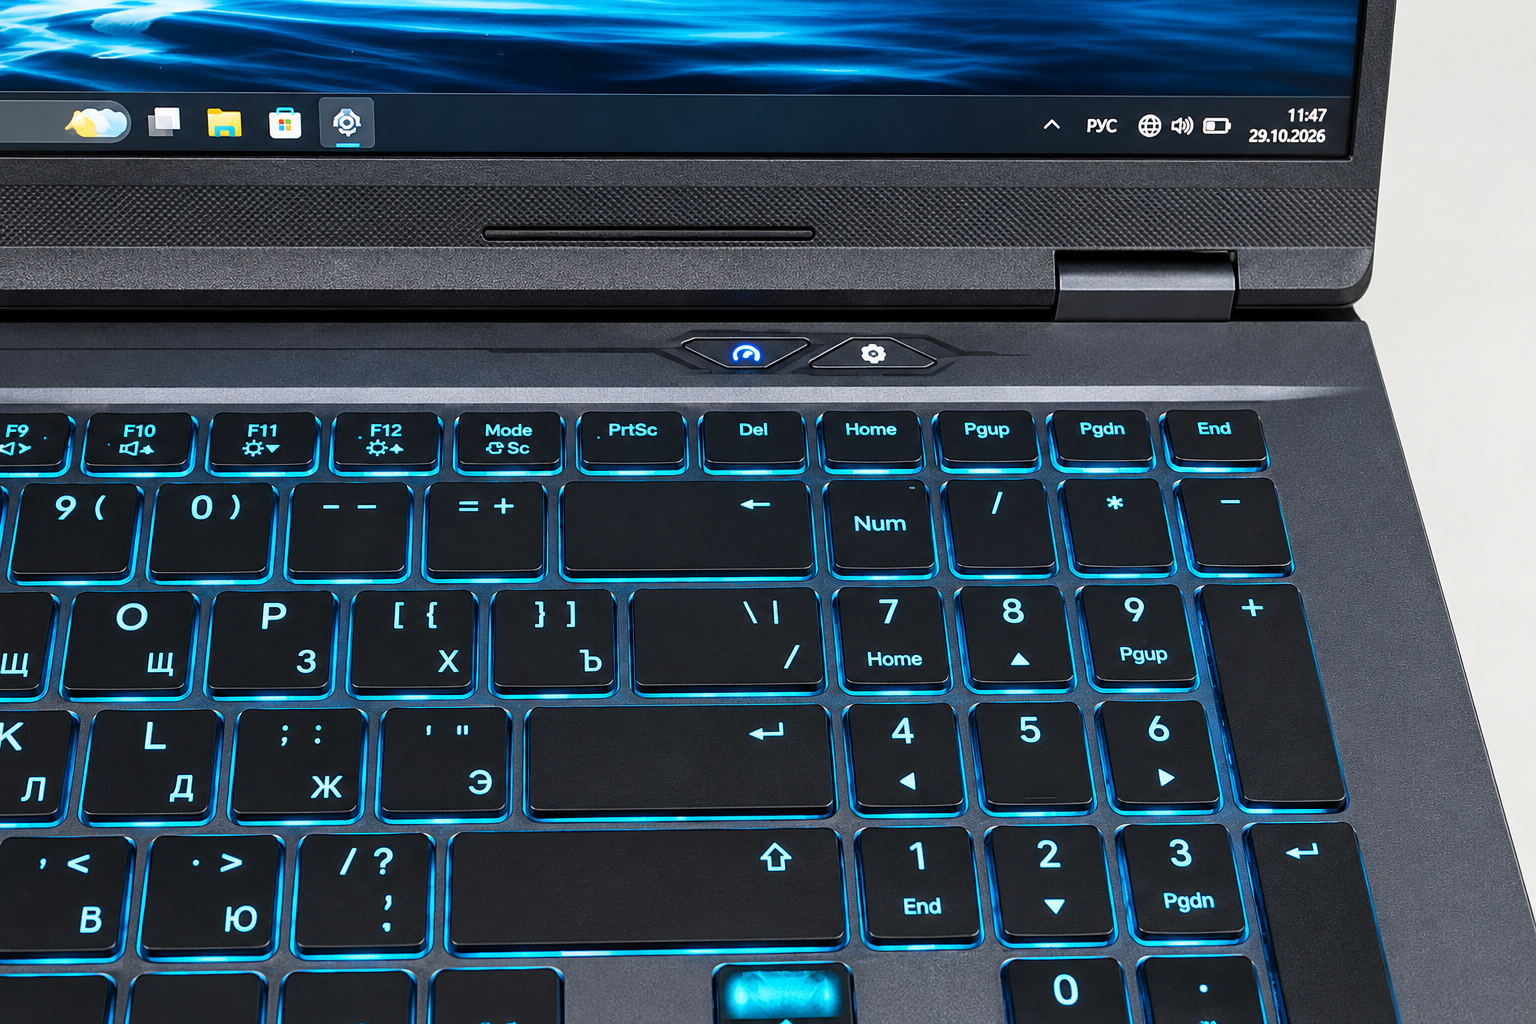
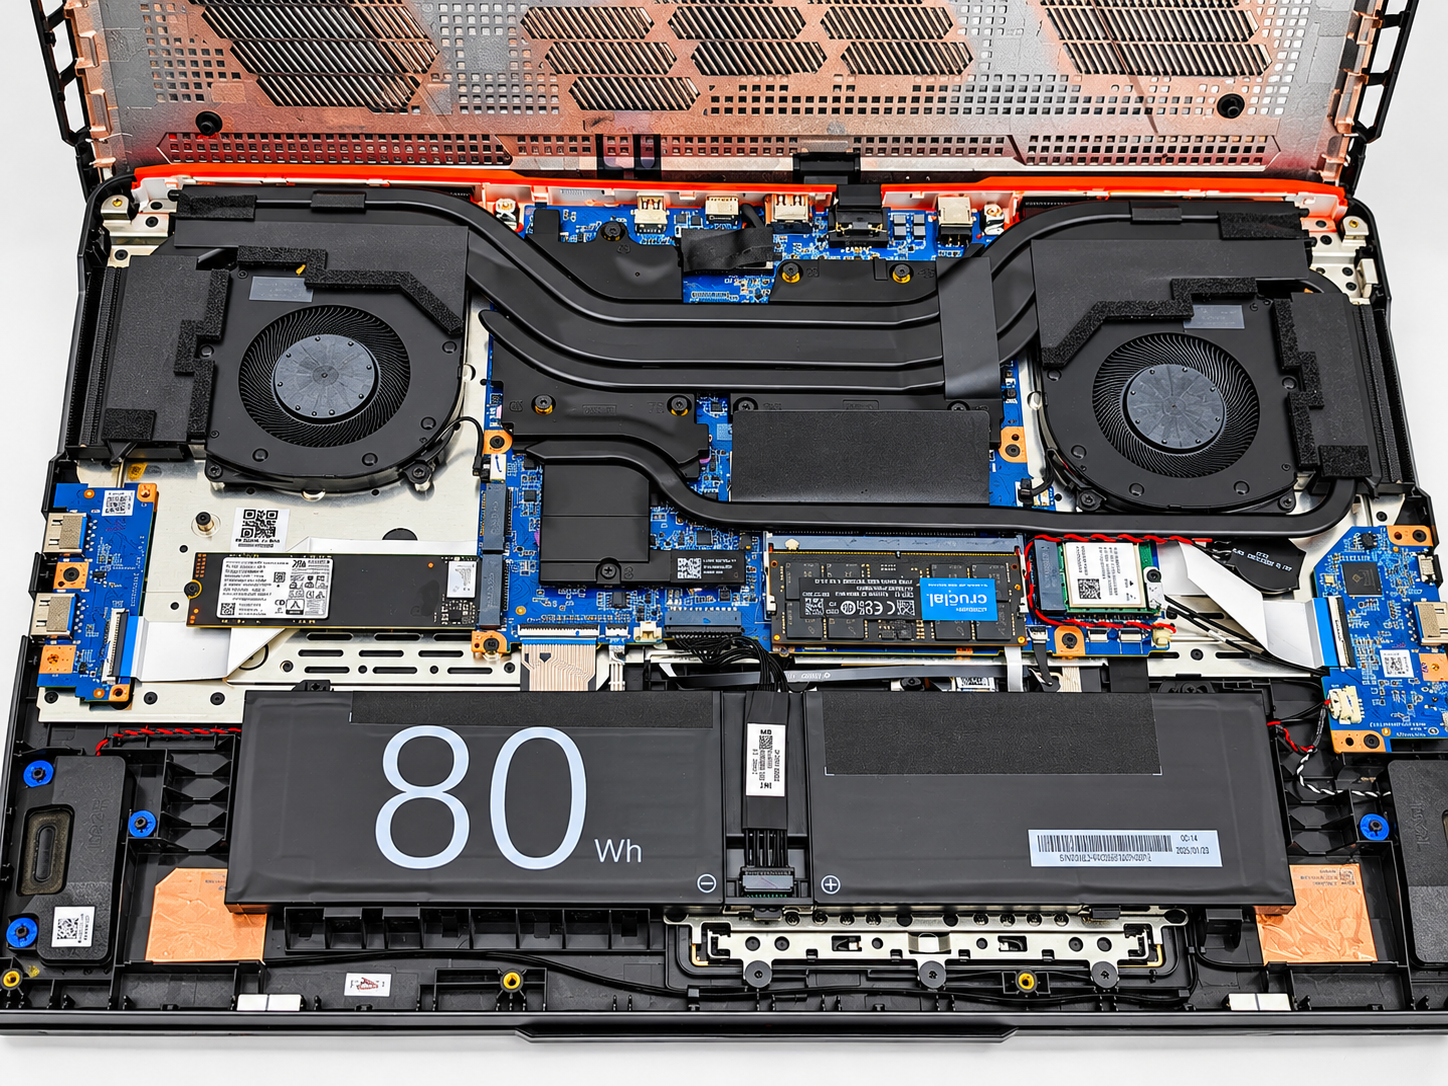
Также забегая вперед скажу, что не зря выбрал именно этот ноутбук — с завода установлен модуль памяти DDR5 на 24 Гб. То есть можно установить дополнительный (второй) модуль на 24 Гб и получить в сумме 48 Гб для запуска средних LLM (в режиме выгрузки из VRAM в системную память). У GeForce RTX 5060 Laptop есть 8 ГБ собственной видеопамяти GDDR7.
Выбранные модели
Современные движки инференса умеют распределять слои модели между GPU и CPU. Часть весов загружается в VRAM, остальная часть размещается в оперативной памяти и обрабатывается процессором. Strata для своей модели требует около 33 ГБ, поэтому я поставил второй модуль ОЗУ и, чтобы сравнение было честным, гонял на 40 ГБ все модели — и в Strata, и в Ollama. Вот такие модели выбрал для теста:
Модель | Движок | Квант / размер | Как легла в 8 ГБ VRAM |
Qwen3.8-Flash‑Next Coder IQ1_M | Strata 0.2.10 (движок 0.1.56, CUDA 13) | IQ1_M, 58,4 ГБ (2 шарда) + MTP 5,2 ГБ | 23,4 ГБ экспертов в ОЗУ, 689 «горячих» экспертов (1,3 ГБ) и KV‑окно 20 480 токенов в VRAM, второй шард читается с SSD |
GPT‑OSS 20B | Ollama 0.40.14 (CUDA) | MXFP4, 13,2 ГБ в памяти | 25/25 слоёв на GPU, но эксперты MoE в ОЗУ: 5,0 ГБ VRAM (38%) |
Qwen3-Coder-30B‑A3B | Ollama 0.40.14 | IQ4_NL (unsloth), 19,6 ГБ | 49/49 слоёв, 5,8 ГБ VRAM (29%) |
DeepSeek‑Coder‑V2-Lite | Ollama 0.40.14 | Q2_K (bartowski), 15,5 ГБ с KV 64K | 16/28 слоёв на GPU, 5,7 ГБ VRAM (37%) |
Общие параметры для всех: температура 0,3, контекст 65 536 токенов, KV‑кэш q8_0 (в Strata — int8), flash attention, рассуждения выключены (у GPT‑OSS — минимальный уровень low), одна модель в памяти, один запрос за раз.
Методика: стенд «Hard Code»
Стенд полностью автоматический: создание кода на полифонический DSP‑синтезатор на C++20, распределённое хранилище на Raft и аудит чужого многомодульного проекта (Legacy Audit). Модель получает ТЗ, отвечает файлами в формате «### FILE: путь + блок кода», скрипт раскладывает их, собирает проект и прогоняет скрытые тесты, которых модель не видит. Код за модель никто не правит, то есть в реальной жизни я такой отправляю на доработку, пока код не станет «красивым», а в данном случае ошибки компиляции и провалы тестов возвращаются модели — до 3 раундов исправления сборки и 1 раунд по тестам. Какие задачи поставил:
Тест | Что проверяет | Независимая проверка |
1. DSP‑синтезатор (C++20) | 16-голосый синтезатор: wavetable‑генераторы с антиалиасингом, ADSR, State Variable Filter, LFO, voice stealing, scalar + AVX2, без аллокаций в processBlock | 15 скрытых тестов: частота по DFT, огибающая, устойчивость фильтра, совпадение scalar/AVX2, ASan/UBSan |
2. Raft KV (Rust) | Кластер из 3 процессов по TCP: выборы, репликация, коммит, редиректы, восстановление, симулятор отказов | 18 проверок живого кластера: убийство лидера, догон, partition |
3. Legacy Audit (C++) | Проект PLC-200(28 файлов, ~17 тыс. токенов, 37 заложенных дефектов): анализ, классификация, рефакторинг, тесты, отчёт | 34 проверки под ASan+UBSan, каждая в отдельном процессе с таймаутом 30 с |
Третий тест я сделал самым длинным: к шести штатным этапам (архитектура → поиск дефектов → рефакторинг с исправлениями → свои тесты → отчёт) добавлены этап 7 — новая сессия, где модель получает только файл состояния проекта и должна продолжить работу, и этап 8 — повторный аудит. Параллельно снималась телеметрия работы ноутбука: мощность и температура CPU (LibreHardwareMonitor), мощность, температура, частота и загрузка GPU (nvidia‑smi), ОЗУ, VRAM, общая память GPU, файл подкачки, диск. Отдельно — замеры скорости: холодный и тёплый старт, короткие, средние запросы и длинная генерация на 10 500 токенов.
Проблемы методики, с которыми столкнулся
Длинный контекст
Сразу скажу, что даже такие задачи оказались сложноваты. И разбор логов показал, что виноват не только размер моделей (выбирал впритык под железо), но и сам способ испытания: модель тонет в собственной истории контекста. Для результативности пришлось дробить контекст на шаги. Да и есть нюансы с исправлениями — перестал отправлять LLM всю историю контекста при запросе на корректировку. Пришлось часть тестов прогонять заново.
Strata в песочнице и лимит пути 260 символов
Strata ставится одной командой PowerShell в%LOCALAPPDATA%. Но я запускал всё из Claude Desktop, а MSIX‑приложения Windows перенаправляют AppData\Local в свой каталог Packages\…\LocalCache. Путь вырос настолько, что распаковка исходников llama.cpp (их Strata использует для подготовки модели) упала на MAX_PATH. Лечение — перенести всё в C:\Strata и запускать Strata с LOCALAPPDATA=C:\. К слову, нужно скачать самой Strata 58 ГБ и модели Qwen3.8-Flash‑Next Coder IQ1_M.
Лимит выделения памяти Windows
Со стандартным файлом подкачки (2,5 ГБ) лимит commit был 43,9 ГБ, и Strata сразу предупредила: свободно 0,4 ГБ, сервер может молча упасть с кодом 0xC0000409. Она сама отключила кэш диалогов и чтение промпта силами CPU. После перехода на фиксированные 16 ГБ подкачки (лимит 55,2 ГБ, свободно ~11 ГБ) режимы включились. Но, фактически подкачка почти не использовалась — пик 0,4 ГБ.
Падение движка на длинных промптах
Первый прогон Strata провалился: короткие запросы шли на 42 ток/с, но любой промпт длиннее одного куска чтения (~2 тыс. токенов) ронял движок. У Coder‑версии 256 экспертов из 512 исходных, а «послойный» путь чтения промпта для карт с маленьким кэшем экспертов обращался к экспертам с номером 256 и выше. Штатный выключатель STRATA_PREFILL_LAYER_MAJOR=0 решил проблему: промпт в 18 068 токенов читается за 24,6 с (735 ток/с), причём и с CPU‑помощью, и без неё. Остальное — по умолчанию.
Windows Smart App Control
Самое коварное. Включённый Smart App Control случайным образом блокировал загрузку официальной libLLVM‑…dll у rustc и запуск свежесобранных тестовых.exe (WinError 4551 «Политика управления приложениями заблокировала этот файл»). Модель при этом получала «ошибку сборки», которой не было в её коде. Три прогона (Raft и Legacy у GPT‑OSS, Legacy у Qwen) пришлось выбросить и перезапустить, добавив в стенд повтор с паузой и журнал блокировок. Во время перезапусков блокировок больше не было. Мораль: если бенчмарк компилирует и запускает код на Windows 11 — проверяйте журнал Microsoft‑Windows‑CodeIntegrity/Operational.
Производительность железа
Strata выдаёт 41,0 ток/с на коротких запросах и 39,6 ток/с на длинной генерации — и это модель, которая в 4 раза больше любой из соперниц. Секрет в трёх вещах: эксперты, к которым модель обращается чаще всего, заранее положены в VRAM (около 46% обращений к экспертам обслуживает GPU), промахи считают 15 потоков CPU, а MTP‑драфтер угадывает до 4 токенов вперёд.
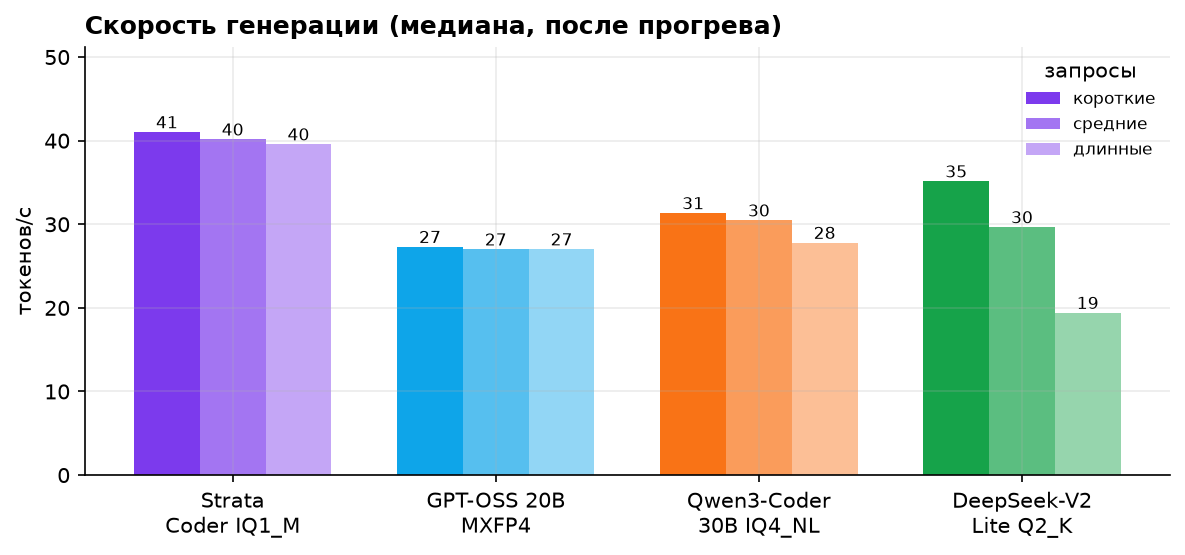
Когда модель переписывает уже существующий код (раунды исправлений), угадывание срабатывает чаще, и скорость доходила до 75–83 ток/с.
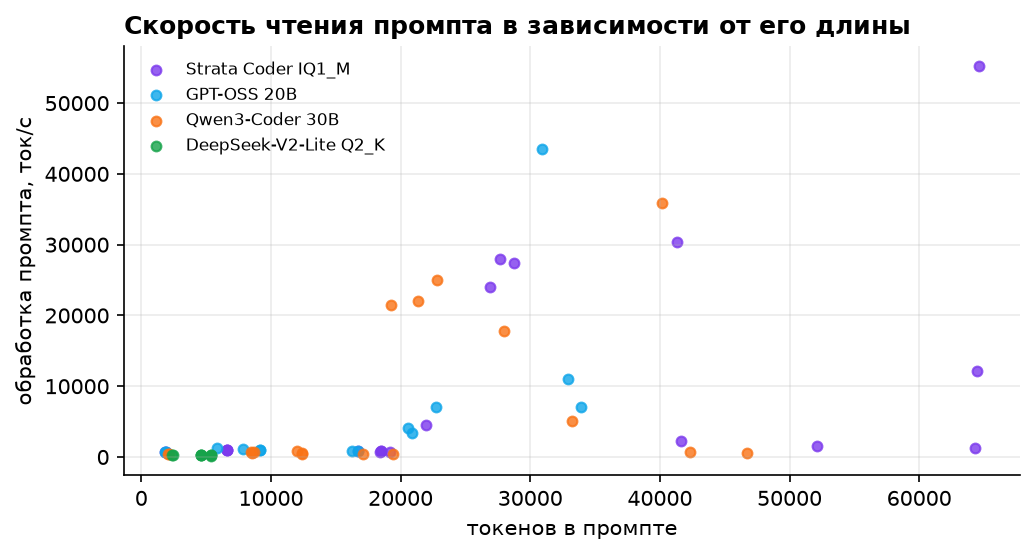
Чтение длинных промптов
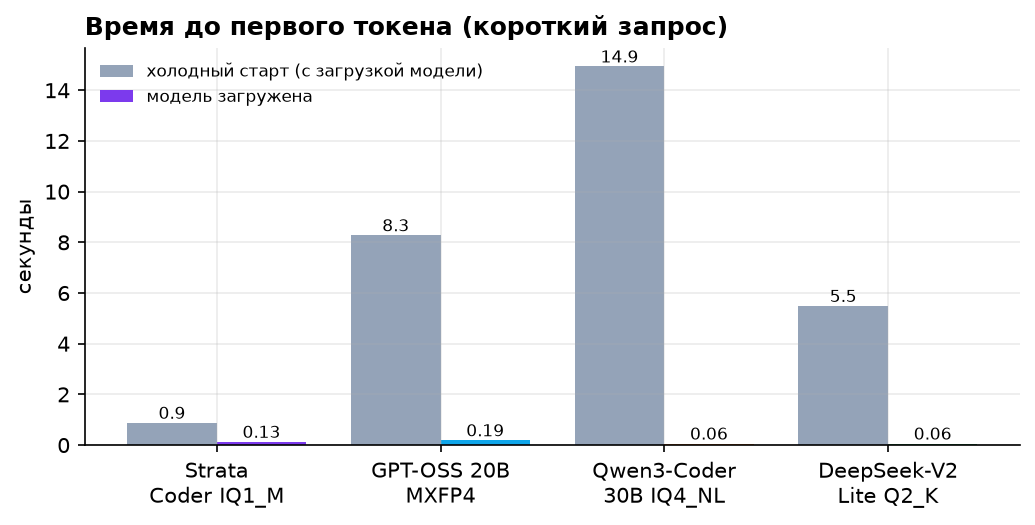
Здесь главный разрыв с мини‑ПК на Intel Arc, где тот же стенд читал промпт со скоростью ~60 ток/с и тратил 5–6 минут на старт теста 3. На RTX медианы — 1116 ток/с у Strata, 1179 у GPT‑OSS, 645 у Qwen3-Coder. Исключение — DeepSeek‑Coder‑V2-Lite: KV‑кэш на 64K контекста у него в Ollama настолько большой (15,5 ГБ всего при 6,4 ГБ весов), что в видеокарту поместилось только 16 из 28 слоёв, и промпт теста 3 на 21 тыс. токенов он читал 610 секунд (34,5 ток/с) — на 10 секунд дольше таймаута стенда.
Входящие и исходящие токены
Legacy Audit у Strata — это почти полмиллиона токенов на входе: восемь этапов, каждый из которых несёт весь проект и историю. Именно на таком объёме проявляется разница в скорости чтения промпта.
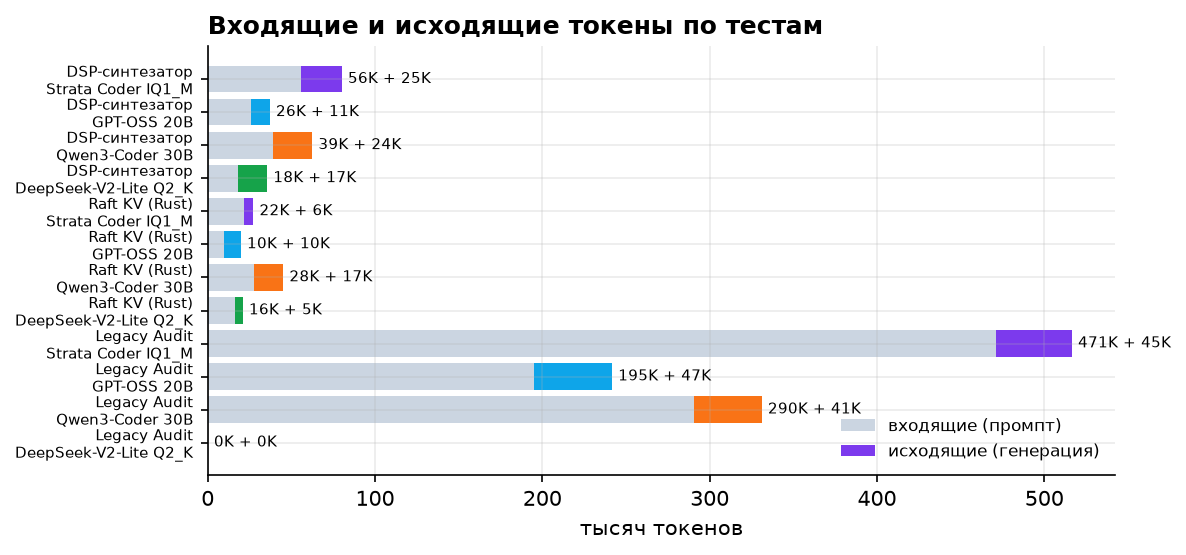
Модель | Прочитано | Написано | Чистое время генерации |
Qwen3.8-Flash‑Next Coder IQ1_M (Strata) | 548 414 | 75 331 | 29 мин |
GPT‑OSS 20B MXFP4 | 230 721 | 67 758 | 47 мин |
Qwen3-Coder-30B‑A3B IQ4_NL | 357 029 | 81 612 | 73 мин |
DeepSeek‑Coder‑V2-Lite Q2_K | 34 530 | 21 890 | 41 мин |
Потребление памяти
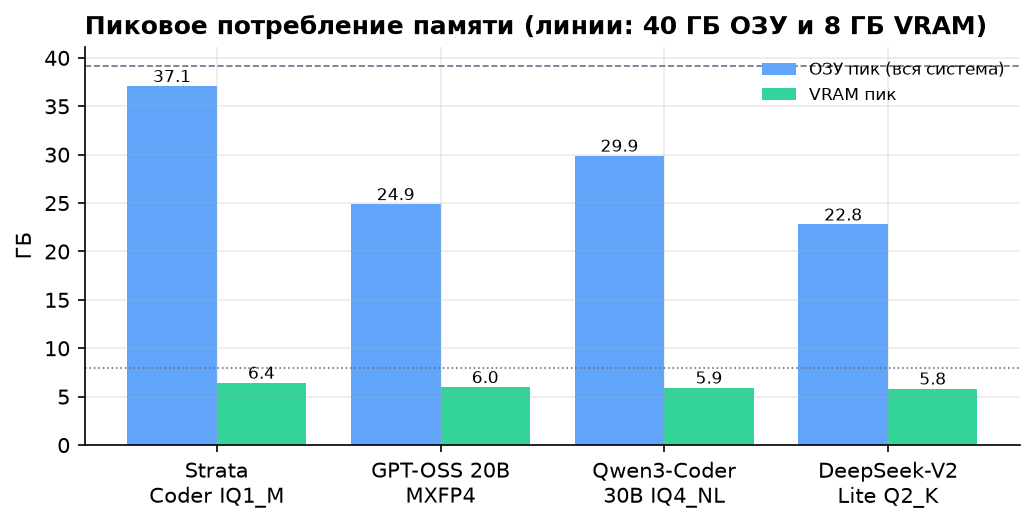
Strata держит в ОЗУ 23,4 ГБ экспертов и забирает систему почти целиком — пик 37,1 ГБ из 39,2. На 24-гигабайтной конфигурации ноутбука эта модель не запустилась бы вовсе. Модели Ollama укладываются в 23–31 ГБ с учётом Windows и браузера.
Диспетчер задач во время работы Strata: занято 36,8 из 39,2 ГБ (94%).
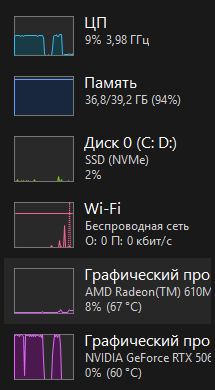
Загрузка GPU и CPU
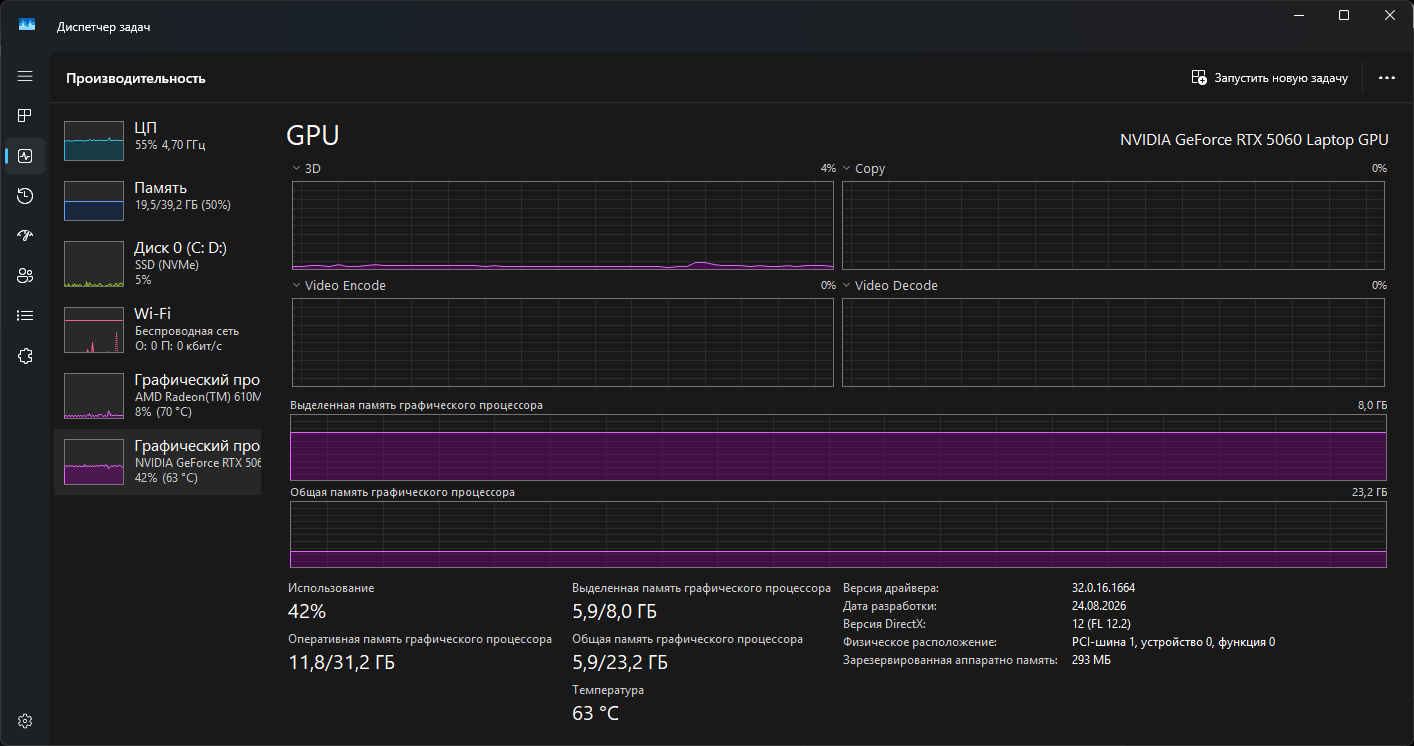
Пример загрузки GPT‑OSS 20B в Ollama: 5,9 из 8 ГБ VRAM, ещё 5,9 ГБ в общей памяти GPU, загрузка 42%.
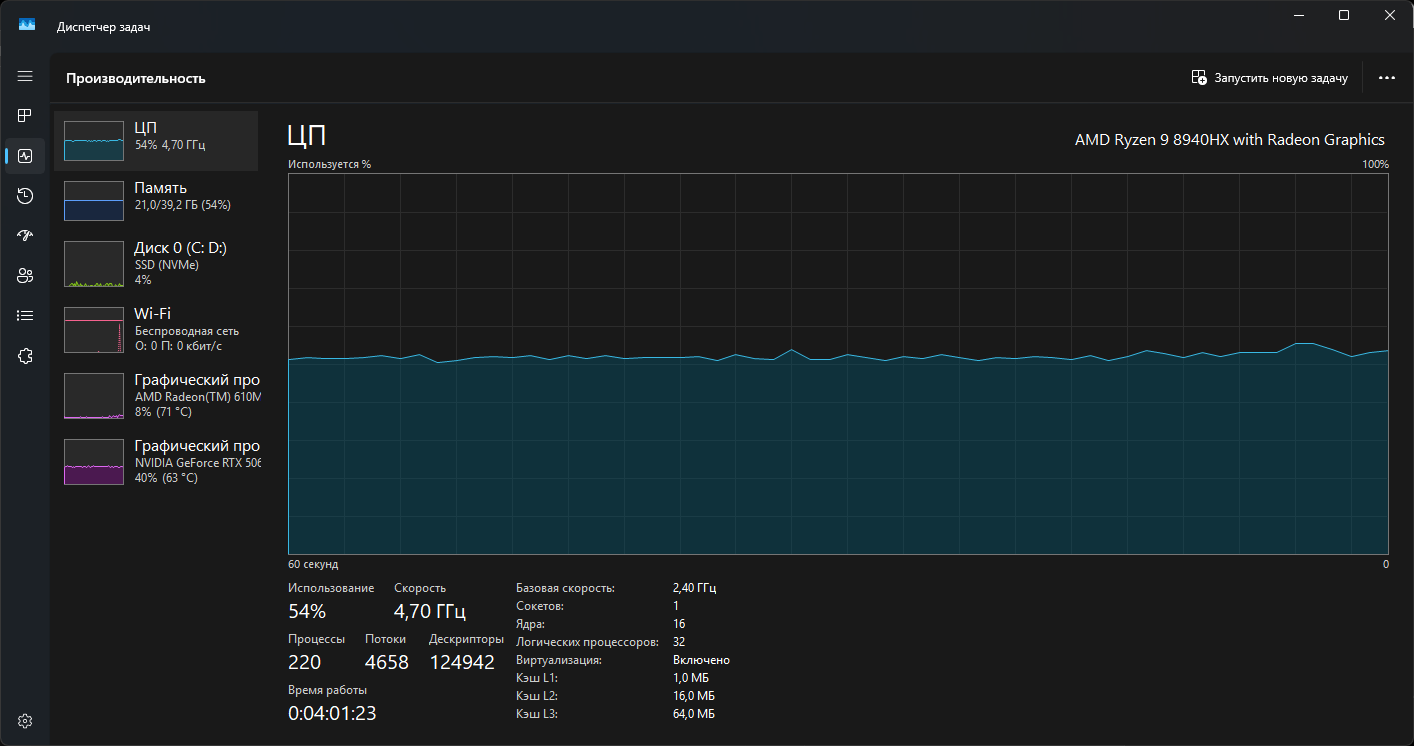
Тот же момент: CPU загружен на 54% — это все 16 физических ядер на 4,7 ГГц.
Средняя загрузка GPU во время генерации: Strata — 99%, GPT‑OSS — 34%, Qwen3-Coder — 46%, DeepSeek — 38%. Ollama делит MoE‑модель так, что внимание считает видеокарта, а эксперты — процессор, и видеокарта большую часть времени ждёт. Strata устроена наоборот: видеокарта остаётся главным вычислителем, а CPU досчитывает промахи кэша экспертов.
Нагрев и потребление
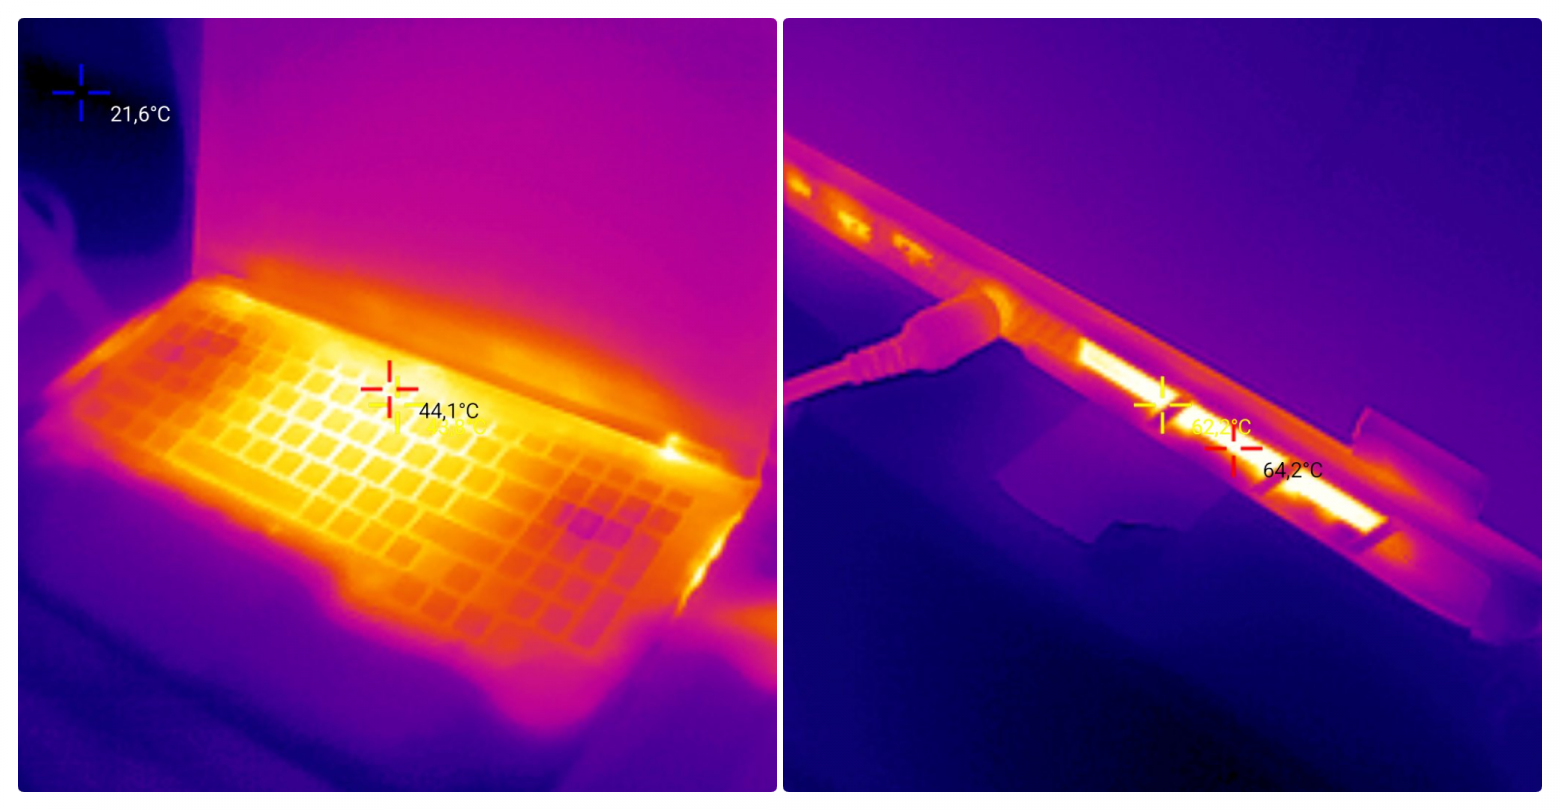
При запуске LLM можно получить одновременный нагрев и CPU, и GPU. Я бы рекомендовал использовать ноутбук на твердой поверхности, не перекрывать нижние воздухозаборники.
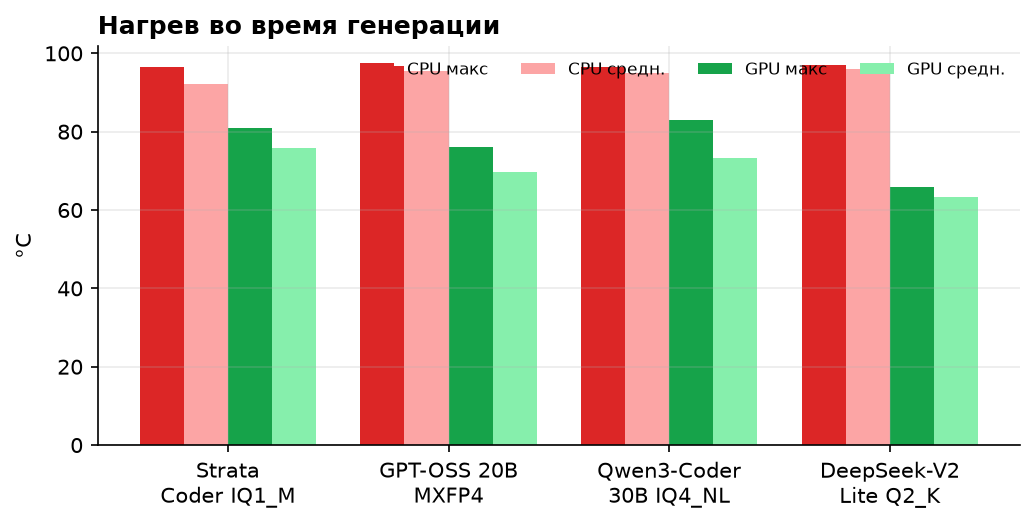
Прикладываю данные по средней и максимальной температуры во время генерации.
И данные по средней мощности потребления во время генерации.
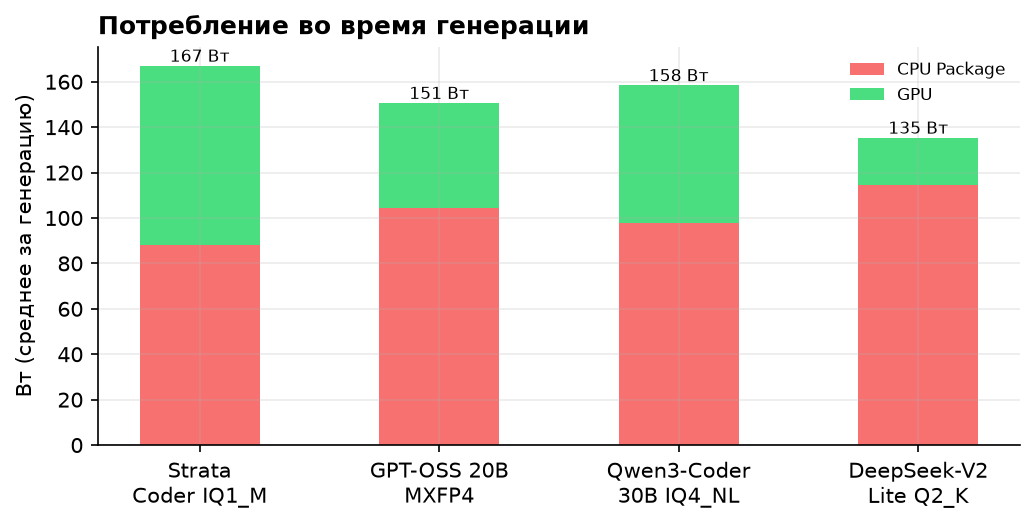
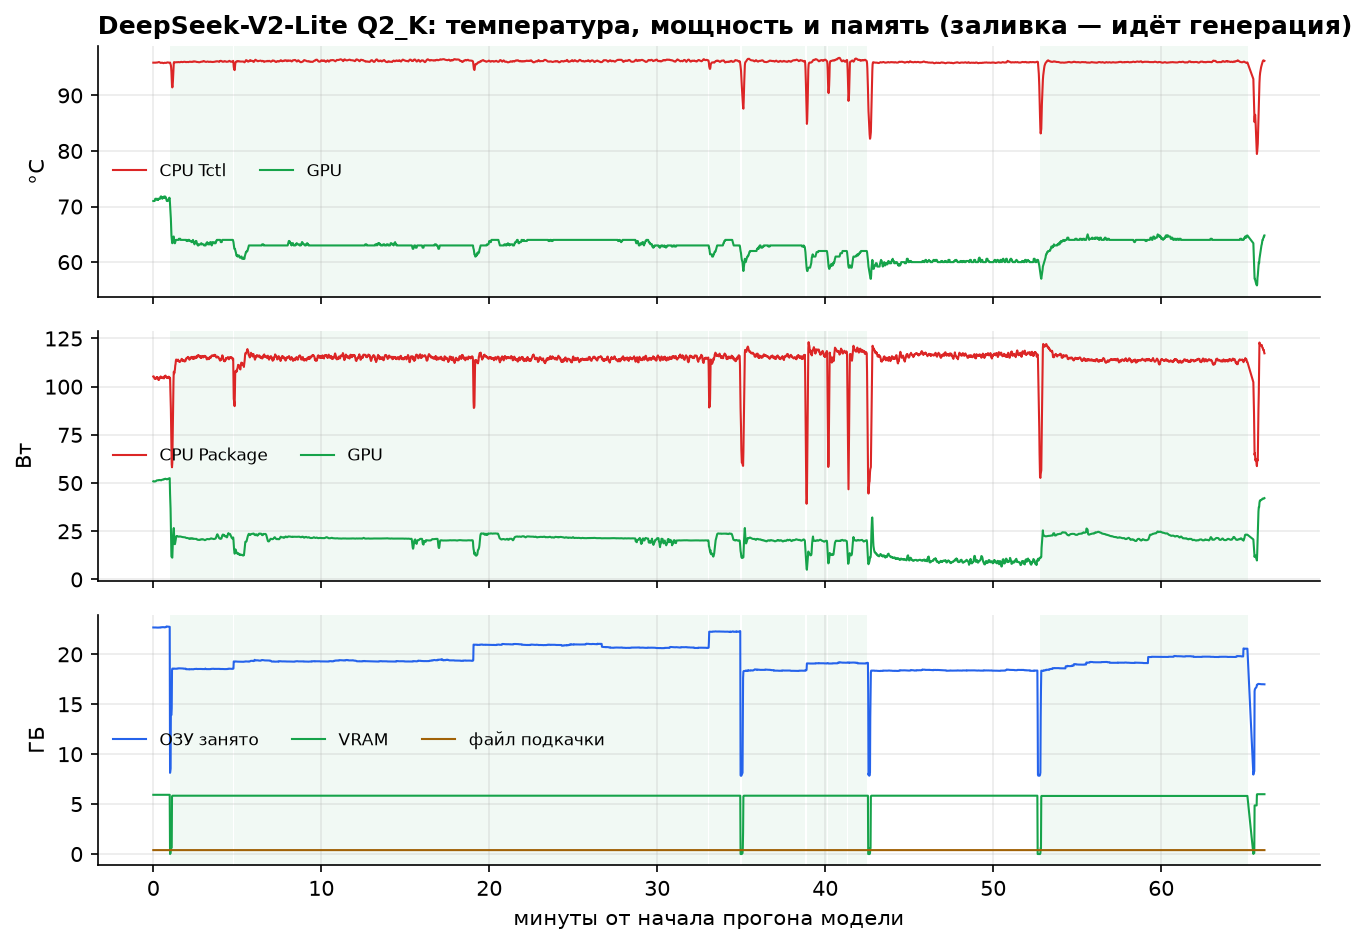
CPU во всех режимах сидит работает на максимуме, есть небольшой запас по температуре. Разница в том, куда уходит энергия: у Strata 79 Вт берёт видеокарта и 88 Вт процессор (всего ~167 Вт), у DeepSeek — 114 Вт CPU и только 21 Вт GPU. В пересчёте на токен (средняя мощность / медианная скорость): Qwen3.8-Flash‑Next Coder IQ1_M — 4,1 Дж, GPT‑OSS 20B MXFP4 — 5,6 Дж, Qwen3-Coder-30B‑A3B IQ4_NL — 5,1 Дж, DeepSeek‑Coder‑V2-Lite Q2_K — 4,1 Дж. Strata и DeepSeek самые экономные, но DeepSeek теряет скорость на длинном контексте. График для Strata.
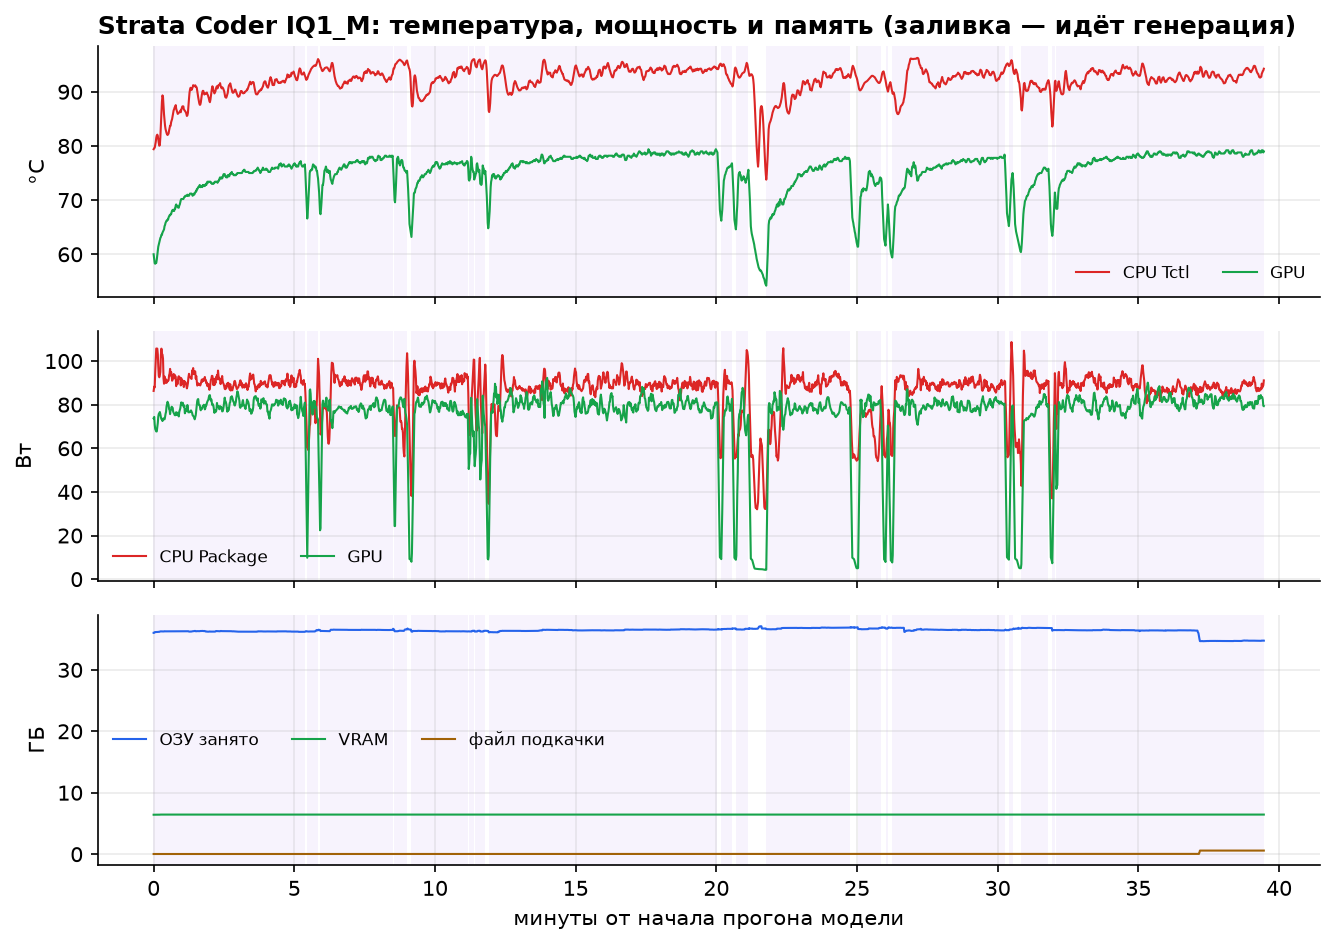
График для GPT‑OSS 20B.
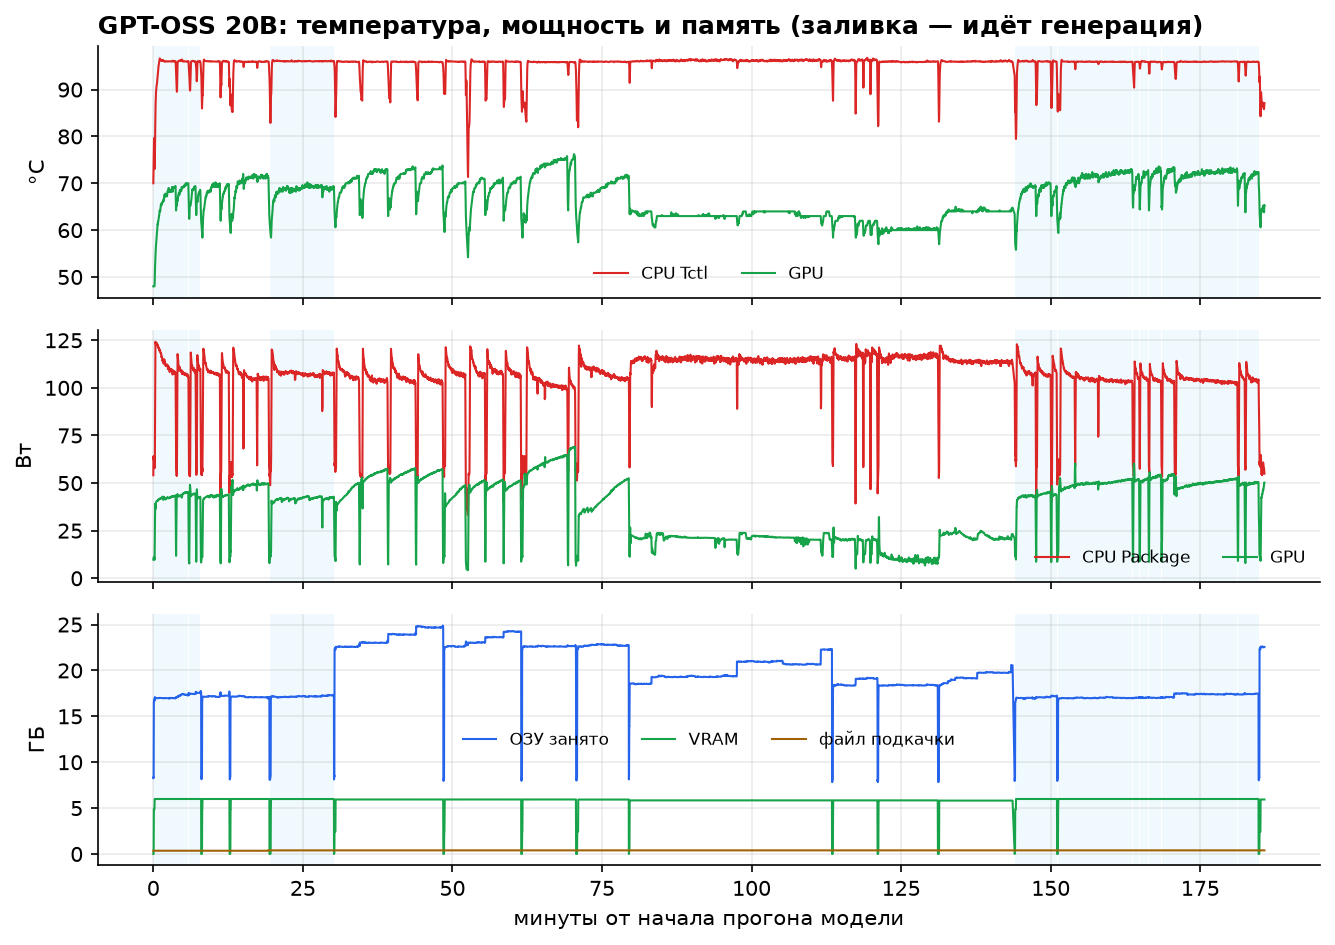
График для Qwen3-Coder-30B‑A3B.
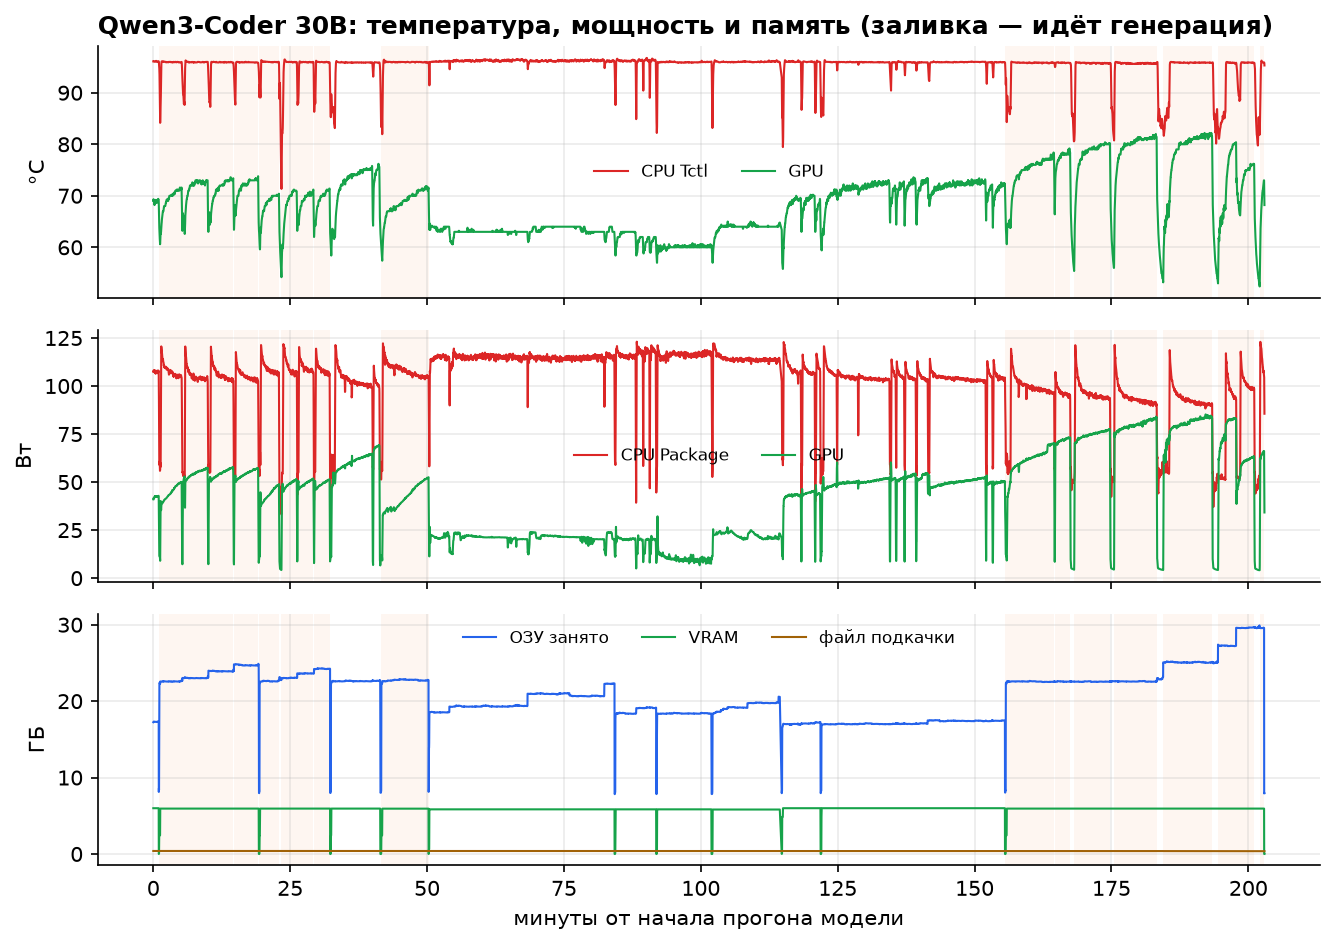
График для DeepSeek‑Coder‑V2-Lite.
Рейтинг производительности железа
Формула оценки производительности железа: скорость 30%, время до первого токена 10%, пиковая память 20%, стабильность 20%, эффективность GPU 20%. Каждая составляющая нормирована на лучшую модель (100 баллов). Память — прирост ОЗУ к простою плюс подкачка (меньше — лучше). Стабильность — доля успешных запросов × (1 − падение скорости) с учётом того, дотянула ли длинная генерация до 10 тыс. токенов. GPU — 50% доля вычислений на GPU (для Ollama — доля модели в VRAM по ollama ps, для Strata — доля экспертов, посчитанных на GPU, из лога движка; оценка приблизительная) + 50% средняя загрузка GPU.
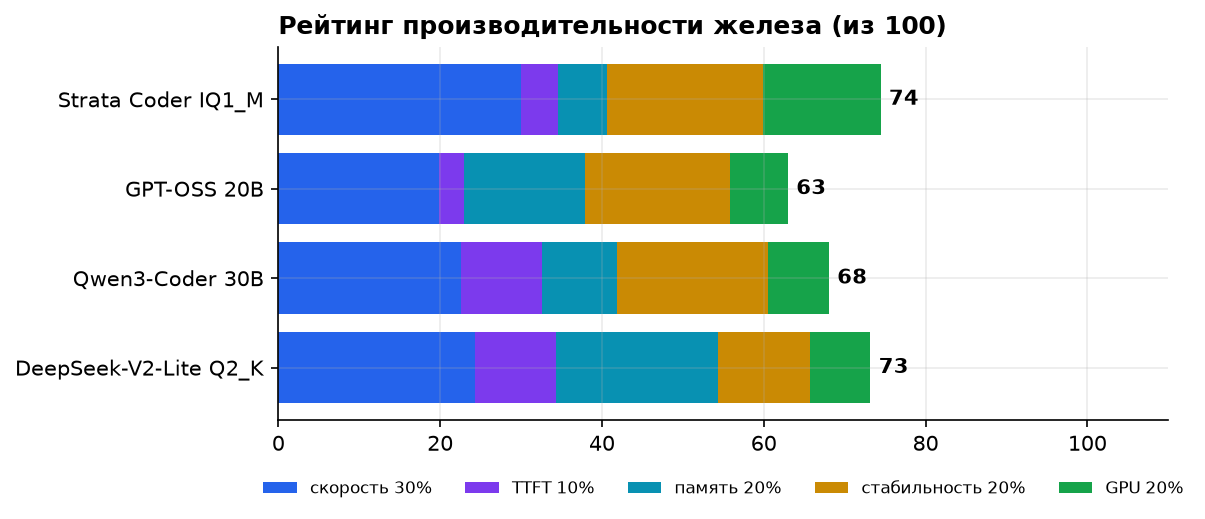
Модель | Скорость | TTFT | Память | Стабильность | GPU | Итог |
Qwen3.8-Flash‑Next Coder IQ1_M (Strata) | 100 | 46 | 30 | 97 | 72 | 74,4 |
GPT‑OSS 20B MXFP4 | 66 | 32 | 75 | 89 | 36 | 63,0 |
Qwen3-Coder-30B‑A3B IQ4_NL | 75 | 100 | 47 | 93 | 38 | 68,0 |
DeepSeek‑Coder‑V2-Lite Q2_K | 81 | 100 | 100 | 57 | 37 | 73,2 |
DeepSeek на втором месте только за счёт маленького квантования (мало памяти) и быстрого старта — его стабильность на длинном контексте худшая из всех. Strata проигрывает только по памяти и выигрывает всё остальное.
Результаты тестов
Методика оценки результата такая: компилируемость кода 20%, скрытые тесты 30%, архитектура 20% (экспертно), исправление ошибок 15%, безопасность 10%, документация 5%. Компилируемость — среднее по трём шагам.
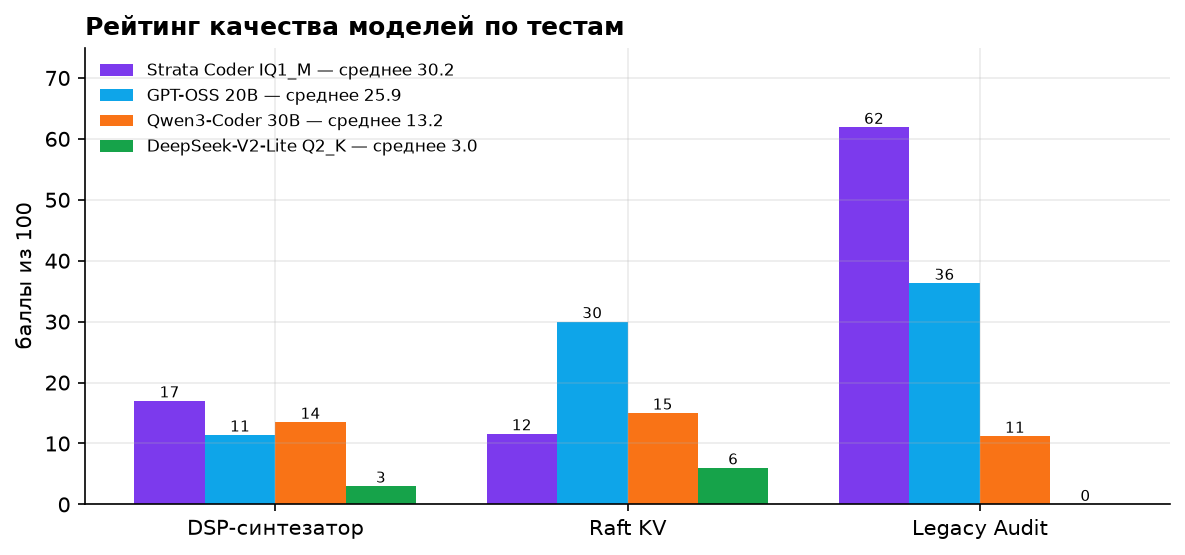
Модель | DSP | Raft | Legacy Audit | Среднее |
Strata Coder IQ1_M | 17,0 | 11,6 | 61,9 | 30,2 |
GPT‑OSS 20B | 11,4 | 30,0 | 36,3 | 25,9 |
Qwen3-Coder 30B | 13,5 | 15,0 | 11,2 | 13,2 |
DeepSeek‑V2-Lite Q2_K | 3,0 | 6,0 | Провал на контексте | 3,0 |
Контекст и стоимость
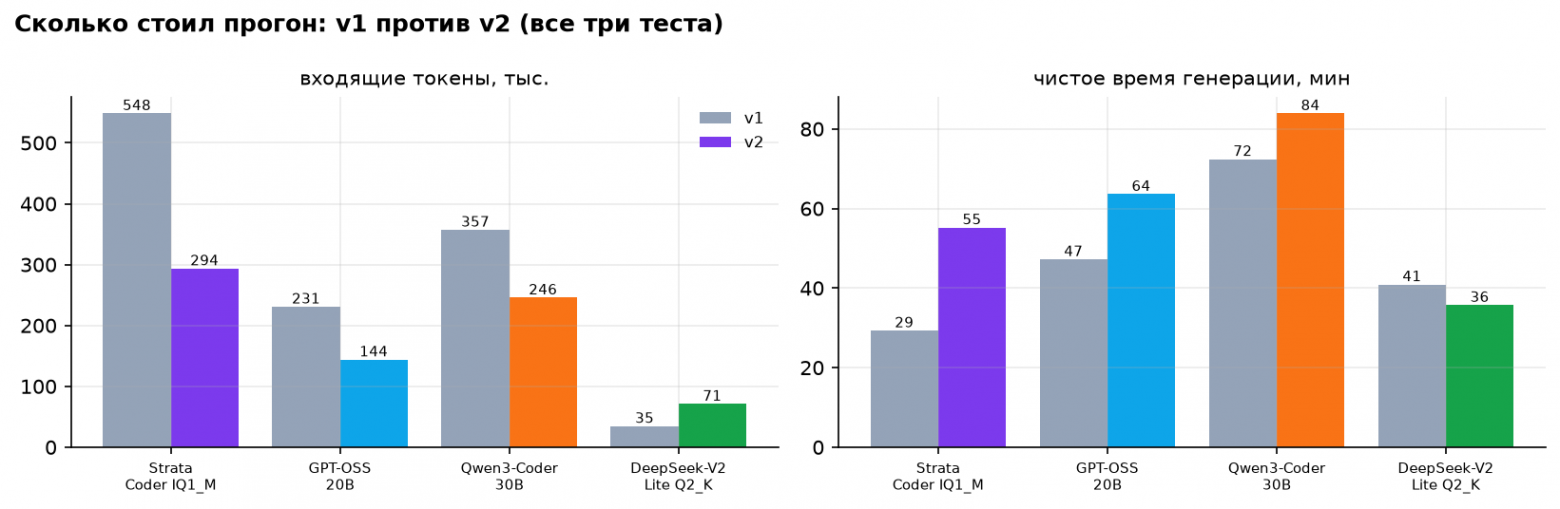
Тесты запускал в два приема (v1 — первый раз все ТЗ одним сообщением, далее весь контекст нарастает при доработках, v2 — уменьшил контекст, разделил задачи, при доработках отправляю часть истории, а не всю переписку). Короткий контекст дешевле по входу, но в итоге делается больше запросов для уточнений: каждый шаг — новый ответ, а каждая группа legacy — свой рефакторинг. Исходящих токенов стало в 1,4–2,2 раза больше (кроме DeepSeek), и время генерации у быстрых моделей выросло. Зато промпт больше не упирается в окно 64K: максимум у Strata — 22,5 тыс. токенов вместо 64,6 тыс. Интересный опыт, особенно можно проследить это по измерениям контекста в Strata.
Наблюдения о моделях
Strata выдумывает пакеты. Даже когда сводка cargo прямо перечисляет доступные фичи, модель вписывает несуществующие (
stdу bincode,env-logу tracing‑subscriber). Похоже на цену квантования IQ1_M: знания о конкретных API «размыты», общая архитектура — нет (её Raft в v2 вырос с 441 до 1 179 строк, с выборами и репликацией).GPT‑OSS любит короткий контекст. В v1 он зацикливался в длинной истории и к концу превращал проект в заглушки; в v2 синтезатор — 880 строк с AVX2 и атомарными параметрами, а Raft впервые собрался.
DeepSeek‑Coder‑V2-Lite Q2_K в v2 на шаге A Raft не вернул ни одного файла в нужном формате, по 28 строк кода на весь Raft и снова не дочитал 21-тысячный промпт Legacy за 10 минут. Требует наибольшего внимания при настройке и подготовке ТЗ. Я бы еще рекомендовал параллельно задавать аудит для DeepSeek другой, более легковесной моделью.
Выводы
Короткий контекст и поэтапная сборка имеют и плюсы и минусы — можно поймать зацикливание, раздувается количество уточняющих вопросов.
Для кода «с нуля» на 8 ГБ VRAM поэтапный режим полезен; для аудита и рефакторинга существующего проекта модели нужен весь проект перед глазами. Это оказалось важным.
Вопрос | Ответ |
Лучшая модель по качеству на основе тестов | Strata Coder IQ1_M — 30,2 (на длинном контексте 28,2) |
Самый заметный выигрыш от короткого контекста | GPT‑OSS 20B: увеличение результативности с 11,0 до 25,9 |
Кому v2 навредил | Qwen3-Coder 30B: 23,6 → 13,2 (Legacy Audit по группам) |
Самый сложный тест Аудит Legacy за всё время тестов | Strata, 21/34 на длинном контексте и 33/34 на коротком контексте |
Первая собранная Raft‑сборка | GPT‑OSS 20B |
Итак, вот такой ноутбук RTX 5060 Laptop — это вполне рабочий вариант для локального вайбкодинга. По сути 8 ГБ хватает, чтобы движок (например, Strata) смог удержать горячих экспертов MoE в VRAM. Ollama с частичной выгрузкой оставляет видеокарту недогруженной и упирает всё в CPU, но работает. Если говорить про именно сам код, то для идеала не хватило нескольких шагов (в тесте по 3 шага на исправление, по хорошему, нужно дать модели больше шагов для исправления). Желательно добавить памяти для стоковой конфигурации — Strata Coder IQ1_M во время теста занимала 37 ГБ. Ноутбук вполне справляется с нагрузкой, но для многочасовых сессий я бы посоветовал дополнительно использовать подставку с охлаждением. В любом случае, это достаточно интересный опыт, который показывает, что вполне можно настроить рабочую вайбкодинг‑связку для локальной генерации (не только кода — можно и 3D модели генерировать в несколько подходов).


Комментарии 0