Корутины появились в C++ в 2020 году и постепенно становятся привычным инструментом для асинхронного кода — с ними асинхронная логика читается почти как обычная последовательная. Однако у удобства есть цена: в общем случае компилятор выделяет для каждой корутины фрейм в динамической памяти. В сетевом коде, где основное время уходит на ожидание сокетов, эти расходы незаметны, а в вычислениях и там, где корутины скрывают небольшие задержки, их уже видно в профиле.
Привет, Хабр! На связи Юлий Тарасов. Под катом расскажу, как корутины устроены в C++, что с ними делает компилятор, какие оптимизации для них есть в LLVM и как с помощью атрибутов Clang убрать лишние аллокации. В основе текста — доклад на System Level Meetup конца 2025 года. Примеры для Clang соответствуют версии 20, в более новых релизах листинги и вывод программ могут отличаться. Примеры на C++ полные и компилируются, а псевдокод и схематичный LLVM IR я отмечаю в тексте.
Статья будет полезна как тем, кто только планирует использовать корутины и хочет заранее оценить их стоимость, так и тем, кто уже применяет их в проектах и хочет понять, как компилятор их оптимизирует. От вас потребуется знание C++ и общее представление о стеке и потоках, в остальном разберемся по ходу.
Навигация по статье:Немного базы: от routine к корутинам
Прежде чем говорить о корутинах, погрузимся в основы. Если для вас стековые фреймы, потоки операционной системы и вытесняющая многозадачность — уже понятные вещи, а не отдаленно знакомый набор терминов, то можете смело переходить к разделу «Корутины в C++: stackful и stackless».
Корутина — частный случай более общего понятия routine, с которого и начнем. Термин routine встречается у Дональда Кнута в пособии «Искусство программирования» (The Art of Computer Programming).
На русский его чаще всего переводят как «процедура» или «подпрограмма». Но немного заспойлерю, что слово «подпрограмма» еще понадобится для subroutine, поэтому routine оставим как есть, без перевода. Разберемся на примере, что стоит за этим термином.
Допустим, есть машина, которую мы программируем. Ее состояние включает содержимое регистров, памяти, счетчика команд и т. д. Часть этого состояния принадлежит определенному фрагменту кода, и больше никакой код к этой части не обращается. Это локальное состояние: у обычной функции, например, им служит стековый фрейм. Код вместе с таким состоянием называют routine. Локальное состояние меняет только сама routine, а состояние машины меняет каждая инструкция.
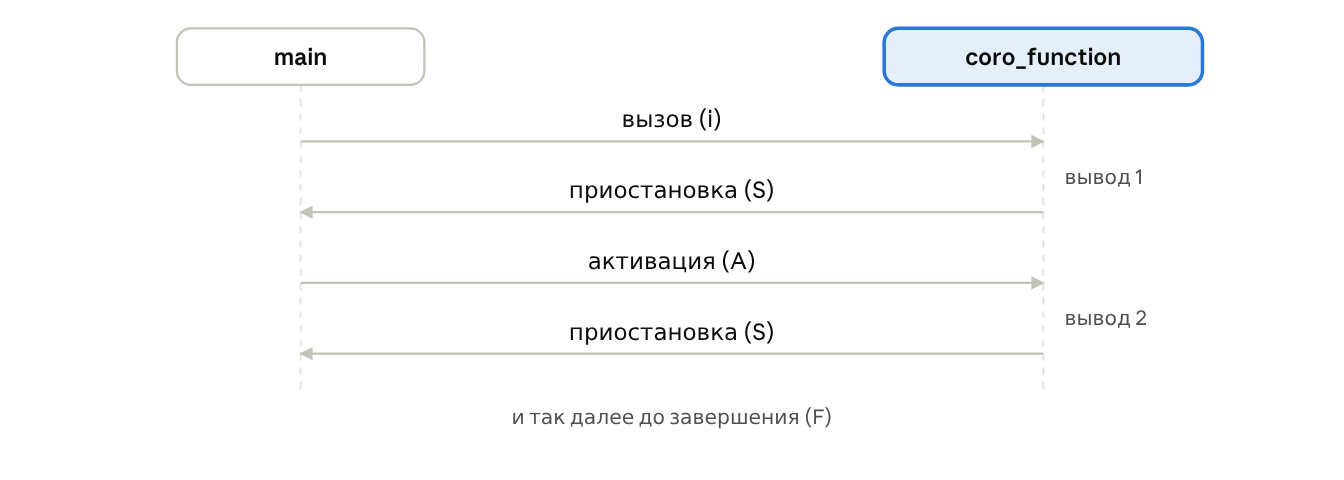
Над routine можно выполнять четыре базовых действия. Обозначения i, S, A, F будем использовать дальше в тексте и схемах.
Обозначение | Действие | Что происходит |
|---|---|---|
i | Invocation (вызов) | Старт выполнения routine, создание ее локального состояния |
S | Suspension (приостановка) | Остановка выполнения (похоже на передачу управления ОС через |
A | Activation (активация) | |
F | Finalization (завершение) | Конец работы routine, уничтожение ее локального состояния |
Все начинается с вызова, приостановить можно только выполняющуюся routine, а активировать — только приостановленную. После finalization локальное состояние исчезает, поэтому routine больше нельзя ни приостановить, ни активировать. По той же причине функция не может вернуть указатель на свои локальные переменные: после ее завершения этих переменных уже нет.
Если вы хотите развиваться в C++, возможно, вас заинтересуют наши вакансии:
Senior C++ developer / Старший инженер-программист (TATLIN.UNIFIED),
Инженер алгоритмов / Algorithms Engineer/ PHY Algorithms Engineer .
Другие вакансии для разработчиков на C++ смотрите на карьерном сайте YADRO.
Подпрограмма (subroutine)
Подпрограмма (subroutine) — это routine, которая поддерживает только invocation и finalization. В C++ такой routine соответствует обычная функция, например, для чисел Фибоначчи:
int fib(int n) {
  int a = 0, b = 1;

  for (int i = 0; i < n; ++i)
    a = std::exchange(b, a + b);

  return a;
}
В обычной реализации invocation соответствует вызову функции, finalization — возврату значения, а локальным состоянием служит стековый фрейм.
Посмотрим на работу функции fib на уровне стека: он растет вниз. Вызов выделяет для функции фрейм. В нем лежат локальные переменные, аргументы (если ABI требует передавать их через стек) и значения регистров, которые компилятор сохраняет и восстанавливает вокруг вызовов (spill и fill). После завершения функции фрейм исчезает, а стек принимает прежнее состояние.
Строка a = std::exchange(b, a + b) обновляет сразу два значения. std::exchange записывает в b новое значение a + b и возвращает прежнее значение b, которое попадает в a. За одну итерацию пара (a, b) превращается в (b, a + b), а это и есть шаг последовательности Фибоначчи.
Потоки и thread routine
Подпрограмма умеет только запускаться и завершаться. Нужен дополнительный механизм, чтобы routine можно было приостанавливать и возобновлять, и самый привычный из таких механизмов — потоки операционной системы.
Для сравнения возьмем те же числа Фибоначчи, но вычислять их будет отдельный поток: он кладет числа в очередь, а основной поток их забирает. Учитываем, что пример исключительно учебный и на практике так числа Фибоначчи не считают. В потоковом примере числа хранятся в unsigned: переполнение беззнакового типа определено и дает остаток по модулю. Очередь при этом не ограничена, что допустимо только в учебном коде.
std::mutex m;
std::condition_variable cv;
std::queue<unsigned> q;

void fibs(std::stop_token s) {
  unsigned a = 0, b = 1;
  while (!s.stop_requested()) {
    {
      std::lock_guard lg(m);
      q.push(b);
    }
    cv.notify_one();
    a = std::exchange(b, a + b);
  }
}

int main() {
  std::jthread p(fibs);
  for (int i = 0; i < 10; ++i) {
    std::unique_lock lk(m);
    cv.wait(lk, [&] { return !q.empty(); });
    unsigned v = q.front();
    // do anything with v
    q.pop();
  }
}
В примере за отдельный поток отвечает std::jthread. От std::thread он отличается двумя особенностями. Во-первых, деструктор jthread сам вызывает join(), поэтому писать этот вызов вручную не нужно. Во-вторых, jthread поддерживает stop token: перед join() деструктор вызывает request_stop(), а функция потока проверяет stop_requested() и вовремя завершается. Запрос на остановку можно отправить и в любой другой момент.
В коде такой routine нет явных точек приостановки и активации. Потоки приостанавливает и возобновляет операционная система, причем в любой момент, между любыми двумя инструкциями. Эту модель называют вытесняющей многозадачностью: планировщик ОС, который работает в привилегированном режиме, сам решает, когда остановить поток и когда вернуть ему управление. У каждого потока при этом свои стек, регистры и routine.
Но за такое удобство приходится платить. Каждая из трех операций в примере выше потенциально обращается к ядру ОС: захват мьютекса в lock_guard, его освобождение и cv.notify_one(). На Linux, например, обращение к ядру происходит через futex, когда мьютекс занят или у условной переменной есть ожидающий поток. Переключение контекста между потоками всегда выполняет планировщик ОС. Оба механизма сравнительно дорогие.
Эту цену можно не платить, если заранее знать, где routine должна приостанавливаться. В примере с числами Фибоначчи такое место одно: момент, когда очередное число готово и его нужно передать потребителю. Именно в этот момент, при передаче числа, приостанавливается корутина. В потоковой версии на этом месте производитель делает cv.notify_one(), а cv.wait стоит у потребителя. Если таких точек немного, программист может расставить их в коде сам и обойтись без операционной системы. Так работают корутины.
Корутина
Корутина (сопрограмма) — это routine, которая поддерживает контроль над точками suspend и activate. Разработчик сам задает, где routine приостанавливается и откуда продолжает после активации. Рассмотрим идею на примере псевдокода:
generator<int> fibs(int n) {
  int a = 0, b = 1;

  for (int i = 0; i < n; ++i) {
    suspend b;
    a = std::exchange(b, a + b);
  }

  return b;
}

auto fibgen = fibs(n);
int sum = 0;
for (int i = 0; i < n; ++i) {
  auto y = activate fibgen;
  sum = sum + y;
}
Вызов fibs(n) запускает корутину. Она доходит до suspend (S) и передает значение b вызывающему коду. Тот добавляет значение к сумме и активирует корутину (A), после чего корутина продолжает со следующей строки, и так до конца цикла.
Единого определения корутины нет: оно зависит от языка, от наличия у корутины собственного стека и от способа передачи управления. Дальше будем исходить из наиболее популярного и общего: корутина — это routine с явными точками приостановки и возобновления, которыми управляет программист.
Корутины в C++: stackful и stackless
В C++ корутины реализуют двумя способами. Главное различие между ними в том, где корутина хранит свое состояние. Stackful-корутины (или фиберы) обладают собственным стеком, как поток, но переключаются в пользовательском пространстве. Stackless-корутины собственного стека не имеют, а все необходимое для возобновления держат в небольшом фрейме. Ниже разберем оба варианта на примере чисел Фибоначчи.
Stackful: фиберы на Boost.Fiber
Рассмотрим пример реализации чисел Фибоначчи на Boost.Fiber:
using channel_t = boost::fibers::buffered_channel<int>;

void fib_producer(channel_t& fib_channel) {
  int a = 0, b = 1;
  for (;;) {
    if (fib_channel.push(b) == boost::fibers::channel_op_status::closed)
      return;
    a = std::exchange(b, a + b);
  }
}

int main() {
  channel_t fib_channel{16};
  boost::fibers::fiber producer(fib_producer, std::ref(fib_channel));
  for (int i = 0; i < 10; ++i) {
    int v;
    fib_channel.pop(v);
    // do anything with v
  }
  fib_channel.close();
  producer.join();
}
В этом примере работает планировщик (fiber scheduler). Он живет на обычном потоке ОС и управляет несколькими фиберами. Каждый фибер сам решает, когда остановиться и передать управление остальным. Точки S и A находятся внутри push и pop: если фибер упирается в заполненный или пустой канал, Boost.Fiber переключает стек на другой готовый фибер. Уступить управление можно и вручную, вызовом boost::this_fiber::yield().
Кооперативная многозадачность известна давно. На уровне ОС ее пробовали реализовать, например, в Windows 3.x и для 16-битных приложений в Windows 9x, и результат оказался неудачным: программы, как правило, не учитывают друг друга, и одной, не отдавшей управление, достаточно, чтобы зависла вся система. Внутри одной программы такой проблемы обычно нет, потому что фиберы согласованно отдают управление друг другу.
В итоге получается трехуровневая структура:
потоки операционной системы;
на каждом потоке свой fiber scheduler;
у каждого планировщика набор легких фиберов со своими стеками, которые он переключает между собой.
Однако в стандарт C++20 все же вошел другой вид корутин.
Stackless: корутины стандарта C++
У stackless-корутин нет собственного стека, как у генераторов в Python. Сам механизм корутин появился в C++20, а готовый std::generator — в C++23. Числа Фибоначчи на std::generator занимают несколько строк:
std::generator<int> fibs() {
  int a = 0, b = 1;
  for (;;) {
    co_yield b;
    a = std::exchange(b, a + b);
  }
}
Здесь co_yield — оператор, который приостанавливает корутину и возвращает значение b. В этом же месте находится точка активации: после возобновления корутина продолжит со следующей строки. Четыре базовые операции над routine (invocation, finalization, suspension, activation) в C++ соответствуют следующим конструкциям:
Операция | В языке C++ |
|---|---|
Invoke | Вызов |
Finalize |
|
Suspend |
|
Activate |
|
Конец тела в C++ еще не означает уничтожения фрейма. Если final_suspend не приостанавливает корутину, фрейм исчезает сразу, а если приостанавливает, как в Task ниже, он живет до вызова destroy().
Компилятор определяет, что функция является корутиной, по наличию в ее теле хотя бы одного из ко-операторов: co_await, co_yield или co_return. Точку приостановки задает co_await, co_yield — его частный случай, который заодно отдает значение, а co_return задает точку завершения. Явный co_return необязателен. Если у promise есть return_void(), выход за конец тела эквивалентен co_return;, а без return_void() возникает неопределенное поведение. Оператор return в корутине использовать нельзя: объект для вызывающего кода создает get_return_object() еще до начала тела, а результат корутина передает через co_return в promise.return_value().
Корутиной можно управлять через ее возвращаемый объект (return object), а возобновлять вызовом coroutine_handle::resume(). В исходном коде заметна лишь малая часть работы компилятора. Примерный псевдокод раскрытой формы:
generator fibs() {
  promise_type promise;
  generator retobj = promise.get_return_object();
  co_await promise.initial_suspend();
  try {
    /* тело корутины */
  } catch (...) {
    promise.unhandled_exception();
  }
final_suspend:
  co_await promise.final_suspend();
}
Внутри корутины компилятор создает объект promise, в исходном коде его не видно. Метод get_return_object() создает return object и отдает его вызывающей функции, а она управляет корутиной через этот объект. Перед выполнением тела корутина вычисляет co_await promise.initial_suspend(), а перед завершением co_await promise.final_suspend(). Что именно делают эти выражения, зависит от promise.
Такое устройство дает максимум точек кастомизации. Их хорошо видно в правилах, по которым компилятор раскрывает co_return, co_yield и co_await. Псевдокод для примера:
Выражение co_await работает с объектом awaiter, который описывает, как корутина приостанавливается и возобновляется. Чтобы получить awaiter, компилятор сначала пропускает выражение через promise.await_transform, если такой метод есть, а затем применяет operator co_await, если он определен. Оператор co_yield сводится к co_await, а co_return завершается вызовом co_await promise.final_suspend(), как в примере выше. Дальнейшее поведение корутины зависит от методов awaiter:
Если
await_ready()вернулtrue, корутина не приостанавливается: она продолжает выполнение как обычный код, с дополнительной кастомизацией черезco_await.Если
await_suspendвернулvoidилиtrue, корутина приостанавливается и возвращает управление тому, кто ее запустил или возобновил. Если вернулfalse, корутина продолжает выполняться сразу.Если
await_suspendвернулcoroutine_handle, корутина отдает управление другой корутине.
Благодаря этой механике корутины могут передавать управление друг другу напрямую (симметричная модель) или возвращать его тому, кто их запустил или возобновил (асимметричная модель). Какую модель получить, определяет логика awaiter. Результатом самого выражения co_await становится значение, которое вернул await_resume().
Корутины ортогональны потокам
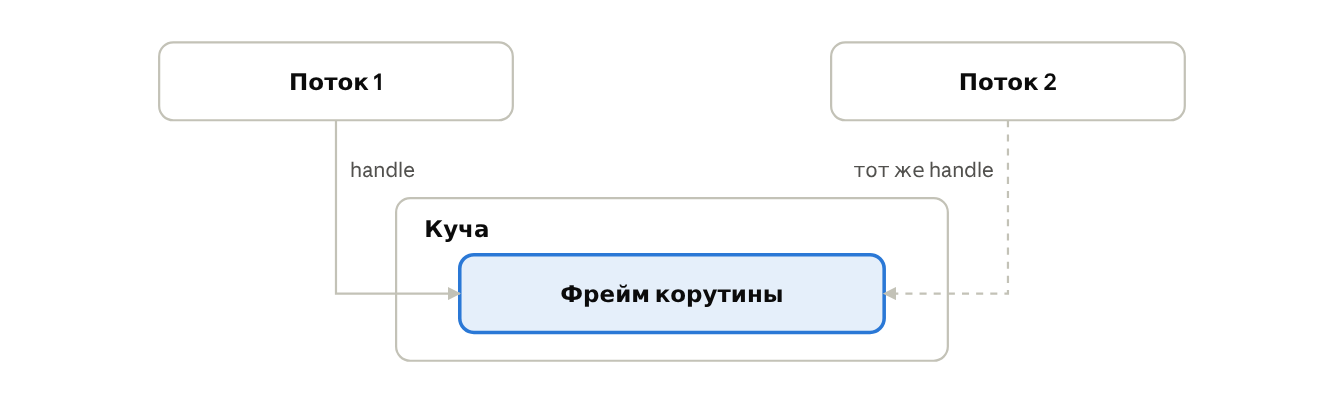
Главное свойство stackless-корутин в том, что они не привязаны к потокам операционной системы. У потока есть собственный стек, а у корутины только фрейм (coroutine state). Во фрейме лежат локальные переменные корутины, ее promise и служебные данные для возобновления. Фрейм находится не на стеке потока, а в динамической памяти, то есть в куче (heap). Это верно для общего случая. Ниже покажу, что компилятор иногда может разместить фрейм на стеке вызывающей функции, если докажет безопасность такого решения.
Фреймом управляет handle (std::coroutine_handle). Handle можно передать другому потоку и возобновить корутину там, а сам фрейм останется на прежнем месте. В примере ниже корутина стартует в одном потоке, а продолжает работу в другом:
struct task {
  struct promise_type {
    task get_return_object() { return {}; }
    std::suspend_never initial_suspend() { return {}; }
    std::suspend_never final_suspend() noexcept { return {}; }
    void return_void() {}
    void unhandled_exception() {}
  };
};

auto switch_to_new_thread(std::jthread& out) {
  struct awaitable {
    std::jthread* p_out;
    bool await_ready() { return false; }
    void await_suspend(std::coroutine_handle<> h) {
      std::jthread& out = *p_out;
      if (out.joinable())
        throw std::runtime_error("already running");
      out = std::jthread([h] { h.resume(); });
    }
    void await_resume() {}
  };
  return awaitable{&out};
}

task resuming_on_new_thread(std::jthread& out) {
  std::cout << "Started on: " << std::this_thread::get_id() << '\n';
  co_await switch_to_new_thread(out);
  std::cout << "Resumed on: " << std::this_thread::get_id() << '\n';
}

int main() {
  std::jthread out;
  resuming_on_new_thread(out);
}
Здесь await_suspend берет ссылку на jthread. Если jthread уже владеет потоком (joinable() возвращает true), значит, поток занят, и await_suspend бросает исключение. Иначе await_suspend создает в этом jthread новый поток, который вызывает h.resume(). Корутина выведет идентификатор одного потока, выполнит co_await и выведет идентификатор другого.
Стандартная корутина C++ не зависит от потока: любой поток может ее возобновить. Одновременно возобновлять ее из двух потоков нельзя, а планировщик и синхронизацию дает библиотека или программист, но не сама корутина. У нее нет собственного стека, только фрейм, поэтому в общем случае фрейм приходится хранить в куче. Это главная особенность stackless-корутин.
Фибер Boost.Fiber перенести между потоками сложнее, потому что вместе с ним нужно переносить стек. Такая миграция возможна: в Boost.Fiber есть планировщики shared_work и work_stealing. Но переносить можно только фиберы из очереди готовых к запуску, а сама миграция требует настройки планировщика и осторожности, например при работе с thread_local-данными.
Корутина с типом Task
Для разбора возьмем самый простой возвращаемый объект. Назовем его Task: он хранит handle корутины, возобновляет ее и уничтожает фрейм.
struct Task {
  struct promise_type {
    std::exception_ptr exception_;
    Task get_return_object() {
      return Task(std::coroutine_handle<promise_type>::from_promise(*this));
    }
    std::suspend_never initial_suspend() { return {}; }
    std::suspend_always final_suspend() noexcept { return {}; }
    void unhandled_exception() { exception_ = std::current_exception(); }
    void return_void() {}
  };
  using handle_type = std::coroutine_handle<promise_type>;

  handle_type h_;
  explicit Task(handle_type h) : h_(h) {}
  Task(const Task&) = delete;
  Task& operator=(const Task&) = delete;
  ~Task() { h_.destroy(); }
  explicit operator bool() { return !h_.done(); }
  void operator()() { h_(); }
};
Promise в этом примере устроен просто. Метод initial_suspend возвращает suspend_never, поэтому тело корутины начинает выполняться сразу при вызове и работает до первой приостановки. Метод final_suspend возвращает suspend_always: после завершения корутина остается приостановленной на финальной точке, ее фрейм жив, done() возвращает true, а фрейм уничтожает деструктор Task вызовом h_.destroy(). Копировать объект Task нельзя, иначе два таких объекта пытались бы уничтожить один и тот же фрейм. Task намеренно минимален: перемещения в нем нет, а исключение из корутины он сохраняет в exception_, но дальше не пробрасывает. Пока корутина не завершилась, operator bool возвращает true, а operator() возобновляет ее.
Теперь напишем корутину, которая возвращает Task, и функцию main, которая ее запускает:
Task coro_function(int n) {
  for (int i = 1; i < n; ++i) {
    std::printf("%d\n", i);
    co_await std::suspend_always{};
  }
}

int main() {
  auto Coro = coro_function(10);
  while (Coro)
    Coro();
}
Корутина выводит числа от 1 до 9 и после каждого приостанавливается, возвращая управление в main. Функция main в цикле возобновляет корутину, пока та не завершится.
Для простых случаев в стандартной библиотеке уже есть готовые типы: std::generator (C++23) и std::execution::task (C++26). Собственный Task нужен здесь, чтобы на нем показать работу компилятора.
Что должен сделать компилятор
Рассмотрим, что происходит с корутиной coro_function при компиляции. Компилятору нужно:
Выделить память под фрейм.
Создать
promiseиreturn object.Организовать возврат return object вызывающему коду, а работу с фреймом вынести в отдельную функцию.
Реализовать приостановку и возобновление.
Для этого компилятор добавляет перегрузку: функцию, невидимую в исходном коде, которая принимает указатель на фрейм. Функция coro_function, видимая вызывающему коду, выделяет фрейм, создает promise и return object и вызывает эту перегрузку. Пример на основе псевдокода:
// Перегрузки, невидимые в исходном коде: настоящее тело корутины
void coro_function_resume(_Frame* frame_ptr)  { /* ... */ }
void coro_function_destroy(_Frame* frame_ptr) { /* ... */ }

// Функция, которую видит вызывающий код
Task coro_function(int n) {
  _Frame* _Coro_frameptr = new _Frame;
  _Coro_frameptr->n = n;
  _Coro_frameptr->_Coro_resume_fn  = coro_function_resume;
  _Coro_frameptr->_Coro_destroy_fn = coro_function_destroy;
  auto* _P = &_Coro_frameptr->_Coro_promise;
  Task retval = _P->get_return_object();
  coro_function_resume(_Coro_frameptr);  // initial_suspend и тело до первой приостановки
  return retval;
}
Для фрейма компилятор вызывает operator new. Именно здесь возникает динамическая аллокация, которую пытаются убрать оптимизации. Во фрейме находятся указатели на функции resume и destroy, promise, аргументы (n), локальные переменные (i) и индекс точки возобновления.
Теперь рассмотрим работу с фреймом. На уровне машинного кода корутин не существует, есть только инструкции процессора. Приостановку и возобновление функции компилятор реализует с помощью обычного switch. Примерный псевдокод:
void coro_function_resume(_Frame* f) {
  switch (f->_Coro_resume_index) {
    case 0: goto start;      // первый запуск
    case 1: goto resume_1;   // продолжение после co_await
    // ... по одной метке на каждую точку возобновления
  }
start:
  for (f->i = 1; f->i < f->n; ++f->i) {
    std::printf("%d\n", f->i);
    f->_Coro_resume_index = 1;  // запоминаем, где продолжить
    return;                     // suspend
resume_1:;                      // сюда попадаем при resume
  }
  // ... конец тела: final_suspend
}
Каждой точке приостановки соответствует метка в коде, а во фрейме лежит номер точки, с которой нужно продолжить. При приостановке корутина записывает в этот номер новое значение и выходит из функции. При возобновлении switch читает номер и переходит на нужную метку: корутина продолжает с того места, где остановилась.
При такой схеме resume через handle сводится к простому вызову. По сути, coroutine_handle является указателем на фрейм, а в начале фрейма (в GCC и Clang) находится указатель на resume-функцию. Вызов resume() превращается в косвенный вызов этой функции с фреймом в качестве аргумента. Если компилятор знает, какая именно корутина вызывается, он может заменить косвенный вызов прямым (девиртуализация). GCC в ряде случаев с этим справляется.
Что получается у GCC
Посмотрим, как с этим примером справляется GCC. Ниже приведены ключевые фрагменты сгенерированного ассемблерного кода x86: цикл в main и начало функции coro_function.
main:   // ....
        call    coro_function(int)
        mov     rbx, QWORD PTR [rsp+8]   ; handle (адрес фрейма)
        mov     rax, QWORD PTR [rbx]     ; указатель на resume-функцию из фрейма
        test    rax, rax
        je      .L34                     ; ноль — корутина уже завершена
.L35:
        mov     rdi, rbx                 ; аргумент — сам фрейм
        call    rax                      ; resume: косвенный вызов
        mov     rax, QWORD PTR [rbx]
        test    rax, rax
        jne     .L35

coro_function(int): // ....
        mov     edi, 48
        sub     rsp, 8
        call    operator new(unsigned long)   ; фрейм — 48 байт в куче
        // ....
.LC3:
        .quad   coro_function(_Z13coro_functioni.Frame*) (.actor)
.LC4:
        .quad   coro_function(_Z13coro_functioni.Frame*) (.destroy)
Код получается аккуратным: условие while (Coro) превратилось в проверку указателя на resume-функцию во фрейме, а .actor и .destroy — это resume- и destroy-функции, адреса которых компилятор кладет во фрейм. Но оптимизировать здесь еще есть что. Во-первых, остался вызов operator new: компилятор по-прежнему выделяет фрейм в куче. Во-вторых, возобновление остается косвенным вызовом (call rax). Прямого вызова resume-функции, а тем более ее встраивания в цикл в ассемблере нет.
Почему оптимизация корутин сложна и что с ней делать
Сложность оптимизации корутин в компиляторах имеет две причины:
Для сложных сценариев, например возобновления на другом потоке, корутина должна включать сложное поведение, в частности хранить фрейм в куче.
Для простых сценариев, например вычисления чисел Фибоначчи, эта сложность неоправданно замедляет работу.
При этом подобную сложность создает и поддерживает сам компилятор. Остается выяснить, может ли он справиться с ней самостоятельно и как программист может ему в этом помочь.
Если оверхед корутин заметен в профиле, есть три пути:
Доработать оптимизации в самом GCC. Это долго и сложно, поэтому подходит редко.
Оставить как есть. Если корутины не являются узким местом, это разумный выбор.
Посмотреть, как с той же задачей справляется другой компилятор. Удобнее всего разбирать Clang: LLVM сохраняет семантику корутин в промежуточном представлении, и по нему видно, какие оптимизации срабатывают.
Корутины в Clang/LLVM
Clang построен на компиляторном фреймворке LLVM, который выполняет все оптимизации над промежуточным представлением LLVM IR. По виду LLVM IR напоминает ассемблер с типами.
Для чтения дальнейших листингов хватит основ синтаксиса LLVM IR. Разберем эти основы на примере функции main, которая создает корутину, дважды возобновляет ее и уничтожает:
define i32 @main() {
entry:
  %hdl = call ptr @f(i32 4)
  call void @llvm.coro.resume(ptr %hdl)
  call void @llvm.coro.resume(ptr %hdl)
  call void @llvm.coro.destroy(ptr %hdl)
  ret i32 0
}
Из чего состоит этот фрагмент:
define— ключевое слово, открывающее определение функции;i32— тип (LLVM IR типизирован, а указатели в нем простоptr);@main— имя функции (глобальные имена начинаются с @);entry:— метка;%hdl— SSA-значение, то есть переменная, которой значение присваивают один раз (локальные значения начинаются с %);call,ret— опкоды инструкций;4,0— литералы;@f— вызов другой функции;@llvm.coro.resume— интринсик.
Интринсик — это встроенная функция компилятора. Обычно у нее нет реализации, и она не линкуется ни с какими библиотеками. Компилятор знает ее семантику, использует интринсики на промежуточных этапах оптимизации и затем заменяет их обычным кодом. Имена интринсиков LLVM начинаются с префикса llvm., например llvm.coro.resume.
Корутина в LLVM IR
Вызов корутины со стороны вызывающей функции выглядит просто. Чтобы понять, как устроена сама корутина, возьмем небольшой пример, в котором она приостанавливается, печатает «42» и завершается. Его псевдокод:
def f()
  suspend
  print 42
  return
Важное уточнение. В листингах LLVM IR я рассматриваю только структуру, без аргументов интринсиков и части служебных блоков.
Приблизительный LLVM IR этой корутины:
define ptr @f() {
entry:
  %id = call token @llvm.coro.id(...)
  %size = call i64 @llvm.coro.size.i64()
  %alloc = call ptr @malloc(i64 %size)
  %hdl = call ptr @llvm.coro.begin(token %id, ptr %alloc)
  %0 = call i8 @llvm.coro.suspend(token none, i1 false)
  switch i8 %0, label %coro.ret [
    i8 0, label %coro.body
    i8 1, label %cleanup
  ]
coro.body:
  call void @print(i32 42)
  br label %cleanup
cleanup:
  %mem = call ptr @llvm.coro.free(token %id, ptr %hdl)
  call void @free(ptr %mem)
  br label %coro.ret
coro.ret:
  call void @llvm.coro.end(ptr %hdl, i1 false, token none)
  ret ptr %hdl
}
Рассмотрим, какие роли выполняют в этом листинге интринсики и блоки:
Выделение и создание фрейма. Размер фрейма возвращает
llvm.coro.size,mallocвыделяет память, аllvm.coro.beginотмечает начало корутины и возвращает handle.Точка приостановки. Интринсик
llvm.coro.suspendвозвращает значение, по которомуswitchвыбирает дальнейший путь:0означает возобновление, и корутина выполняет тело (coro.body),1означает уничтожение, и управление переходит вcleanup. Остальные значения (на практике-1, это ветка по умолчанию) означают, что корутина приостановлена и нужно выйти из функции.Удаление фрейма (
cleanup). Интринсикllvm.coro.freeвозвращает указатель на память, которую нужно освободить, аfreeее освобождает.Возврат из корутины (
coro.ret). Интринсикllvm.coro.endотмечает конец корутины, после чего функция возвращает handle.
Обратите внимание: в упрощенном примере выше функция возвращает указатель на фрейм (handle корутины), а не return object.
Вернемся к корутине coro_function. Ее приблизительный LLVM IR:
define ptr @coro_function(i32 %n) {
entry:
  %i = alloca i32
  %id = call token @llvm.coro.id(...)
  %size = call i64 @llvm.coro.size.i64()
  %alloc = call ptr @malloc(i64 %size)
  %hdl = call ptr @llvm.coro.begin(token %id, ptr %alloc)
  br label %for.init
for.init:
  store i32 1, ptr %i
  br label %for.cond
for.cond:
  %i.val.cond = load i32, ptr %i
  %cmp = icmp slt i32 %i.val.cond, %n
  br i1 %cmp, label %for.body, label %cleanup
for.body:
  %i.val = load i32, ptr %i
  call void @print(i32 %i.val)
  %0 = call i8 @llvm.coro.suspend(token none, i1 false)
  switch i8 %0, label %suspend [i8 0, label %for.inc
                                i8 1, label %cleanup]
for.inc:
  %i.val.prev = load i32, ptr %i
  %i.val.inc = add i32 %i.val.prev, 1
  store i32 %i.val.inc, ptr %i
  br label %for.cond
cleanup:
  %mem = call ptr @llvm.coro.free(token %id, ptr %hdl)
  call void @free(ptr %mem)
  br label %suspend
suspend:
  call void @llvm.coro.end(ptr %hdl, i1 false, token none)
  ret ptr %hdl
}
Здесь встречается инструкция alloca: она выделяет память на стеке, в этом примере под единственную локальную переменную i. Дальше, как и в простом примере, идет выделение фрейма, а в конце находится блок cleanup. Несколько блоков посередине образуют цикл for: инициализация, вычисление условия и инкремент, который корутина выполняет после возобновления. Если условие выполнено, условный переход br i1 ведет в тело цикла, иначе — в cleanup, так как корутина закончила работу. Для простоты в листинге нет финальной точки приостановки, после цикла корутина сразу освобождает фрейм. Как выглядит финальная точка, видно ниже, в функции пробуждения после CoroSplit.
Листинг выглядит громоздко, но это представление до оптимизаций. LLVM IR намеренно сохраняет больше семантической информации о корутине: благодаря этому компилятор может выполнять более сложный анализ и более сильные преобразования, о которых речь пойдет дальше.
Пять проходов LLVM для корутин
В LLVM есть пять трансформаций, специфичных для корутин: CoroEarly, CoroSplit, CoroElide, CoroCleanup и CoroAnnotationElide. Первые четыре работают с любыми корутинами, а CoroAnnotationElide срабатывает только для корутин, помеченных специальными атрибутами Clang. Ее удобнее рассмотреть позже, вместе с самими атрибутами, а сейчас разберем первые четыре.
CoroEarly
CoroEarly готовит корутины к последующим преобразованиям. У LLVM много фронтендов, и корутины приходят от них в немного разном виде. CoroEarly приводит высокоуровневую информацию к единому виду, чтобы дальше все корутины выглядели одинаково.
CoroSplit
CoroSplit разбивает корутину на несколько функций:
ramp-функция (ramp function) создает и инициализирует фрейм, конструирует объекты на фрейме и выполняет тело корутины до первой приостановки;
функция пробуждения (resume) реализует основную логику корутины и срабатывает при
coroutine_handle::resume();функция уничтожения (destroy) корректно уничтожает объекты на фрейме, освобождает его и срабатывает при
coroutine_handle::destroy().
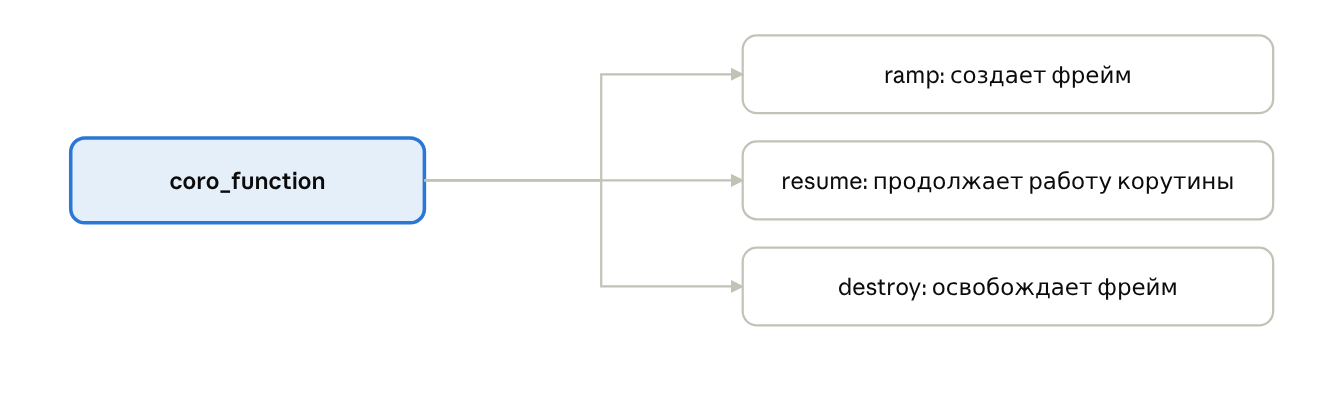
Разбиение нужно, чтобы вместо одной большой функции получилось несколько небольших, которые чаще удается инлайнить. Именно CoroSplit в сочетании с инлайном делает возможными следующие оптимизации.
Для coro_function после CoroSplit получаются три функции. Сначала тип фрейма и ramp-функция:
; фрейм: указатель на resume, указатель на destroy, n, i (без promise и индекса)
%coro.frame = type { ptr, ptr, i32, i32 }

define ptr @coro_function(i32 %n) {
entry:
  %id = call token @llvm.coro.id(...)
  %size = call i64 @llvm.coro.size.i64()
  %alloc = call ptr @malloc(i64 %size)
  %hdl = call ptr @llvm.coro.begin(token %id, ptr %alloc)
  %resume.ptr = getelementptr %coro.frame, ptr %hdl, i32 0, i32 0
  store ptr @coro_function.resume, ptr %resume.ptr
  %destroy.ptr = getelementptr %coro.frame, ptr %hdl, i32 0, i32 1
  store ptr @coro_function.destroy, ptr %destroy.ptr
  %n.spill.addr = getelementptr %coro.frame, ptr %hdl, i32 0, i32 2
  store i32 %n, ptr %n.spill.addr
  %i.spill.addr = getelementptr %coro.frame, ptr %hdl, i32 0, i32 3
  store i32 1, ptr %i.spill.addr
  br label %for.cond
for.cond:
  %i.val.cond = load i32, ptr %i.spill.addr
  %cmp = icmp slt i32 %i.val.cond, %n
  br i1 %cmp, label %for.body, label %return
for.body:
  %i.val = load i32, ptr %i.spill.addr
  call void @print(i32 %i.val)
  br label %return
return:
  ret ptr %hdl
}
В ramp-функции видны следующие изменения:
Инструкция
getelementptrвычисляет указатель на поле структуры. С ее помощью ramp-функция получает указатели на поля фрейма: функции resume и destroy, аргументnи переменнуюi.Значения
nиi, которые должны пережить приостановку, теперь лежат во фрейме. Такой перенос называют spill.Инструкция alloca исчезла: переменная
iбольше не живет на стеке.Метод
initial_suspendу promise в этом примере возвращаетsuspend_never, поэтому в ramp-функции осталась первая итерация цикла. После нее управление переходит не вfor.condиfor.body, а сразу вreturn, который возвращает handle корутины.
Вторая функция — функция пробуждения:
define void @coro_function.resume(ptr %hdl) {
entry:
  %i.spill.addr = getelementptr %coro.frame, ptr %hdl, i32 0, i32 3
  %i.spill = load i32, ptr %i.spill.addr
  %i.inc = add i32 %i.spill, 1                      ; инкремент цикла
  store i32 %i.inc, ptr %i.spill.addr
  %n.spill.addr = getelementptr %coro.frame, ptr %hdl, i32 0, i32 2
  %n.spill = load i32, ptr %n.spill.addr
  br label %for.cond
for.cond:
  %cmp = icmp slt i32 %i.inc, %n.spill              ; условие цикла
  br i1 %cmp, label %for.body, label %final.suspend
for.body:
  call void @print(i32 %i.inc)                      ; тело цикла
  br label %return
final.suspend:
  store ptr null, ptr %hdl                          ; resume = null, done() вернет true
  br label %return
return:
  ret void
}
Инструкции switch здесь нет, потому что у корутины единственная точка, с которой ее можно возобновить. В общем случае функция пробуждения начинается со switch по индексу, как в псевдокоде на C++ выше. К локальным переменным и аргументам обращение идет явно, через фрейм. Каждый вызов выполняет одну итерацию цикла (инкремент, проверка условия, тело) и возвращается, то есть корутина снова приостанавливается. Когда цикл заканчивается, функция пробуждения записывает null в поле с указателем на resume. Так компилятор отмечает финальную точку приостановки, и по этому признаку done() возвращает true.
Третья функция, функция уничтожения, освобождает фрейм. Перед этим настоящая destroy-функция вызывает деструкторы объектов во фрейме, например promise, а в листинге остался только вызов free:
define void @coro_function.destroy(ptr %hdl) {
entry:
  call void @free(ptr %hdl)
  ret void
}
CoroElide
CoroElide убирает динамическую аллокацию фрейма. После CoroSplit корутина состоит из небольших функций, которые легче встроить в вызывающую функцию. Когда встраивание произошло, CoroElide проверяет, нужна ли аллокация в куче, и если нет, размещает фрейм в вызывающей функции. У обычной функции это ее стек, а у корутины фрейм вложенной корутины становится частью ее собственного фрейма, который сам может лежать в куче.
Для этого должны выполняться два условия. Во-первых, время жизни состояния корутины должно целиком укладываться во время жизни вызывающей функции. Во-вторых, компилятор должен знать размер фрейма на этапе компиляции.
Кроме того, где это возможно, CoroElide заменяет интринсики llvm.coro.resume и llvm.coro.destroy прямыми вызовами функций пробуждения и уничтожения, то есть девиртуализирует их. Саму оптимизацию размещения фрейма на стеке в литературе называют HALO — Heap Allocation eLision Optimization.
Реализовать это непросто, потому что компилятор очень ограничен в своих действиях. Любое преобразование не должно менять поведение программы относительно стандарта, поэтому компилятор проводит все анализы максимально консервативно. Чем больше понятной компилятору информации доходит до CoroElide, тем выше вероятность, что оптимизация сработает.
Иногда компилятор убирает оверхед корутины полностью. В примере с coro_function он встраивает корутину в main целиком, CoroElide размещает фрейм на стеке main, а последующие оптимизации убирают остальное. Ассемблер, который Clang генерирует для main в этом случае:
main:
    push    rbp
    push    rbx
    push    rax
    lea     rbx, [rip + .L.str]
    mov     rdi, rbx
    mov     esi, 1
    xor     eax, eax
    call    printf@PLT
    mov     ebp, 2
    cmp     ebp, 10
    je      .LBB1_3
.LBB1_2:
    mov     rdi, rbx
    mov     esi, ebp
    xor     eax, eax
    call    printf@PLT
    inc     ebp
    cmp     ebp, 10
    jne     .LBB1_2
.LBB1_3:
    xor     eax, eax
    add     rsp, 8
    pop     rbx
    pop     rbp
    ret
По этому фрагменту на ассемблере невозможно догадаться, что в исходниках была корутина: остался обычный цикл с printf.
CoroCleanup
CoroCleanup выполняет финальную уборку: заменяет обычным кодом (lowering) все интринсики llvm.coro.*, которые не обработали в предыдущих проходах.
Когда elide не срабатывает
Усложним пример. В promise_type добавим перегрузки operator new и operator delete, которые печатают размер фрейма, чтобы видеть динамические аллокации. В Task добавим перегрузку operator co_await, а в программу еще одну корутину, coro_inc, которую внешняя корутина вызывает через co_await:
struct Task {
  struct promise_type {
    Task get_return_object() {
      return Task(std::coroutine_handle<promise_type>::from_promise(*this));
    }
    std::suspend_never initial_suspend() { return {}; }
    std::suspend_always final_suspend() noexcept { return {}; }
    void unhandled_exception() { std::terminate(); }
    void return_void() {}

    static void* operator new(std::size_t frame_sz) {
      std::cout << "allocated " << frame_sz << " bytes" << std::endl;
      return ::operator new(frame_sz);
    }
    static void operator delete(void* ptr, std::size_t frame_sz) {
      std::cout << "deallocated " << frame_sz << " bytes" << std::endl;
      std::free(ptr);
    }
  };
  using handle_type = std::coroutine_handle<promise_type>;

  handle_type h_;
  explicit Task(handle_type h) : h_(h) {}
  Task(const Task&) = delete;
  ~Task() { h_.destroy(); }
  explicit operator bool() { return !h_.done(); }
  void operator()() { h_(); }
  auto operator co_await() { return std::suspend_always(); }
};

Task coro_inc(int x) {
  std::printf("inc: %d\n", x + 1);
  co_return;
}

Task coro_function(int n) {
  for (int i = 1; i < n; ++i) {
    std::printf("%d\n", i);
    co_await coro_inc(i);
    co_await std::suspend_always{};
  }
}

int main() {
  auto Coro = coro_function(10);
  while (Coro)
    Coro();
}
Важное уточнение: компилятор ищет
operator newиoperator deleteдля фрейма корутины в области видимости promise-типа, поэтому они находятся именно вpromise_type.
Для краткости operator co_await здесь не ждет coro_inc. Из-за suspend_never вложенная корутина выполняется сразу при вызове, а co_await только добавляет внешней корутине точку приостановки. В рабочем коде awaiter запоминает handle внешней корутины и возобновляет ее, когда вложенная завершится.
Вывод этой программы, собранной Clang, показывает, происходят ли динамические аллокации. При этом размеры фреймов зависят от компилятора и его версии:
allocated 48 bytes
1
allocated 32 bytes
inc: 2
deallocated 32 bytes
2
allocated 32 bytes
inc: 3
deallocated 32 bytes
3
allocated 32 bytes
inc: 4
deallocated 32 bytes
4
allocated 32 bytes
...
Динамические аллокации здесь есть: внешняя корутина выделяет фрейм один раз, а coro_inc выделяет и освобождает его на каждой итерации. Awaiter в этом примере компилятору виден целиком, так что дело не в нем. Чтобы убрать аллокацию, CoroElide должен встроить ramp-функцию coro_inc в coro_function и доказать, что фрейм уничтожается до выхода из нее.
Фрейм уничтожает деструктор Task через поле h_, и связать этот вызов с созданием фрейма анализ не может. В таких условиях компилятор действует консервативно и оставляет аллокацию. Проверить это можно флагом Clang -Rpass-missed=coro-elide: для каждой такой корутины он печатает сообщение «… not elided in …».
Выделением памяти под фрейм можно управлять: достаточно перегрузить
operator newиoperator deleteв promise-типе, как в примере выше. Версияoperator newможет принимать и аргументы самой корутины, так что, например, аллокатор можно передать первым параметром.
Помогаем компилятору: атрибуты Clang
Благодаря подробной семантике корутин, которую LLVM сохраняет в промежуточном представлении, в Clang есть специальные атрибуты. Они дают программисту возможность сообщить компилятору, что elide в конкретном месте безопасен. Компилятор доверяет такой подсказке и не проверяет ее, поэтому ответственность за корректность лежит на программисте. Ниже разберем два атрибута: coro_await_elidable и coro_await_elidable_argument.
Атрибут coro_await_elidable
Атрибут [[clang::coro_await_elidable]] ослабляет условия применения elide. Он задает контекст, в котором компилятор может принудительно убрать аллокацию фрейма: корутина должна быть непосредственным операндом co_await-выражения. Атрибут нужно поставить на возвращаемый тип корутины:
struct [[clang::coro_await_elidable]] Task {
  // ...
};
После добавления атрибута в этом примере исчезают все динамические аллокации:
1
inc: 2
2
inc: 3
3
inc: 4
...
9
inc: 10
Корутина должна быть непосредственным операндом co_await и нигде больше не использоваться. Если вызов сохранить в переменную и использовать после co_await, безопасный контекст пропадет и компилятор оставит динамическую аллокацию:
Task coro_inc(int x) {
  std::printf("inc: %d\n", x + 1);
  co_await std::suspend_always{};
  co_return;
}

Task coro_function(int n) {
  for (int i = 1; i < n; ++i) {
    std::printf("%d\n", i);
    auto Inc = coro_inc(i);
    co_await Inc;
    Inc();                       // объект используется после co_await
    co_await std::suspend_always{};
  }
}
В выводе этого варианта снова появляются строки allocated 32 bytes и deallocated 32 bytes.
Атрибут coro_await_elidable_argument
В библиотеках для корутин часто есть вспомогательная функция вроде when_all: она принимает несколько корутин, и на ее результат можно сделать co_await один раз. Рассмотрим пример:
struct Task { /* ... */ };
struct WhenAll { /* ... */ };

template <typename... Ts>
WhenAll when_all(Ts&&... tasks);

Task foo();
Task bar();

Task cooperate() {
  co_await when_all(foo(), bar());   // elide не срабатывает
}
В таком виде elide не срабатывает. Атрибут [[clang::coro_await_elidable]] на WhenAll ситуацию не меняет, на Task тоже. Причина в том, что корутины foo() и bar() передаются в when_all как аргументы, а компилятор не знает, что when_all с ними делает. Для таких случаев есть второй атрибут, [[clang::coro_await_elidable_argument]]. Он распространяет контекст безопасного elide на аргументы функции:
struct [[clang::coro_await_elidable]] Task { /* ... */ };
struct [[clang::coro_await_elidable]] WhenAll { /* ... */ };

template <typename... Ts>
WhenAll when_all([[clang::coro_await_elidable_argument]] Ts&&... tasks);

Task foo();
Task bar();

Task cooperate() {
  co_await when_all(foo(), bar());   // elide сработал
}
Атрибут coro_await_elidable_argument работает только в связке с coro_await_elidable: на возвращаемый тип корутины coro_await_elidable должен быть уже установлен. Оба атрибута появились в Clang 20, а более ранние версии компилятора их не поддерживают.
CoroAnnotationElide
Атрибуты Clang обрабатывает пятая трансформация LLVM, CoroAnnotationElide. Она находит вызовы корутин, помеченные атрибутами, и применяет к ним принудительный elide, если выполнены все условия. Для этого CoroSplit дополнительно создает вариант ramp-функции без аллокации (.noalloc), который принимает готовый фрейм. CoroAnnotationElide подставляет этот вариант в помеченные вызовы, и фрейм вложенной корутины становится частью фрейма вызывающей.
Ограничения
Атрибуты не расширяют возможности анализа: компилятор не начинает проверять больше, он лишь ослабляет требования к оптимизации и перекладывает ответственность за корректность на программиста. Поставить их везде в расчете на то, что все вычислится на этапе компиляции, не получится. Если использовать handle за пределами времени жизни корутины или нарушить другие условия, на которые рассчитывает атрибут, поведение программы становится неопределенным, и компилятор от такой ошибки не защитит.
Главное из этих условий документация Clang формулирует так: если вызывающая корутина уничтожена раньше вложенной, поведение не определено. Обработку атрибутов в LLVM разбирает документация по корутинам.
Заключение: когда корутины стоит оптимизировать
Стоимость корутин и необходимость оптимизации зависят от сценария использования. Если основное время уходит на ожидание ввода-вывода, накладными расходами на корутины можно пренебречь и ничего оптимизировать не нужно. Типичный пример — цикл обработки соединения:
for (;;) {
  length = co_await socket.async_read_some(net::buffer(data), ctx);
  co_await async_write(socket, net::buffer(data, length), ctx);
}
Корутина здесь выступает асинхронным планировщиком: отправляет асинхронное чтение, ждет его завершения, передает результат в асинхронную запись, а в это время поток может заниматься другой работой. Производительность здесь обычно определяет ввод-вывод, хотя при очень частом создании корутин их накладные расходы тоже могут стать заметными.
Если на корутинах строят вычисления (CPU-bound) или с их помощью скрывают небольшие задержки между сетевыми обращениями, аллокация фрейма в куче может стать заметной. В таком случае разумно действовать по шагам:
Убедиться, что аллокации действительно есть. Для этого достаточно перегрузить
operator newиoperator deleteв promise-типе, как в примере выше, и посчитать вызовы. Clang может и сам сообщить, где elide не сработал: для этого есть флаг-Rpass-missed=coro-elide.Дать компилятору возможность увидеть корутину целиком. Чем больше он видит (определение корутины и вызывающий код в одной единице трансляции, простые awaiter), тем выше шанс, что CoroElide сработает.
Если elide не срабатывает, а время жизни корутины заведомо вложено во время жизни вызывающей функции, поставить
[[clang::coro_await_elidable]]и при необходимости[[clang::coro_await_elidable_argument]], взяв ответственность за корректность на себя.
Одна из причин, по которой в стандарт вошли именно stackless-корутины, — возможность оптимизаций. Компилятор решает, где разместить фрейм, на этапе компиляции: если он доказал, что время жизни фрейма вложено во время жизни вызывающего кода, а размер фрейма известен, аллокацию в куче можно убрать. Для stackful-корутин такая оптимизация невозможна, потому что планировщик находится в библиотеке и компилятор ничего о нем не знает.
Stackful-корутины при этом остаются разумным выбором, например в сетевых сервисах, где основное время уходит на ввод-вывод (на них построен фреймворк userver). Код на них проще писать, потому что не нужно разбираться в co_await и awaiter, но добиться для них zero-overhead обычно сложнее, чем для stackless-корутин.
Поддержка корутин в GCC, Clang и MSVC достигла production-уровня. Даже без атрибутов GCC генерирует приемлемый код. По замерам на O2 на числах Фибоначчи Clang 18 работает быстрее GCC 14 примерно на 20%, и еще около 10%, по моему прогнозу, остается в запасе для дальнейших оптимизаций.

Комментарии 0