Всем привет, меня зовут Сергей Прощаев, и в этой статье расскажу про холодный старт Spring Boot: что именно JVM делает в первые секунды и какие из этих секунд можно вернуть, не переписывая сервис.
Я Tech Lead и руководитель направления Java | Kotlin разработки в FinTech & E‑commerce и преподаю на курсах разработки и архитектуры в ОТУС.
Знакомая картина: pod перезапустился, автомасштабирование под пик добавляет реплики, и каждой из них нужно несколько секунд, прежде чем она начнёт принимать запросы. Отсюда давний спор «JVM медленно стартует, поэтому для облака берите Go или native».
С выходом JDK 25 в этом споре появился ещё один вариант: первые возможности Project Leyden вошли в LTS‑версию Java, и AOT‑кэш создаётся без изменения кода приложения, ценой одного дополнительного шага в сборке.
Я захотел проверить не обещания, а цифры, поэтому взял один и тот же сервис и запустил его семью способами на одной машине.
Коротко о результате. Время до первого ответа сократилось с 3,7 секунды до 0,06. Самый быстрый по старту режим на JVM ответил на первый запрос медленнее всех. А прогретый снимок CRaC обогнал native‑образ. Ниже разберём, почему так вышло.
Откуда берутся секунды
Если посмотреть на старт Spring Boot глазами JVM, работа делится на три слоя.
Первый слой занимается классами. Даже небольшой сервис с web, JPA и actuator загружает их больше пятнадцати тысяч: в отдельном диагностическом запуске обычного JVM‑режима
-Xlog:class+loadнасчитал 15 408 событий загрузки к моменту, когда открылся порт. Уникальных имён столько же, повторных загрузок одного имени нет.
Каждый класс нужно найти в jar, разобрать, проверить байткод и связать с остальными. Один класс обходится дёшево, но пятнадцать тысяч складываются в заметную долю секунды на каждом запуске.
Второй слой относится к фреймворку. Spring сканирует пакеты, читает аннотации, строит определения бинов и создаёт прокси, Hibernate собирает метамодель сущностей.
Третий слой касается холодного кода. HotSpot начинает выполнять приложение в интерпретаторе, затем по мере накопления профилей компилирует часто вызываемые методы, сначала C1, а самые горячие C2. Кроме того, при стандартном
spring.mvc.servlet.load-on-startup=-1контейнер откладывает инициализациюDispatcherServletдо первого обращения.
Часть инфраструктуры Jackson и JPA создаётся вместе с контекстом, часть классов и операций впервые понадобится только на первом запросе. Поэтому первый запрос я меряю отдельно: он показывает совокупную цену всей отложенной работы.
Каждый из способов ускорения срезает свой слой.
На схеме видно, какой именно:
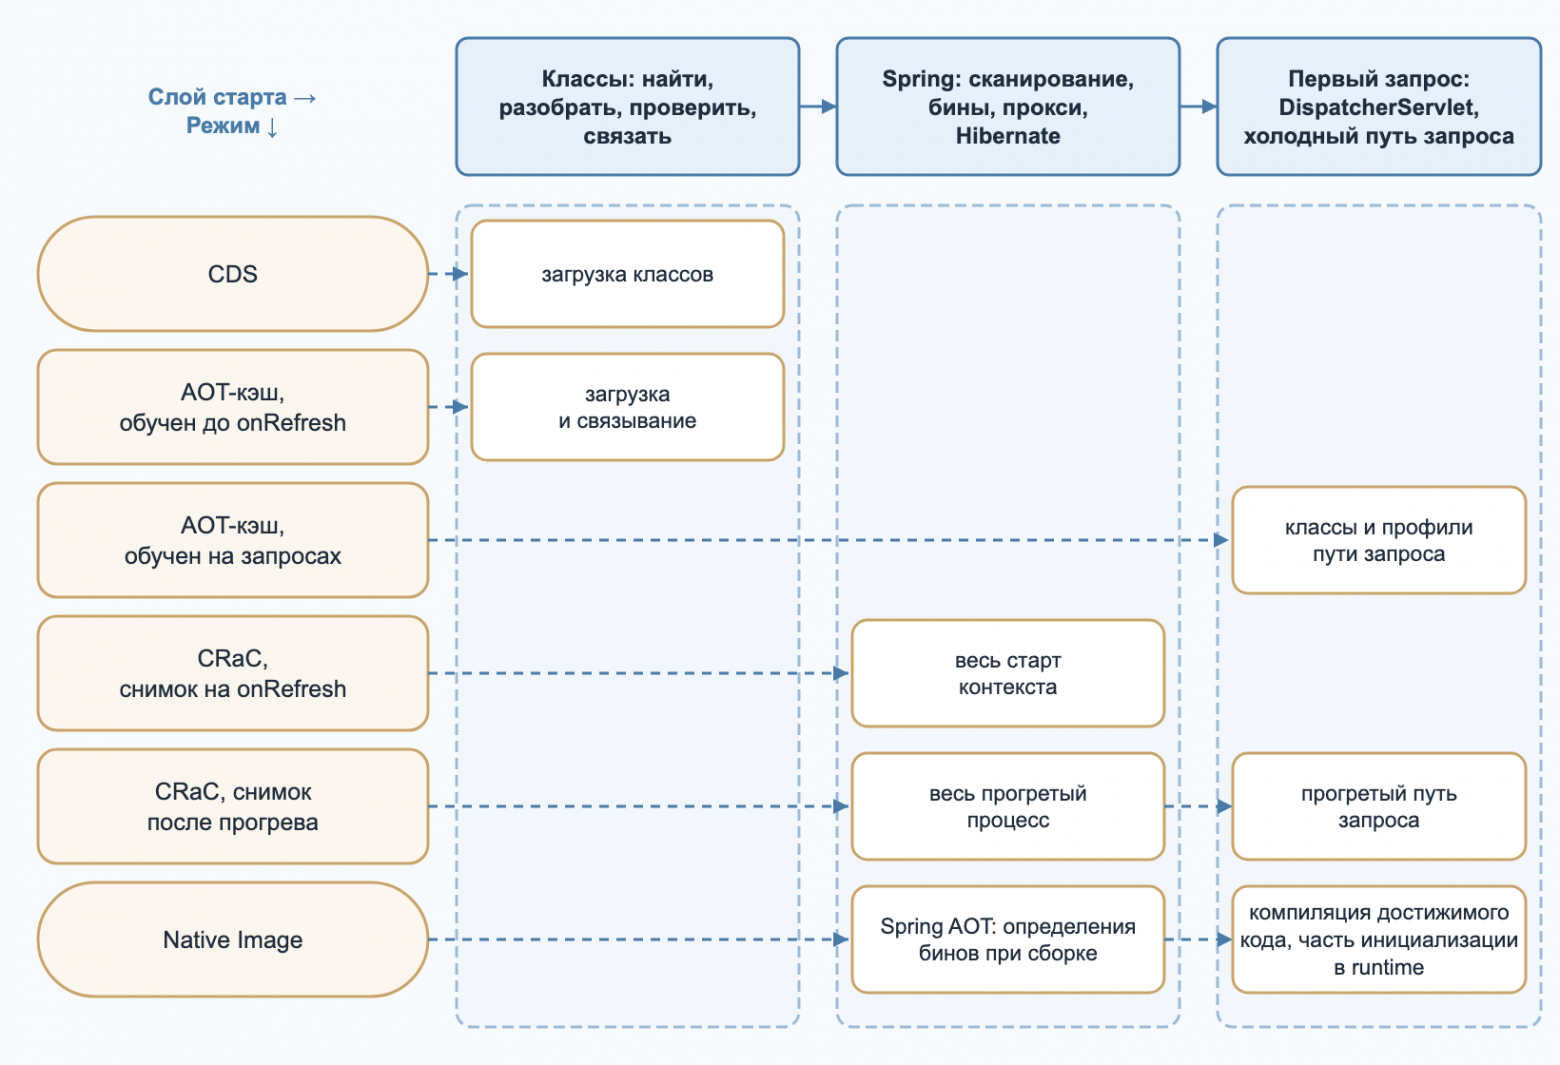
Главная мысль схемы: режимы не соревнуются в одной дисциплине. Первый запрос выполняется во всех режимах, разница в том, сколько его работы подготовлено заранее: aot-train хранит классы и профили пути запроса, crac-warm восстанавливает уже прогретый процесс, native компилирует достижимый код при сборке. Остальные режимы платят за отложенную работу на первом обращении.
Стенд
Объект разбора намеренно скромный: сервис на Spring Boot 4.1.2 с web, Spring Data JPA, H2, validation и actuator. Одна сущность, один репозиторий, один контроллер GET /products.
Метрики:
до первого 200: от запуска процесса до первого успешного ответа на
GET /products, клиент на той же машине через loopback. Это не время прохождения readiness‑пробы;первый успешный и второй GET: длительность запроса на стороне клиента, вместе с loopback и чтением ответа, а не время работы контроллера;
Started / Restored: число из строки лога Spring:
Started,Restoredили, дляcrac-warm, перезапуск жизненного цикла после восстановления. События разные, поэтому колонка вспомогательная;RSS процесса после двух успешных GET, в МиБ.
Каждый режим запускается семь раз, в таблицу идёт медиана, разброс min/max лежит в README репозитория. Все режимы гоняются подряд в одном задании CI на ubuntu-24.04 (AMD EPYC 9V45, 4 CPU, 15,6 GiB). Куча везде ограничена -Xmx256m, остальную память процесса этот флаг не ограничивает.
Режимы запускаются так (для компактности в листинге опущен -Xmx256m, он передаётся во всех запусках и при подготовке снимков):
# распакованный jar нужен для CDS и AOT-кэша
java -Djarmode=tools -jar app.jar extract --destination app && cd app

# CDS: обучающий запуск до onRefresh, затем запуск с архивом
java -XX:ArchiveClassesAtExit=app.jsa -Dspring.context.exit=onRefresh -jar app.jar
java -XX:SharedArchiveFile=app.jsa -jar app.jar

# AOT-кэш (JDK 25): тот же обучающий запуск, другой флаг
java -XX:AOTCacheOutput=app.aot -Dspring.context.exit=onRefresh -jar app.jar
java -XX:AOTCache=app.aot -jar app.jar

# CRaC: снимок на onRefresh и восстановление
java -XX:CRaCEngine=warp -XX:CRaCCheckpointTo=cr -Dspring.context.checkpoint=onRefresh -jar app.jar
java -XX:CRaCEngine=warp -XX:CRaCRestoreFrom=cr

# CRaC после прогрева: сервис работает, снимок по команде
java -XX:CRaCEngine=warp -XX:CRaCCheckpointTo=cr-warm -jar app.jar &
jcmd <pid> JDK.checkpoint

# Native Image
mvn -Pnative native:compile && ./target/app
Режимы aot-train и crac-warm обучаются на синтетическом сценарии: 300 последовательных GET /products.
Сценарий проверяет прогрев одного пути запроса и не заменяет продовую нагрузку. Движок CRaC — warp: ему не нужны права root, поэтому он работает и в обычном контейнере.
Восстановленный процесс у него получает новые PID и TID, на них нельзя полагаться в мониторинге и в состоянии приложения.
Что получилось
Режим | Started / Restored, с | До первого 200, мс | 1-й успешный GET, мс | 2-й GET, мс | RSS, МиБ |
|---|---|---|---|---|---|
jvm | 3,21 | 3714 | 299 | 6,6 | 279 |
cds | 1,71 | 2148 | 269 | 7,5 | 346 |
aot | 1,21 | 1718 | 265 | 7,2 | 340 |
aot‑train | 1,14 | 1451 | 43 | 11,4 | 321 |
crac | 0,095 | 399 | 331 | 6,4 | 250 |
crac‑warm | 0,044 | 62 | 18 | 4,6 | 213 |
native | 0,118 | 164 | 37 | 1,0 | 198 |
Среды: Temurin 25.0.5, Zulu 25.0.4.1 с CRaC, GraalVM 25.0.4. На другом раннере CI обычный JVM поднимался за 5,1 секунды при том же порядке режимов, так что «три секунды» из заголовка — скорее нижняя граница.
Дальше пять наблюдений, каждое из которых меня так или иначе удивило.
Наблюдение 1. Половину старта отдают без изменения кода
В этом эксперименте AOT‑кэш сократил время до первого 200 примерно на две секунды, с 3714 до 1718 мс. В коде приложения не поменялось ни строчки. CDS он обгоняет (1718 против 2148 мс) потому, что хранит классы не просто прочитанными, а уже связанными.
Это JEP 483 из JDK 24. JEP 514 из JDK 25 упростил создание кэша: вместо двух команд достаточно одной с -XX:AOTCacheOutput, а обучающий прогон и сборку кэша JVM запускает сама. Сборка идёт отдельным процессом со своей кучей того же размера, так что на этом шаге CI нужна примерно вдвое большая память под кучу.
Цена в сборке. JEP 483 требует, чтобы все запуски шли на той же версии JDK, той же архитектуре процессора и той же ОС, а classpath совпадал с обучающим в том же порядке или только дополнялся в конце.
Метки времени jar между обучающим и рабочим запуском тоже должны сохраниться, поэтому после создания кэша библиотеки в образе не трогают. Сборщик мусора может отличаться, кроме ZGC: в JDK 25 AOT‑кэш с ним не работает, это снял JEP 516 в JDK 26. Значит, кэш пересобирается при обновлении зависимостей, базового образа или JDK, а для образа под amd64 и arm64 нужно два кэша.
Я бы делал это в том же Dockerfile, где собирается образ: обучающий запуск в отдельном слое, кэш рядом с jar.
Наблюдение 2. Кэш помнит только то, что видел
Это наблюдение для меня главное. Режимы aot и aot-train стартуют почти одинаково, 1718 и 1451 мс. Зато первый запрос у них отличается в шесть раз: 265 мс против 43.
Объяснение в том, на чём кэш учился. Документация Spring Boot предлагает обучающий запуск с -Dspring.context.exit=onRefresh: контекст поднялся, и процесс сразу выходит. Путь запроса в такой кэш не попадает: первый успешный запрос на стенде догружает ещё 1 221 класс, а второй ни одного.
С JDK 25 в кэш попадают и профили методов (JEP 515): JIT получает их сразу и не начинает профилирование с нуля, но только для методов, которые работали при обучении. Какая доля выигрыша приходится на классы, а какая на профили, этот стенд не разделяет.
Практический вывод: в кэш попадает только то, что затронул обучающий прогон. Мой вариант, который я бы предложил для CI: поднять сервис с
-XX:AOTCacheOutput, прогнать по нему интеграционные или smoke‑тесты основных пользовательских путей и остановить.
Наблюдение 3. CRaC быстрее всех встаёт и медленнее всех отвечает, пока снимок холодный
По логу Spring восстановление CRaC заняло 95 мс. Это примерно в 34 раза меньше, чем Started у обычного JVM. Но пользователь не получит ответ через 95 мс: до первого 200 прошло 399 мс, а сам первый запрос шёл 331 мс, дольше, чем у любого другого режима.
Причина та же, что во втором наблюдении. Снимок сделан на onRefresh, до первого запроса, и весь путь запроса для восстановленного процесса холодный.
Похожий урок есть в открытых источниках. 28 ноября 2022 года AWS представила Lambda SnapStart. Это снимок всей среды выполнения функции на уровне платформы, а не CRaC внутри Lambda, хотя хуки до снимка и после восстановления в Java‑рантайме реализованы через API org.crac.
В анонсе Джефф Барр показал функцию на Spring Boot, у которой холодный старт сократился с более чем шести секунд до менее чем 200 мс. А в документации к SnapStart AWS советует прогревать код до снимка.
В их примере pet store инициализатор собирает синтетический AwsProxyRequest для GET /pets и передаёт его прямо в обработчик через handler.proxy(req, ctx), без сетевого запроса.
Я проверил тот же приём на CRaC. Режим crac-warm делает снимок после 300 запросов командой jcmd <pid> JDK.checkpoint. Результат: 62 мс до первого 200 и 18 мс первый запрос.
Это быстрее native‑образа по обоим показателям, но второй запрос у native по‑прежнему быстрее, около 1 мс против 4,6. Выигрыш CRaC относится к первому обращению, а не к скорости обработки запросов в целом.
По дороге стенд показал, почему снимок — вопрос не только скорости. Перед снимком Spring закрывает соединения пула Hikari, а H2 в памяти по умолчанию удаляет базу вместе с последним соединением.
После восстановления сервис отвечал 500 Table "PRODUCT" not found.
Помог DB_CLOSE_DELAY=-1 в адресе базы. В реальном сервисе на это место встают соединения с базой и брокером, кэши и сгенерированные до снимка идентификаторы: после восстановления их нужно проверить.
Наблюдение 4. Кэш ускоряет, но память растёт
Я ожидал, что CDS и AOT‑кэш снизят память, ведь документация Spring Boot пишет, что AOT‑кэш может сократить и время старта, и потребление памяти. RSS вышел на 40–70 МиБ больше, чем у обычного JVM: 346 и 340 МиБ против 279.
RSS учитывает резидентные страницы процесса вместе с общими, в том числе страницы архива. Если на машине несколько экземпляров сервиса, сумма их RSS завышает потребление: общие страницы засчитываются каждому.
Для доли процесса в общей памяти полезнее PSS. А запас до лимита памяти pod считает cgroup контейнера (memory.current и memory.stat в cgroup v2), туда попадает не только куча и не только RSS.
Поэтому после включения кэша стоит посмотреть на метрики памяти контейнера, а не сравнивать два числа RSS.
Наблюдение 5. Native — минимум памяти и самая долгая сборка
В этом стенде native‑образ показал минимальную память (198 МиБ) и самый быстрый второй запрос, около миллисекунды. По времени до первого ответа его обогнал только прогретый снимок CRaC. Сборка образа заняла около десяти минут на раннере CI против двадцати секунд у jar.
Первый запрос у native идёт 37 мс против 1 мс у второго. В Spring Boot native‑сборка состоит из двух этапов AOT. Сначала Spring анализирует конфигурацию, формирует определения бинов и генерирует код и hints, затем GraalVM анализирует достижимый код и компилирует executable. Сами бины, ApplicationContext и часть операций первого обращения по‑прежнему создаются при запуске.
Был и эпизод с classpath. Первый native‑образ стенда упал при старте с IllegalStateException: Unable to locate closeConnectionExecutor for HikariPool. Spring Boot видит org.crac и регистрирует для Hikari интеграцию со снимками, которая обращается к внутренностям пула через reflection. В native‑сборке это потребовало исключить зависимость: org.crac со scope test в профиле native. Это не общая проблема Native Image, но хороший пример того, почему состав classpath и runtime hints проверяют на реальной native‑сборке.
Ограничения
Сервис маленький, у сервиса с сотнями бинов абсолютные цифры будут другими. Долю выигрыша нужно мерить на своём сервисе.
Время подготовки AOT‑кэша и снимка CRaC в таблицу не входит: сравнивается запуск уже готовых артефактов. У native отдельно названа сборка.
Мерился холодный старт и первые запросы. Выход на пиковую производительность здесь не меряется.
Для CRaC и native используются свои дистрибутивы JDK. Это сравнение практических вариантов развёртывания, а не одного рантайма с разными флагами.
Режимы идут подряд на одной машине, обучающие прогоны читают тот же jar. Замеряется холодный процесс, но файловый кэш ОС может быть прогрет.
Поддержка CRaC зависит от JVM и платформы: в Zulu полноценный checkpoint/restore есть на Linux x64 и ARM64. Снимок содержит всю память процесса, секреты туда попадать не должны.
JEP 544, AOT‑компиляция кода в кэш, нацелен на JDK 28, которая пока не вышла.
Что выбрать
Порядок вопросов при выборе собрал на схеме:
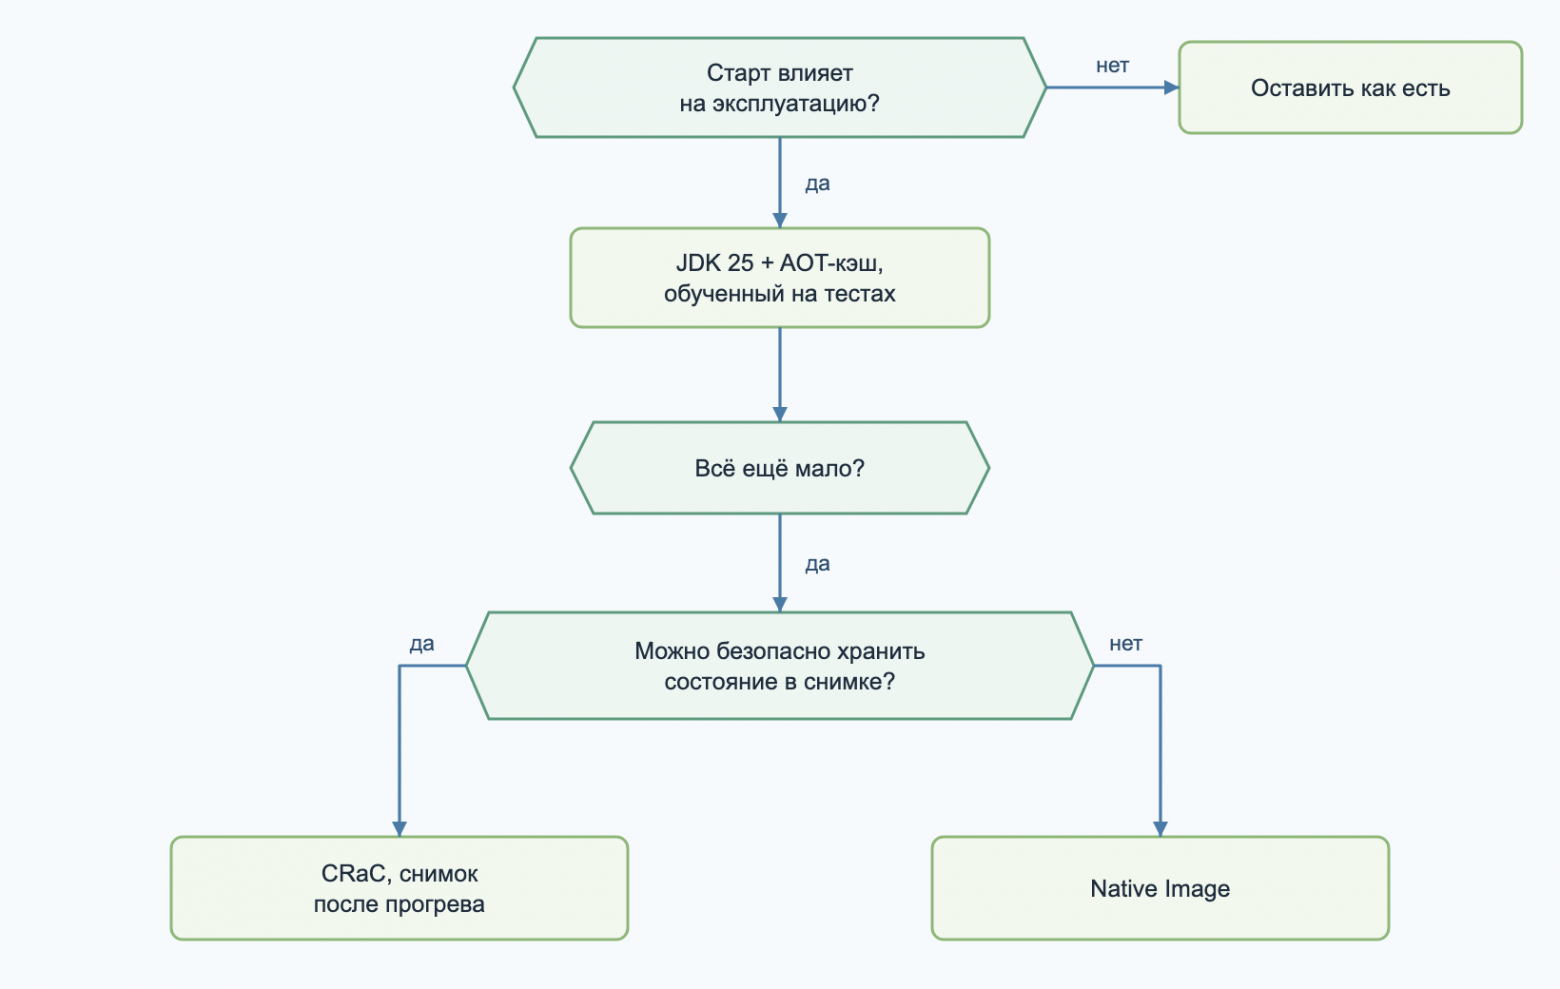
Если время старта влияет на эксплуатацию, я бы начинал проверку с AOT‑кэша: из рассмотренных вариантов он наименее инвазивен.
Включать его без замеров не стоит: нужно сравнить выигрыш со стоимостью обучения в сборке и ростом памяти.
CRaC и native — решения уровня архитектуры выката: их берут, когда секунды старта стоят денег и команда готова сопровождать снимки или native‑сборку с её hints.
Если хотите проверить у себя, начните с двух замеров вместо одного: время до первого ответа и длительность первого запроса.
Строка Started … in X seconds показывает только первое, а пользователи чувствуют второе.
Начать стоит с README.md: там таблица этой статьи с разбросом по каждому режиму и ссылка на прогон CI по коммиту 7d32d69, которым сняты цифры.
Как готовится каждый режим и что меряется, видно в bench.py, подсчёт классов делает count_classes.py, ожидаемый порядок режимов лежит в expected.txt, а весь прогон запускается командой ./run.sh.
Бывает, что приложение запускается за доли секунды, но первый пользовательский запрос всё равно заставляет ждать. А под нагрузкой могут проявиться и другие узкие места, которые не видны при обычном запуске.
Если хотите глубже разобраться в поведении Java‑сервисов, обратите внимание на бесплатные открытые уроки:
16 ноября, 20:00. «Мигрировали на Java 25 и Spring Boot 4 — всё зелёное. Почему система всё равно сломана?». Записаться
30 ноября, 20:00. «Почему Java‑сервис тормозит: пулы и виртуальные потоки на нагрузочном тесте». Записаться
Другие открытые уроки OTUS по разработке и не только собраны в ноябрьском дайджесте.

Комментарии 0