Пациент
Когда я пришёл в проект, меня встретил Java-монолит: около 2000 классов, 120 тысяч строк кода и очень много сложной бизнес-логики. Его шесть лет писала команда из двух–пяти человек, и, судя по коду, о понятии технического долга никто в компании не слышал.
Примерно за полгода до моего прихода команда начала работать с Copilot, а потом перешла на Claude Code. Тесты в проекте появились только вместе с Claude, но их было мало. Позже выяснилось, что и те толком ничего не проверяли.
Условия были такие: мне разрешили обоснованно менять в проекте что угодно, но останавливать выкатку новых фич ради этого никто не собирался. То есть чинить двигатель предстояло на ходу.
Даже беглый осмотр сразу показал несколько критичных проблем. О части из них команда знала. С другой частью люди боролись, но сами толком не понимали, с чем именно. Поэтому заплатки накладывались в разных местах без всякой системы.
Пара недель диагностики
Первые пару недель я не чинил, а изучал. Claude составлял отчёты по отдельным аспектам проекта, а я их внимательно читал. Не все темы пришли в голову сразу: многие вопросы появлялись по мере того, как я углублялся.
В итоге отчёты покрыли такие темы:
работа с денежными суммами
безопасность и публичные точки доступа API
процедуры корректной остановки
организация CI/CD
покрытие и устройство тестов, интеграционные тесты, политика использования заглушек (моков)
многопоточность: пулы потоков, блокирующий код
неизменяемые (immutable) структуры данных
работа с внешними HTTP-сервисами и создание HTTP-клиентов
конфигурация и значения, зашитые в код
работа с БД
даты, время и таймзоны
что и где кэшируется
взаимодействие с клиентской частью
логирование
политика возврата null
мониторинг событий
персональные данные: где храним и как чистим
По многим темам Claude параллельно проверял и каталог клиентской части. Отчёты я складывал в наборы документов в формате OKF (https://okf.md/): отдельный для серверной части и отдельный для клиентской.
Почему ревью кода не спасает
Большую часть ревью кода я сразу забрал на себя и быстро увидел главную проблему. Claude, несмотря на любые инструкции, писал плохой код, потому что опирался на практики, уже принятые в проекте. Такого кода в репозитории было гораздо больше, чем «правильного», и модель честно писала как у человеков тут принято.
Автоматические ревью разбухали и всё равно пропускали многие проблемы. К тому же, у многих багов причина была архитектурной, и узкий пул-реквест с новой функциональностью в своих рамках ничего серьёзно исправить не мог. Нужны были правила, которые жёстко проверяются машиной, а не пожелания в промпте.
Роль сотрудников
Ревью постоянно заваливали сообщениями о страшных критических багах и о необходимости покрыть тестами всё более экзотические узкие места системы и крайние случаи входных данных.
Если вы не знаете, как на самом деле работает бизнес за кодом, можно тут же броситься всё это исправлять. Но гораздо лучше сначала запросить поиск по базе уже имеющихся баг-репортов и поговорить с коллегами (я ведь надеюсь, их ещё не уволили под предлогом внедрения ИИ?) о том, насколько реальны такие случаи на практике. Возможно, эти ситуации возникают крайне редко или не возникают вообще, и тогда не стоит сразу исправлять то, что уже работает.
Архитектурные тесты
Первой линией обороны стал ArchUnit, у этой библиотеки есть аналоги и для других языков помимо Явы. В целом важна сама идея, а реализовать её можно везде.
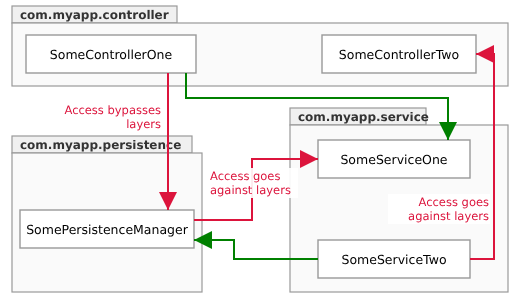
Архитектурные тесты в первую очередь навязали чёткую слоистую архитектуру (возможно, когда-то она и была в этом проекте, но давно была разрушена хаотичным добавлением кода):
никаких циклических зависимостей;
никаких вызовов из нижних слоёв в верхние;
никаких обращений к БД из контроллеров и сервисов;
никаких вызовов сервисов из бизнес-слоя.
Исправить всё сразу было невозможно даже в рамках одного аспекта, а новый код приходил каждый день. Поэтому каждый архитектурный тест получил статический сгенерированный базовый список исключений: существующие классы и методы, на которые он не срабатывает. Старый код живёт как жил, но любая новая попытка нарушить правила ломает сборку. Для агента это работает лучше любой инструкции: падающий тест нельзя «забыть».
Ещё больше запретов
Поверх слоёв появились точечные правила, каждое под конкретную болезнь проекта.
Неизменяемость (immutability). Изменяемым структурам данных объявили войну. Запустили постепенную миграцию на Java records, а создание новых изменяемых DTO запретили архитектурным тестом.
Разделение перегруженных сервисов. Пару огромных сервисов сначала освободили от прямого доступа к БД. Затем их разделили на части, выделив чистую доменную логику. Ранее почти любой PR проекта что-то менял в одном из этих двух сервисов, постоянно возникали конфликты. (кстати, если вы привыкли не глядя исправлять серьезные конфликты сеточкой, вы рано или поздно встретите случай, когда ассистент перепутал стоящие рядом строки или что-то подобное, если не повезёт, такой код даже соберется, и вам остаётся только надеяться, что его поймают тесты)
Никаких DTO из БД наружу. Отдельный запрет касался утечки DTO базы данных с внутренними состояниями и персональными данными к клиентам. Новый код обязан создавать отдельные DTO с тем, что нужно клиенту, а не со всем, что лежит в базе. Перед этим GraphQL-схему заморозили, чтобы рефакторинг незаметно не сломал контракт с клиентской частью.
Тесты: с 700 до 6800
Я уже давно заметил: люди считают, что модели отлично пишут тесты без всяких дополнительных усилий, ведь это даже легче, чем писать код! Увы, по умолчанию модели пишут тесты не особенно хорошо. (полагаю, большая часть тестов в публичных репозиториях, на которых они учились, изначально была написана так себе — кто из нас любит их писать?) Если вы слепо полагаетесь на такие тесты, вас ждёт множество сюрпризов.
За первые два месяца моей работы число тестов выросло с 700 до 6800. Чтобы это были настоящие тесты, а не декорация, я написал для модели подробное руководство: как правильно писать тесты (интеграционные сквозные тесты через все слои приложения, с использованием настоящей БД и кэшей) и как проверять, что тесты чего-то стоят (мутационные проверки на падение тестов).
Во время всех этих исследований Claude находил множество багов. Часть приходилось чинить на месте, остальные оформлялись как задачи в трекере для дальнейшего разбора. Важное правило: тесты всегда фиксировали текущее поведение, даже ошибочное, но помечали такие места для будущего решения. Так сетка тестов защищала от случайных изменений, а исправление бага становилось осознанным решением.
У роста тестов есть цена — время сборки, а GitHub Actions стоят денег. Поэтому раз в две недели запускалась задача по анализу быстродействия тестов, и каждый раз находилось что исправить (ненужные моки, задержки ожидания и т.д.). Без этого время сборки быстро вышло бы из-под контроля. Попутно пришлось решить пару интересных инфраструктурных задач: собственную очередь слияния (merge queue) и собственные раннеры GitHub Actions.
И ещё один урок: в вывод тестов надо время от времени заглядывать. Все тысячи тестов могут проходить и при этом выдавать 15 МБ предупреждений, которых никто не видит. Эти предупреждения сигналят о реальных проблемах и, вдобавок, замедляют сами тесты. Поэтому полный вывод всех тестов стоит периодически отдавать на разбор модели.
Искать причины, лечение симптомов не работает
Со временем стало видно, что одни и те же проблемы в коде и одни и те же находки ревью кода повторяются снова и снова. Исправлять их по одной — значит бесконечно устранять симптомы по одному.
Поэтому я сделал навык Claude, который объединяет встроенные в Claude code-review и simplify и работает в три шага:
Собирает найденные проблемы.
Группирует их по классам.
Для каждого класса ищет архитектурную причину.
В результате ревью выдаёт не список симптомов, а высокоуровневую причину. А её уже можно устранить и закрепить очередным архитектурным тестом.
Что из этого следует
Агент пишет так, как уже написан проект. Пока плохого кода больше, чем хорошего, инструкции и ревью его не переубедят.
Сначала карта болезни, потом лечение. Пара недель системных отчётов по аспектам превратила разрозненные симптомы в понятный список болезней.
Правила должны жестко исполняться. Архитектурный тест с базовым списком исключений позволяет принять правило сегодня, не дожидаясь, пока исправят весь старый код.
Рефакторинг без остановки фич возможен, если новому коду запрещено ухудшать ситуацию, а старый мигрирует постепенно.
Тесты фиксируют поведение, а не желания. Даже ошибочное поведение сначала закрепляется и помечается, а меняется осознанно.
Скорость сборки — постоянная работа, а не разовая оптимизация.
Искать причины. Повторяющиеся находки в ревью это повод найти архитектурную причину и закрыть её правилом.
Иначе говоря, чтобы AI-ассистент писал хороший код в плохом проекте, нужно не уговаривать его, а менять среду, в которой он работает.
И напоследок: в большом живом проекте у вас никогда не будет кнопки «сделать хорошо». Придётся читать архитектурные отчёты, понимать, о чём идёт речь и насколько серьёзен каждый выбор. Если что-то непонятно — спрашивать у модели. А потом принимать решения самому.

Комментарии 0