Если вы хоть раз пытались разобраться в теореме Байеса самостоятельно, то наверняка сталкивались с одним из трех подходов в обучающих материалах.
Первый подход - сухая академическая научность. На вас сразу обрушивают строгое аксиоматическое определение, условные вероятностные пространства и громоздкие доказательства. Осилить такой материал без помощи преподавателя или живого консультанта практически невозможно - собственно, на это и рассчитано классическое вузовское образование.
Второй подход - крайнее упрощение из популярных роликов в интернете. Авторы берут один стерильный, оторванный от реальности пример (чаще всего про редкую болезнь и тест с точностью 99%) и за пять минут показывают, куда и какие цифры нужно подставить. Вся суть сводится к механической арифметике: возьми готовые проценты из условия, перемножь, раздели и получи красивый ответ.
Третий подход - интеллектуальное самолюбование автора. В таких статьях и видео создатель контента не столько учит читателя, сколько демонстрирует собственную эрудицию: “посмотрите, как изящно я это понял и какую хитрую задачу сумел решить”.
Все три подхода, при всей их внешней разнице, приводят к одному и тому же печальному итогу. Обучающийся получает жесткую установку: теорему нужно просто запомнить. Нужно вызубрить саму формулу, заучить названия ее параметров, запомнить пару типовых шаблонов, а дальше - пытаться решить реальную задачу применяя шаблон, который максимально похож на задачу. По сути, человеку предлагают действовать по наитию, превращаясь в своего рода художника, который должен интуитивно, “на кончиках пальцев” чувствовать границы применимости формулы.
Но в реальной аналитике и бизнесе интуиция художника стоит дорого - каждая ошибка оборачивается потерянными деньгами или неверными управленческими решениями. Когда вы сталкиваетесь с живыми данными, никто не выдает вам готовые проценты на блюдечке. Главная сложность заключается не в том, чтобы правильно разделить числитель на знаменатель, а в том, чтобы понять, откуда вообще брать цифры, какую группу людей анализировать и какой вопрос мы на самом деле задаем.
Именно поэтому лучшее обучение теореме Байеса должно начинаться не с математики, а с методологии - с понимания того, как устроена задача и как формируется выборка данных. Давайте разберем этот подход на практике, начиная прямо с вас.
Отсеим зевак
Прежде чем мы начнем, давайте проведем небольшой эксперимент прямо на вас. Эта статья написана не для тех, кто ищет быструю шпаргалку перед экзаменом, а для тех, кто хочет научиться принимать решения на основе реальных данных.
Представьте, что эту статью открыли 1000 случайных пользователей интернета. Сколько из них дочитают ее до конца? Допустим, всего 5% - это те, кто изначально глубоко интересуется аналитикой. Но если вы прямо сейчас читаете этот абзац и внутренне соглашаетесь с тезисом “я хочу научиться принимать решения на основе реальных данных”, ваша личная вероятность дочитать до конца уже гораздо выше - скажем, 60%. Теперь спросите себя, почему когда дело касается именно вас вероятность дочитать статью до конца увеличивается с 5% до 60%? Почему оценка так сильно изменилась? Потому что мы сузили круг наблюдения. Мы перешли от абстрактных “людям, которым интересны инструменты анализа” к конкретной группе - “людям, которые хотят научиться их использовать”.
Поздравляю, вы только что увидели работу теоремы Байеса в реальной жизни.
Теорема Байеса
То, что мы только что проделали с аудиторией этой статьи - сузили широкий круг читателей до заинтересованной группы и пересчитали шансы на дочитывание, - в математике записывается в виде одной короткой формулы. Она не содержит никакой магии и служит лишь компактным способом зафиксировать нашу логику работы с данными.
Чтобы перевести нашу логику на язык математики, сначала зафиксируем фундамент любого расчета - выборку, а затем введем два базовых обозначения, которые имеют смысл только внутри нее:
Выборка (Контекст наблюдения) - конкретная группа людей, событий или объектов, внутри которой мы проводим исследование (например, “читатели этой статьи”). Гипотеза не существует в вакууме: она всегда сформулирована строго для этой выбранной группы. Поменяется выборка - изменится и смысл самой гипотезы, и все стартовые цифры.
 (Гипотеза) - наше проверяемое предположение об объектах внутри выбранной группы (например, “читатель дочитает статью до конца”).
 (Уточняющий признак) - конкретный наблюдаемый параметр или условие, которое мы фиксируем в данных для сужения исходной выборки (например, “читатель хочет научится использовать инструменты анализа”).
Главный смысл всей формулы Байеса - измерить влияние одного конкретного уточняющего признака внутри выборки на итоговую вероятность гипотезы , то есть найти  .
Если говорить строго формально, формула выдает итоговую вероятность гипотезы с уже учтенным влиянием этого признака. Но если мы сравним несколько расчетов с разными признаками, то увидим, какой из них сильнее всего сдвигает результат. Это открывает широкие возможности для практики: подбор уточняющего признака неизбежно возвращает нас в самое начало - к переосмыслению и уточнению самой выборки.
Именно в этом и состоит настоящая работа аналитика: в поиске того самого признака, который лучше всего решает поставленную задачу. Поняв эту механику, вы можете с уверенностью сказать, что действительно понимаете теорему Байеса - а не просто помните ее и умеете подставлять абстрактные цифры в дробь.
Теперь соберем саму формулу Байеса:
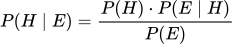
Переведем каждый элемент с языка математики на язык работы с данными:
 - Априорная вероятность (База). Это наш стартовый прогноз, который целиком определяется выборкой. Какая доля объектов в выбранной нами группе соответствует гипотезе () сама по себе - еще до того, как мы применили уточняющий признак ()?
Например: доля читателей дочитавших статью до конца.
 - Правдоподобие (Связь признака и гипотезы). Как часто наш уточняющий признак () встречается среди тех, для кого гипотеза () точно верна?
Например: как часто среди тех, кто дочитал статью до конца, встречаются люди, заинтересованные в обучении анализу данных.
 - Распространенность признака (Общий фон). Как часто этот уточняющий признак () вообще встречается во всей нашей исходной выборке - и среди тех, для кого гипотеза верна, и среди всех остальных? Без этого знаменателя мы не поймем, насколько уникален наш признак, встречается он лишь у нескольких читателей или он есть у каждого второго.
Например: доля всех читателей заинтересованных в обучении анализу, независимо дочитали они статью до конца или нет.
 - Апостериорная вероятность (Итог). Пересчитанная вероятность нашей гипотезы после того, как мы отфильтровали исходную выборку по уточняющему признаку ().
Например: доля читателей заинтересованных в обучении анализу дочитавших статью до конца.
Байес на практике: где проходит граница применимости и как это работает в жизни
Суть теоремы Байеса действительно крайне проста - уточнить известную вероятность используя другую известную вероятность, так называемый уточняющий признак. Сложность этой теоремы состоит исключительно в правильном подборе её параметров.
В большинстве учебников и роликов в интернете вам сразу вываливают дробь с непонятными буквами и готовыми числами “из вакуума”. Но в реальности формула - это лишь финальный калькулятор. Вся настоящая аналитическая работа происходит задолго до нее и строится вокруг двух базовых понятий: правильной постановки задачи и формирования выборки.
Прежде чем бросаться применять формулу ко всем подряд задачам, нужно усвоить одно жесткое ограничение: если у вас есть база данных, где зафиксированы и причины, и следствия для всей выборки, теорема Байеса вам не нужна.
Например, если вы владелец интернет-магазина и хотите узнать, какая доля пользователей, проведших на сайте больше 10 минут, в итоге купила товар, вам не нужно вычислять сложные условные вероятности. Достаточно выгрузить данные пользователей из CRM и счетчики посещаемости из статистики сайта, отфильтровать нужные строки и поделить одно число на другое. Использовать формулу Байеса там, где все данные лежат на “расстоянии вытянутой руки” - все равно что забивать гвозди микроскопом.
Формула Байеса становится по-настоящему незаменимой в жизни только при структурном разрыве данных - когда у вас физически нет единой таблицы, объединяющей скрытое состояние объекта и его внешние признаки.
Это происходит в двух реальных ситуациях:
Невозможность прямого измерения в потоке. Вы видите только косвенный внешний признак здесь и сейчас, но не можете заглянуть внутрь объекта, не разрушив его или не потратив слишком много ресурсов.
Объединение данных из независимых источников. Базовую частоту явления вы знаете из общей макростатистики, а поведение при наличии гипотезы - из закрытых расследований, тестов или прошлого опыта.
Разберем три жизненных примера из разных сфер, где прямой сбор статистики невозможен, а формула Байеса позволяет принять точное решение за счет правильного выбора группы и уточняющего признака.
Пример 1: Бытовая экономика. Покупка подержанного автомобиля
Почему нельзя просто посмотреть статистику: На рынке нет единой открытой базы всех автомобилей с честной отметкой “пробег скручен”. Вы не можете собрать таблицу всех машин в городе и напрямую посчитать процент обмана. Зато у автоподборщиков есть статистика по уже выявленным случаям скрутки, а у вас - визуальный осмотр конкретной машины.
Цель и правило решения: Стоит ли платить 5 000 рублей за выездную диагностику с эндоскопом и проверкой по закрытым базам перед покупкой? Если вероятность скрученного пробега выше 50% - отказываемся от осмотра сразу и экономим деньги.
Гипотеза (
): у автомобиля скручен пробег.Уточняющий признак (
): водительское сиденье и руль сильно затерты (визуально не соответствуют заявленным 60 тыс. км). Из практики подборщиков известно, что при реальной скрутке пробега салон выдает возраст в 80% случаев (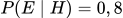 ).
Посмотрим, как меняется решение при смене выборки:
Выборка А: Машины от первого владельца с подтвержденной сервисной книжкой. Здесь базовый риск скрутки низок -
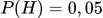 (5%), а потертый руль среди всех таких машин встречается редко -
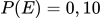 (10%) (например, владелец носил грубые перчатки или много стоял в пробках).
Подставляем в формулу:
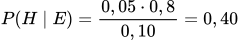 (или 40%)
Решение: Риск вырос до 40%, но все еще ниже нашего порога в 50%. Машина в целом надежная, имеет смысл потратить 5 000 рублей на глубокую диагностику.
Выборка Б: Машины от перекупщиков без истории обслуживания. В этой группе базовый риск обмана совсем другой -
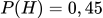 (45%), а потертый руль встречается в 40% объявлений (
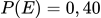 ).
Считаем:
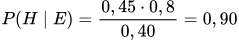 (или 90%)
Решение: Вероятность обмана составляет 90%. Тратить деньги на выездного эксперта бессмысленно - проще сразу закрыть объявление.
Пример 2: Инженерный кейс. Контроль качества на производстве
Почему нельзя просто посмотреть статистику: На конвейере нельзя вскрыть каждую герметичную упаковку или разрушить каждую деталь при проверке на прочность. Истинное качество проверяется только выборочным лабораторным тестом, но в реальном времени у инженера есть только показания внешних датчиков (вибрации, температуры, веса).
Цель и правило решения: Останавливать ли конвейерную линию для перенастройки станка (каждая остановка приносит убытки), если сработал датчик вибрации?
Гипотеза (
): станок начал выпускать бракованную деталь.Уточняющий признак (
): датчик зафиксировал превышение уровня вибрации. На тестовых стендах инженеры выяснили, что при реальном механическом сбое станка вибрация возникает в 90% случаев (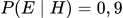 ).
Как работает смена выборки:
Выборка А: Новый станок сразу после планового техобслуживания. Базовый риск брака минимален -
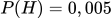 (0,5%), а общий фон ложных срабатываний датчика от внешнего шума в цеху составляет
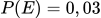 (3%).
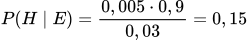 (или 15%)
Решение: Вероятность брака всего 15%. Останавливать дорогостоящий конвейер из-за единичного скачка невыгодно - продолжаем работу и усиливаем наблюдение.
Выборка Б: Станок на изношенной оснастке в конце смены. Здесь базовый риск брака возрастает до
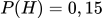 (15%), а общий фон повышенной вибрации в этой группе составляет
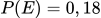 (18%).
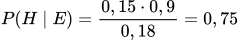 (или 75%)
Решение: Вероятность выпуска брака достигла 75%. Конвейер нужно остановить немедленно, иначе убытки от испорченной партии многократно превысят стоимость простоя.
Пример 3: Управление ресурсами. Фриланс и B2B-продажи
Почему нельзя просто посмотреть статистику: По входящим заявкам с сайта или биржи у вас нет сквозной аналитики рынка. Вы не знаете, кто из клиентов, с которыми вы не договорились, в итоге заказал проект у конкурентов, а кто вообще не собирался тратить деньги. У вас есть только внутренняя статистика по вашим завершенным сделкам и общие наблюдения по входящим письмам.
Цель и правило решения: Стоит ли тратить 4 часа рабочего времени дорогого специалиста на подготовку детальной сметы и прототипа (стоимость часа известна)?
Гипотеза (
): заказчик реально закроет сделку и оплатит проект.Уточняющий признак (
): клиент просит составить подробный план работ и расчет уже в первом сообщении, еще до обсуждения бюджета. Из анализа прошлых закрытых сделок известно, что реальные покупатели приходят с таким запросом в 50% случаев (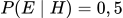 ).
Как работает смена выборки:
Выборка А: Холодные заявки с открытых бирж фриланса. Базовая конверсия в оплату здесь низкая -
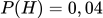 (4%), при этом просьба “сразу прислать подробный план” встречается в 25% писем (
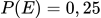 ) - многие просто рассылают шаблон двадцати исполнителям для бесплатного сбора идей.
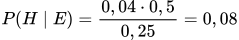 (или 8%)
Решение: Даже с учетом уточняющего признака вероятность сделки всего 8%. Тратить 4 часа на индивидуальный расчет экономически убыточно - отправляем типовой прайс-лист.
Выборка Б: Заявки по прямой рекомендации от текущих клиентов. В этой теплой группе базовая конверсия в сделку высока -
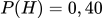 (40%), а запрос подробной сметы в первом письме встречается у 25% обратившихся () (обычно отправителю нужно срочно согласовать бюджет у руководства).
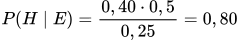 (или 80%)
Решение: Вероятность оплаты взлетает до 80%. Срочно подключаем специалиста и готовим детальное коммерческое предложение.
Что объединяет все три примера
Обратите внимание: ни в одной из этих задач мы не могли просто “открыть таблицу и посчитать”. Везде нам пришлось соединять базовый профиль группы с внешним уточняющим признаком, опираясь на историческую связь между скрытой причиной и видимым следствием. И в каждом случае решающую роль сыграла не сама дробь, а правильная нарезка исходной выборки.
Насколько правдоподобно “Правдоподобие”
Если априорная вероятность - это фундамент задачи, то Правдоподобие - это ее двигатель. И одновременно это самый сложный, самый коварный и самый важный параметр во всей теореме Байеса.
Именно здесь кроется главный подвох. В учебных задачах правдоподобие выдают как сухую константу: “точность теста 99%”. В реальной жизни у вас нет никакого “паспорта точности” для жизненных ситуаций. Вы сами должны определить, насколько тесно выбранный уточняющий признак связан с вашей гипотезой, и выразить эту связь в цифрах. Если ошибиться здесь, формула превратится в идеальный генератор самообмана.
Что можно считать реальной связью признака с гипотезой, а что - нет
Чтобы признак работал как настоящий фильтр, между ним и гипотезой должна существовать устойчивая причинно-следственная или структурная связь, а не случайное совпадение.
Реальная связь (Сигнал)
Гипотеза напрямую порождает признак или неизбежно сопровождается им. Например, в задаче с подержанным авто реальный большой пробег (который пытаются скрыть скруткой) физически “стирает” кожу на руле и “продавливает” боковину водительского кресла. В задаче со станком механический износ подшипника физически вызывает вибрацию.
Ложная связь (Шум и суеверия)
Признак возникает сам по себе и никак не зависит от того, верна гипотеза или нет. Например, если вы решите оценивать надежность B2B-заказчика по тому, отправляет ли он письмо с корпоративной почты в пятницу вечером, вы поймаете шум. И добросовестные клиенты, и пустые “сборщики идей” пишут в пятницу примерно с одинаковой частотой.
Математический критерий настоящей связи
Признак
имеет смысл только тогда, когда внутри группы “гипотеза верна” он встречается заметно чаще (или заметно реже), чем внутри группы “гипотеза неверна”. Если примерно равно  , то дробь
 превращается в единицу.
Формула Байеса просто вернет вам исходную базовую вероятность - ваш признак оказался пустышкой.
Как правильно собирать данные для оценки “Правдоподобия”
Поскольку в жизни мы почти никогда не имеем идеальной сквозной статистики, данные для приходится собирать по крупицам из ретроспективного опыта. Чтобы не исказить этот параметр, нужно соблюдать три жестких правила:
Изучать только “эталонные” подтвержденные случаи
Чтобы посчитать
, нужно взять выборку объектов, по которым истина уже известна на 100%, и посмотреть назад - в прошлое. Например, взять 100 автомобилей, у которых скрученный пробег был железно доказан диагностикой, и посчитать, у скольких из них был затерт руль. Нельзя смешивать в этой корзине подтвержденные случаи и просто “подозрительные”.Не путать направление условной вероятности
Это самая частая и фатальная ошибка новичков - подменять
на . Вопрос “Как часто при скрученном пробеге затерт руль?” и вопрос “Как часто при затертом руле скручен пробег?” - это два совершенно разных числа. Для расчета правдоподобия мы всегда встаем на позицию уже свершившейся гипотезы и смотрим, какой след она оставила.Учитывать эффект “маскировки” (адаптацию среды)
В реальном мире объекты наблюдения умеют подстраиваться. Опытные перекупщики знают, что покупатели смотрят на руль и сиденье, поэтому перед продажей они могут перешить руль за 3 000 рублей. В итоге для свежеперешитых рулей старое правдоподобие перестает работать. Аналитик обязан проверять, не устарела ли связь между признаком и гипотезой.
Главный секрет работы с “Правдоподобием”
Не пытайтесь угадать точную цифру правдоподобия из головы. В реальной аналитике этот параметр всегда выступает как инструмент калибровки. Если вы видите, что выбранный признак дает слишком размытую связь с гипотезой (например, 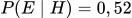 (52%) против фоновых
 (48%)), не нужно пытаться спасти расчеты сложной математикой. Нужно признать признак слабым и вернуться к поиску нового, более сильного сигнала в данных.
Три шага до того, как вы напишете первую цифру
В классических обучающих примерах логика выглядит так: даны числа А и Б, подставляем в формулу, получаем ответ. В жизни такая механистическая арифметика приводит к грубым ошибкам. Чтобы расчет имел смысл, цепочку нужно развернуть в обратную сторону.
Цель и цена ошибки. Зачем мы измеряем?
Прежде чем считать вероятности, нужно понять, какое решение мы примем по итогам расчета. Одно дело - решить, брать ли с собой зонт (цена ошибки - мокрые ботинки). Совсем другое - заблокировать банковский счет клиента по подозрению в мошенничестве (цена ошибки - потеря лояльного клиента или прямые убытки банка). Цель определяет, какую именно гипотезу мы проверяем и какой уровень уверенности нам нужен для действия.
Конкретизация гипотезы. Что именно мы измеряем?
В реальности “теории вероятностей” нет абстрактных понятий, есть только наблюдаемые факты. Нельзя проверить гипотезу “клиент лоялен” или “поставщик надежен”. Гипотезу нужно перевести на язык конкретных событий: “клиент совершит повторную покупку в ближайшие 30 дней” или “поставщик привезет груз без опозданий в этом месяце”.
Выборка как фундамент. Где мы берем данные?
Это главный слепой участок большинства обучающих видео. Авторы с легкостью говорят: “Допустим, точность теста 99%, а болеет 1% населения”. Но откуда взялся этот 1%? Это 1% среди всех жителей планеты, среди жителей вашего города или среди тех, кто уже пришел в поликлинику с высокой температурой? Гипотеза не существует в вакууме - она всегда привязана к конкретной группе наблюдений. Выборка - это окно, через которое мы смотрим на реальность. Если окно кривое, сама постановка задачи теряет смысл.
Чек-лист перед любым расчетом
Формулу Байеса легко запомнить за пять минут, но применять ее осознанно можно только при соблюдении жесткой дисциплины работы с данными.
Прежде чем подставлять числа в дробь, проверьте себя по трем пунктам:
Определена ли цель и правило решения?
Вы точно понимаете, какое действие последует при высокой или низкой вероятности и какова цена ошибки.
Корректна ли выборка?
Ваши стартовые данные собраны именно по той группе людей или объектов, к которой вы собираетесь применять выводы.
Согласованы ли критерии?
Данные для базового прогноза и данные для фиксации уточняющего признака собраны по одним и тем же правилам и без скрытых искажений.
Если ответы на эти три вопроса есть, математическая формула станет для вас точным инструментом поиска нужных сегментов и принятия решений, а не просто красивой абстракцией из учебника.

Комментарии 0