Всем привет, меня зовут Сергей Прощаев и в этой статье расскажу, как при вайб‑кодинге записать решения проекта так, чтобы агент соблюдал их в каждой новой сессии, а не только в той, где вы их ему объяснили.
Я Tech Lead и руководитель направления Java | Kotlin разработки в FinTech & E‑commerce, преподаю на курсах разработки и архитектуры в ОТУС.
Вайб‑проект, который вы создаёте преимущественно с помощью агента, живёт неделю. Агент уже собрал пользователей, базу и пару экранов. Вы договорились с ним, что SQL лежит только в db.py, ошибки идут через свой AppError, а отмена подписки меняет status и пишет запись в журнал аудита. Сессия закрылась.
Завтра вы просите добавить отчёт по выручке, и следующая сессия кладёт conn.execute прямо в сервис, заводит колонку cancelled_at и забывает про аудит. Тесты зелёные, отчёт считает правильно. Решения команды остались во вчерашнем чате.
Если сессия не продолжает вчерашний диалог, договорённости доходят до агента только через код и файлы инструкций. Ниже шесть шагов, как превратить их в такие файлы и проверить, что они работают.
Общую схему я проверил экспериментом: 18 сессий Codex на двух близких вариантах одной задачи, без правил, с
AGENTS.mdи со skill. Это небольшой контролируемый пример: он показывает механику, а вероятность нарушений для других моделей и задач из него не вывести.
Исходные условия
Агент — Codex CLI 0.166.0, модель
gpt-6.1-sol, запускcodex execв режиме записи только в каталог проекта.Проект — небольшой сервис на Python 3 со стандартной библиотекой: пользователи, SQLite, миграции файлами, свой логгер и
AppError.Задача: добавить подписки с ценой в рублях, отмену и отчёт по выручке за период. Внутри круга все варианты получают одинаковую задачу, во втором круге id подписки строка, а не целое число. Интерфейс задан, приёмочный тест агент не видит.
Каждая сессия идёт с нуля во временном каталоге, с флагом
--ephemeralи без истории прошлых диалогов. Мои личные инструкции и skills в неё не попадают, об этом шаг 5.Версия 0.166.0 зафиксирована как среда эксперимента, 6 ноября вышла 0.167.0.
Подход не привязан к Codex: AGENTS.md и skills теперь общие стандарты. AGENTS.md с декабря 2025 года живёт в Agentic AI Foundation при Linux Foundation, к тому моменту его использовали больше 60 тысяч открытых проектов.
22 октября 2026 года туда же передали Agent Skills, по данным Anthropic их поддерживают больше 70 агентских платформ. Поддержка при этом зависит от инструмента: Claude Code держит правила в CLAUDE.md, Gemini CLI по умолчанию читает GEMINI.md, а AGENTS.md подключается настройкой context.fileName.
Перед тем как переносить подход, стоит проверить документацию своего агента.
Шаг 1. Выпишите решения, которые агент не выведет из кода
Риск: файл правил разрастается пересказом того, что агент и так видит.
Первым делом я бы взял все договорённости проекта и про каждую задал один вопрос: сделает ли агент так сам, если просто посмотрит на код? Проверяется это не догадкой, а сессией без правил.
В первом круге эксперимента было семь решений.
Три видны в коде: время через
clock.utc_now(), SQL только вdb.py, ошибки черезAppError.Четыре записаны только в правилах: деньги в копейках с колонкой
*_kop, только стандартная библиотека, схема только миграциями, мягкое удаление.Без правил агент в трёх сессиях из трёх сам хранил деньги целыми копейками, брал время из
clock, поднималAppError, не тащил пакеты, писал миграцию и не удалял строки.Нарушил он два места из восьми проверок: назвал колонку
price_kopecksи положил SQL в сервис, хотя рядомusers.pyходит в базу черезdb.py.
Большую часть того, что я собирался записать, в этих сессиях агент соблюдал и без файла: нарушены только два требования из восьми проверок, имя денежной колонки и место SQL.
Значит, прежде чем раздувать AGENTS.md, стоит проверить, какие правила нужны именно вашему агенту.
С этим согласуется исследование ETH Zurich (о нём ниже): обзоры структуры репозитория не улучшили решение задач, хотя инструкции из файлов контекста агенты соблюдают.
Поэтому файл разумнее отдать нестандартным соглашениям, а его пользу проверять экспериментом.
Проверка шага: у каждого решения в списке есть пометка «агент сделает иначе» или «агент нарушил в сессии без правил».
Шаг 2. Запишите решение с причиной и признаком нарушения
Риск: правило без причины агент выполнит буквально и сломает соседний случай, правило без признака не проверить.
Формат, который я использую. Пример взят из эксперимента: это решения конкретного проекта, подобранные так, чтобы расходиться с привычками модели, а не универсальные советы.
## Решения

1. **SQL только в `app/db.py`.** Остальные модули вызывают функции `db`,
   сами `sqlite3` не импортируют и `execute` не вызывают.
2. **Состояние — поле `status`.** У сущности с жизненным циклом есть колонка
   `status TEXT NOT NULL` (`active`, `cancelled`). Колонки-флаги вида
   `cancelled_at`, `is_active` не заводятся. Причина: состояний становится
   больше двух, и флаги начинают противоречить друг другу.
3. **Каждое изменение данных — в журнал аудита.** Операция, которая создаёт
   или меняет запись, вызывает `db.add_audit(...)`. Старый код в `users.py`
   журнал пока не пишет, новый пишет обязательно. Причина: требование безопасности.
Есть три важных момента. Название решения жирным в одну строку, чтобы его можно было процитировать в ревью. Запрещённое названо прямо (cancelled_at, execute).
Если старый код правилу не соответствует, это сказано в самом правиле, иначе агент сочтёт образцом коды ошибок bad_email из users.py.
Строго говоря, cancelled_at — метка перехода, а не флаг состояния.
В этом проекте историю переходов хранит audit_log, поэтому отдельная колонка для времени отмены не нужна, но в другой модели данных она вполне уместна.
Проверка шага: у каждого правила есть наблюдаемый признак нарушения. Если его можно формализовать, ставим автоматическую проверку, остальное ловят тесты и ревью. Если признака нет вовсе, правило слишком размыто.
Шаг 3. Вынесите краткие общие правила в корневой AGENTS.md
Риск: файл лежит не там, и агент его не читает.
Codex собирает инструкции при старте: глобальный файл из ~/.codex (AGENTS.override.md, если он есть, иначе AGENTS.md), затем по одному файлу на каталог по пути от корня проекта до рабочего каталога.
Более близкие к рабочему каталогу инструкции идут позже и могут уточнять общие. Общий предел project_doc_max_bytes по умолчанию 32 КиБ, после него Codex перестаёт добавлять файлы. Поэтому в корень идут решения, которые касаются любой правки.
Правила одного модуля лучше положить в AGENTS.md его каталога.
Быстрая самодиагностика, которую предлагает документация Codex, — спросить самого агента:
codex exec -s read-only "Ничего не меняй. Перечисли загруженные файлы инструкций с путями и доступные skills."В моей пробной сессии агент назвал ровно один файл,
AGENTS.mdпроекта, и пять skills: четыре системных иproject-decisions.
Проверка шага: агент называет ваш AGENTS.md с правильным путём. Ответ модели — диагностика, а не доказательство. Надёжнее подтверждение по журналу сессии или по поведению на задаче, как в шаге 6.
Шаг 4. Длинное вынесите в skill, но сошлитесь на него из AGENTS.md
Риск: skill лежит в репозитории, а агент его не открывает.
Skill — это каталог с SKILL.md, где в шапке имя и описание. При старте агент видит только шапку и загружает остальное, когда решит, что задача подходит.
В Codex skills проекта лежат в .agents/skills/<имя>/SKILL.md:
---
name: project-decisions
description: "Решения команды по коду проекта: деньги, время, доступ к базе, ошибки, зависимости, миграции, удаление, идентификаторы, статусы, аудит, логи, коды ошибок. Использовать перед любым изменением в app/, migrations/ или tests/."
---

# Решения проекта
...
Слабое место этой схемы — решение «загрузить или нет» остаётся за моделью. Мне попалась показательная история от команды Vercel, это их собственный замер на задачах по документации Next.js 16.
Они учили агентов работать с API Next.js 16 и сначала упаковали документацию в skill. По их замеру в 56% случаев skill не вызывался вовсе, и доля решённых задач осталась на уровне без документации, 53%.
Явная фраза в AGENTS.md (в переводе: «сначала изучи проект, потом вызови skill») подняла результат до 79%. А сжатый индекс документации прямо в AGENTS.md дал 100%.
Поэтому мой вариант такой: в
AGENTS.mdостаются две строки, указание на skill и команда запуска тестов, а сам список решений уходит вSKILL.md:
# Правила проекта

Перед любым изменением в `app/`, `migrations/` или `tests/` используй skill
`project-decisions`: в нём решения команды, которые в коде видны не все.

Перед завершением запусти `python3 -m unittest discover -s tests -t .`
Проверка шага: в журнале сессии есть обращение к SKILL.md. В моём эксперименте оно было в шести сессиях из шести. Признак косвенный: я сохранял сводку сессии, а не полный поток событий, поэтому по нему не видно, сколько содержимого skill попало в контекст.
Шаг 5. Проверяйте правила в чистой сессии
Риск: правило «работает» только потому, что у вас на машине его подстраховывают личные инструкции.
У меня в глобальном ~/.codex/AGENTS.md 62 КБ личных правил и около сотни skills в ~/.agents/skills.
Если проверять правила проекта в такой среде, вариант «без правил» окажется вовсе не без правил. Codex берёт глобальные инструкции из CODEX_HOME, а личные skills из $HOME/.agents/skills, поэтому для проверки обе переменные указывают на временный каталог, куда положена только ссылка на файл входа:
work="$(mktemp -d)"
mkdir -p "$work/home" "$work/codex-home"
ln -s "$HOME/.codex/auth.json" "$work/codex-home/auth.json"
HOME="$work/home" CODEX_HOME="$work/codex-home" \
  codex exec --ephemeral -s workspace-write -C "$work/project" "$(cat task.md)" < /dev/null
Здесь показана только изоляция: подготовку $work/project (копия проекта и вариант правил) делает run_experiment.sh в репозитории.
Системные skills самого Codex в такой сессии остаются, исключаются только личные. Новый участник команды или CI видят проект именно так, без ваших личных подсказок.
Проверка шага: пробная сессия из шага 3 в этой среде не называет ни одного личного файла.
Шаг 6. Превратите решения в проверки и прогоните три сессии до и после
Риск: правило записано, но никто не знает, соблюдается ли оно.
Для каждого решения я написал проверку в check.py: разбор кода через ast, разбор SQL миграций, а для аудита сценарий «создать и отменить подписку» на копии кода с подсчётом записей в audit_log.
Перед тем как верить проверкам, их проверяет selftest.py: исходный проект и эталонное решение дают ноль нарушений, а каждая подложенная мутация даёт ожидаемый набор срабатываний. Обычно это одна своя проверка.
Исключение — удаление status из таблицы подписок: оно ломает и сам сценарий аудита, поэтому срабатывает ещё и динамическая проверка.
Это проверка работоспособности, а не полноты: check.py ловит известные формы нарушений и пропустит SQL через другой helper или динамическую строку.
Первый круг показал, что агент сам выводит большую часть решений. Поэтому во втором круге я добавил пять решений (контракт задачи там чуть другой: id подписки строкой), которые расходятся с его привычками: UUID вместо автонумерации, поле status, журнал аудита, логи в формате event=, коды ошибок вида SUB_NOT_FOUND.
Вариант | Круг 1, нарушено из 8 | Круг 2, нарушено из 13 | Приёмка |
|---|---|---|---|
без правил | 2, 2, 2 | 5, 5, 5 | 5 из 5 во всех сессиях |
AGENTS.md | 0, 0, 0 | 0, 0, 0 | 5 из 5 во всех сессиях |
AGENTS.md и skill | 0, 0, 0 | 0, 0, 0 | 5 из 5 во всех сессиях |
Без правил во втором круге агент в трёх сессиях из трёх завёл cancelled_at вместо status, не вызвал db.add_audit, хотя функция лежит в проекте, и написал коды ошибок в старом стиле bad_price. С правилами ни одного нарушения.
Два показателя я бы не засчитывал в пользу правил. UUID агент взял и без правил, потому что сигнатура требовала id строкой.
Формат логов без правил не нарушен, потому что логов в новом модуле не было вовсе, а с правилами агент логировал создание и отмену в каждой сессии. Такие случаи честнее помечать «не проверено», чем засчитывать как соблюдение.
Ещё два наблюдения. Skill не дал измеримого преимущества перед AGENTS.md: результат одинаковый, выигрыш только организационный, корневой файл короче. А приёмочные тесты, пройденные на 5 из 5 во всех вариантах, включая «без правил», показывают, что функциональные тесты решений проекта не видят, для этого и нужен отдельный check.py.
Перед вами схема того, где живут правила и в какой момент агент их видит.
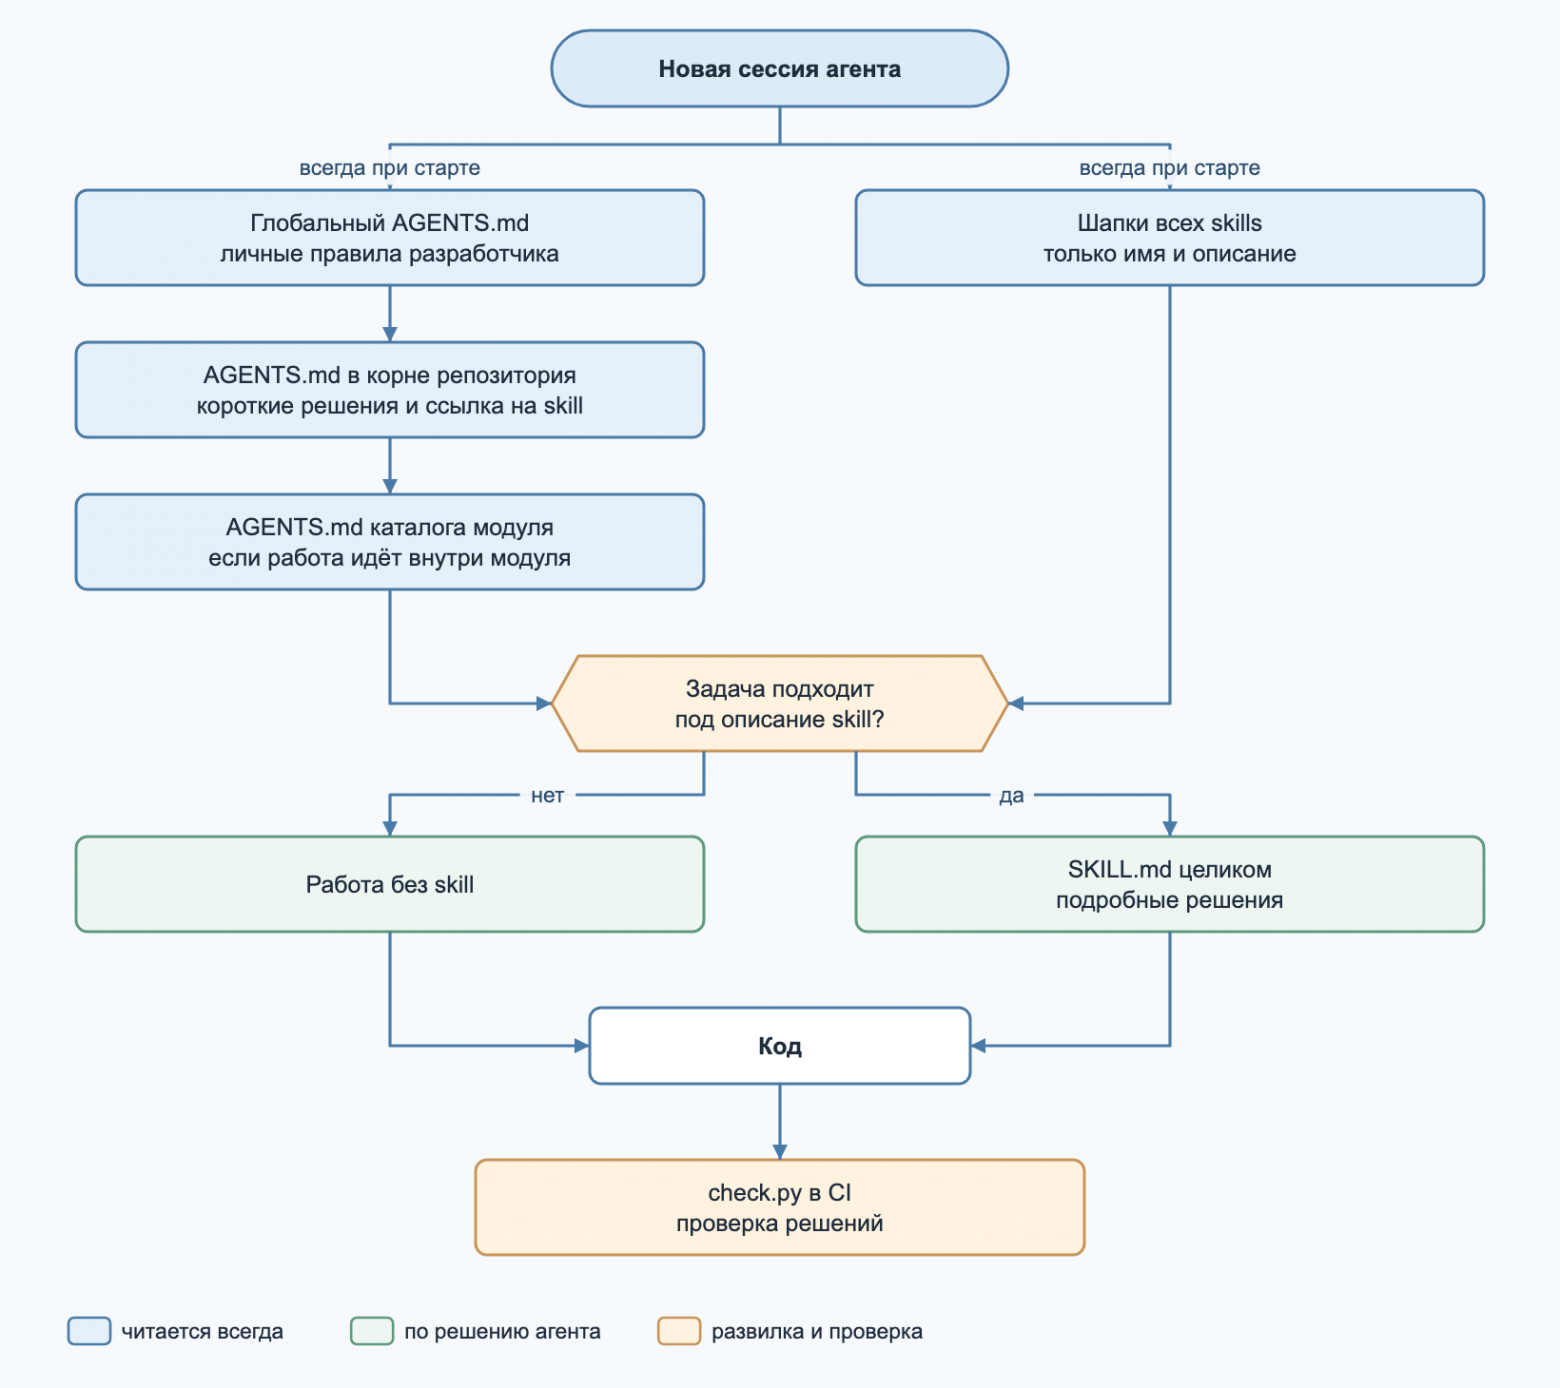
Главная мысль схемы: файлы AGENTS.md по пути до рабочего каталога агент получает при старте без всяких условий, а skill сначала виден только именем и описанием и загружается после развилки «подходит ли задача». На этой развилке и теряются правила, поэтому ссылка из AGENTS.md на skill повышает шанс, что его откроют. Последняя ступень, проверка в CI, ловит то, что прошло мимо обеих.
Где это не сработает
Эксперимент маленький. Одна модель, один агент, одна задача, по три сессии на вариант. Он показывает механику, а долю нарушений для других моделей отсюда не вывести.
Файл контекста стоит денег. В исследовании ETH Zurich «Evaluating AGENTS.md» на SWE‑bench Lite и наборе из 138 задач файлы, сгенерированные моделью, не повысили долю решённых задач, а стоимость выросла на 20–23%. Файлы, написанные разработчиками (их проверяли только на наборе из 138 задач), дали +2,4% решённых задач, статистически незначимо, при росте стоимости до 19%. Агенты исполняют инструкции, начинают больше исследовать и тестировать. Значит, каждая строка в
AGENTS.mdдолжна окупаться, а это ровно шаг 1.Проверки неполны.
check.py— набор ограждений против заранее известных нарушений, а не анализатор Python и SQL. Проверка аудита считает записи, а не их состав и порядок, а проверка UUID отсекает целочисленныйid, но генерацию UUID не подтверждает.Учебный проект упрощён. Функции
dbв исходном проекте сами вызываютcommit(), то есть смешивают выполнение SQL и управление транзакцией. В показанном сценарии изменение и аудит фиксируются однимcommit(), но при расширении операции внутреннийcommit()может досрочно завершить транзакцию вызывающего кода, её лучше оставить сервису. «Выручка» в задаче — сумма цен активных подписок за полуинтервал дат, без возвратов и продлений. Код агента во всех сессиях отменяет подписку схемой «прочитал, затем обновил» и уязвим к параллельной отмене, а время записи и аудита там берётся отдельными вызовами. Эталон в репозитории отменяет подписку одним условнымUPDATEи берёт время один раз, но такие свойства правила не проверяли. Транзакции, аудит и денежную модель настоящего сервиса правила тоже не проверяют.Skill без ссылки может не загрузиться. В моём эксперименте ссылка была всегда, вариант без неё я не проверял. Цифры Vercel говорят, что риск реальный.
Правило против кода. Если правило противоречит соседнему коду, нужно прямо написать, что старый код устарел. Без этой оговорки агент может принять за образец то, что видит.
Сложное поведение. Ни один файл не заменит тесты на бизнес‑логику. Мои правила ловили структуру кода, а правильность отчёта проверял отдельный приёмочный тест.
Что сделать у себя?
Главная мысль схемы: в файл правил попадает только то, что агент без него сделает иначе. Ветка «не записывать» держит AGENTS.md коротким и дешёвым.
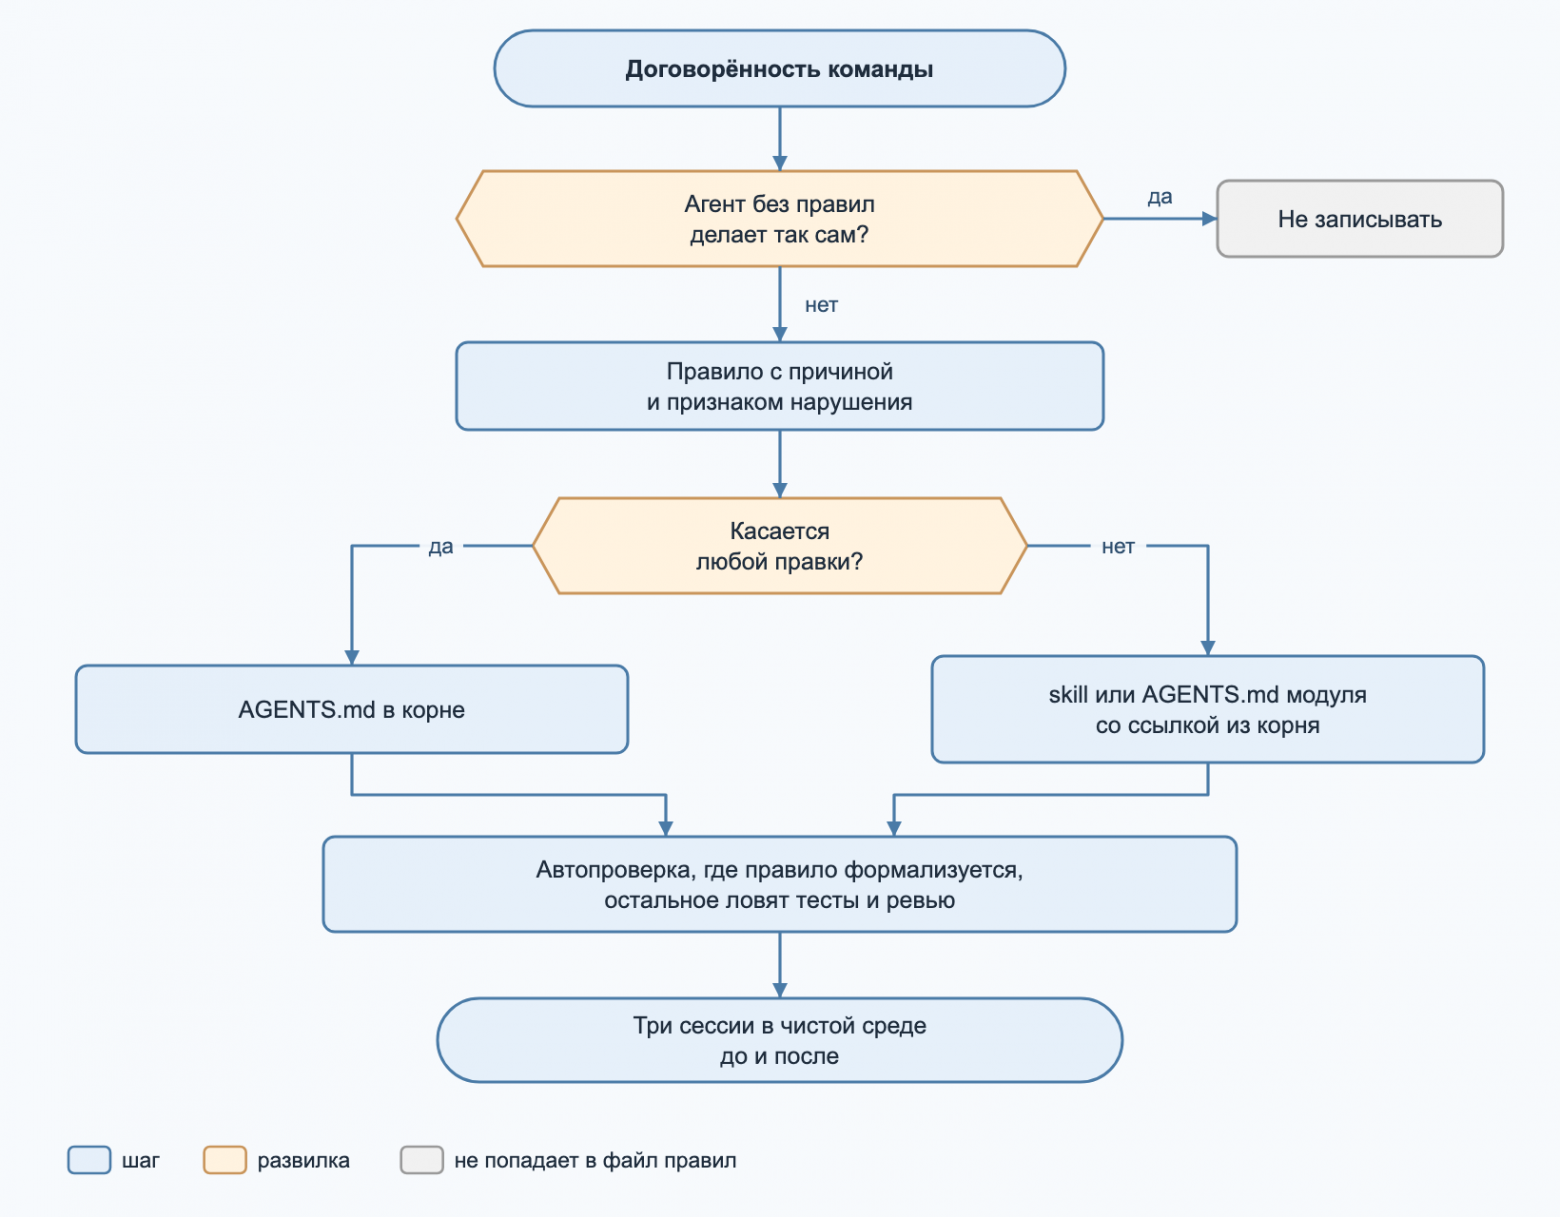
Если у вас уже есть вайб‑проект, я бы начал так: взять три последних исправления, которые вы вносили за агентом руками, записать их правилами с признаком нарушения и прогнать одну сессию в чистой среде. Правила, которые агент нарушает без файла и соблюдает с файлом, и есть ваш AGENTS.md.
Начать стоит с results.md: там обе таблицы статьи и разбор по каждой из 18 сессий. Сами правила лежат в rounds/2/variants/agents_md/AGENTS.md и rounds/2/variants/skill/.agents/skills/project-decisions/SKILL.md, проверки решений в check.py, а пересчёт без живой модели запускается командой ./run.sh.
Репозиторий эксперимента agent‑rules‑memory‑demo, цифры статьи сняты на коммите 34bd426
Vercel. AGENTS.md outperforms skills in our agent evals, 27.01.2026
Linux Foundation. Formation of the Agentic AI Foundation, 09.12.2025
Anthropic. Donating Agent Skills to the Agentic AI Foundation, 22.10.2026
Linux Foundation. Agentic AI Foundation Announces Four New Projects, 22.10.2026
Если вы используете AI‑агентов для разработки, важно уметь управлять не только их работой с кодом, но и всем процессом создания продукта. Следующий шаг — научиться превращать идею в интерактивный прототип с логикой и данными, а затем доводить его до рабочего решения. Этим вопросам посвящены два открытых вебинара.
Системно освоить создание цифровых продуктов с помощью ИИ можно на курсе «Вайб‑кодинг: создание цифровых продуктов с ИИ».
Ближайшие бесплатные открытые уроки:
24 ноября в 20:00. «Не просто макет: как собрать кликабельный AI‑прототип с логикой и данными». Открытый вебинар. Записаться
15 декабря в 20:00. «Как превратить красивый AI‑прототип в рабочий продукт». Открытый вебинар. Записаться
Все ноябрьские мероприятия OTUS собрали в дайджесте.


Комментарии 0