У многих настроен свой локальный харнесс, другие работают в облаке. А что если развернуть харнесс на большую компанию? Как быть, если первого ответа агента приходится ждать почти 40 секунд? Что можно оптимизировать и к чему это приведет? Ладно, развернули и оптимизировали, но как подружить агентов с сотрудниками? И как оценить эффект от внедрения ИИ на уровне бизнеса?
Я еще не настроил свой харнесс, и мне было интересно посмотреть на опыт других компаний. Поэтому пошел на митап MWS на эту тему. Сначала рассказали историю развития ИИ-агентов и базу: что такое обвязка вокруг модели. Потом был доклад про оптимизацию: в MWS все развернуто на Kubernetes и поддерживает OpenClaw и Hermes одновременно. Дальше руководители направлений обсуждали, как агенты работают вместе с сотрудниками. Напоследок был доклад про внедрение ИИ в организациях и оценку его эффекта.
От агентов к харнессу
В больших компаниях многие не понимают, что такое харнесс, или понимают под ним разные вещи. Даниил Малышев, Product Owner в MWS, впервые услышал это слово в августе, когда познакомился с DeepSeek Harness. У архитектора была задача: проверить, что сделал другой разработчик. Как обычно, он отдал ее на проверку в Opus, и тот выдал три небольших замечания. Потом ту же задачу получил DeepSeek Harness и выдал около 50 замечаний, 25 из которых требовали внимания разработчика. Хотя до этого DeepSeek считался средней нейронкой. С тех пор начали разбираться, почему в такой обвязке модель стала выдавать отличные результаты.
Начнем с того, что голая LLM — это черный ящик: получает текст и выдает другой текст. У нее нет памяти, рук, свежих знаний, точного счета, самопроверки и так далее.
Агент — это модель плюс харнесс. А харнесс — все, что есть в агенте, кроме самой модели: промпт, контекст и память, инструменты, цикл действий, проверки и ограничения, оркестрация.
Теперь небольшой экскурс в то, как эволюционировала обвязка вокруг моделей. В 2020 году уже была GPT-3, но популярной она не была. Бум случился в 2022 году, когда у GPT появился первый харнесс в виде чата: ChatGPT вышел 30 ноября 2022 года и собрал около 100 миллионов пользователей за два месяца. Тогда же возникли первые циклы и рассуждения. В 2023-м пришли инструменты: с июля можно было запускать Python прямо в песочнице ChatGPT. В том же году — внешняя память, RAG и автономные агенты. В 2024-м — инструменты управления контекстом: сжатие истории, стандарт MCP и прочее. В 2025-м стала доступна полноценная среда с файлами, терминалом, тестами, навыками и хуками. А в 2026-м агенты научились самонастраиваться.
За это время мы прошли путь от промпт-инжиниринга, где учились формулировать запрос, через контекст-инжиниринг, где разобрались, что модель видит и когда. Теперь наступило время харнесс-инжиниринга: важно все предыдущее, а еще инструменты, цикл, проверки, ограничения и безопасность.
Чем полезен харнесс
Сама по себе модель ничего не помнит, неточно считает и себя не проверяет. Все это берет на себя обвязка, и на митапе разобрали четыре ее главные задачи.
Управление контекстом
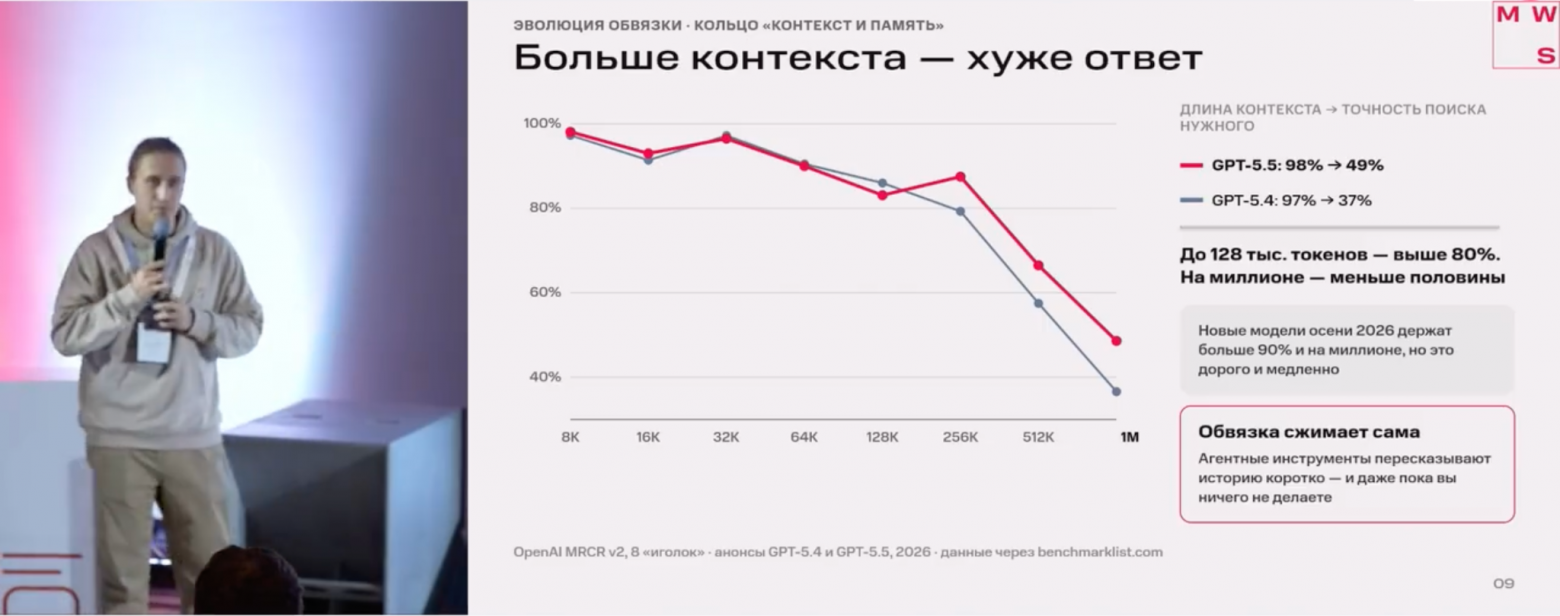
Сначала о том, как работает LLM. Своей памяти у нее нет: на каждый новый вопрос она заново читает весь разговор — все наши вопросы и свои ответы. Этот разговор и называют контекстом. С каждым сообщением он растет, и модель начинает терять то, что было в начале. Первые модели обрезали начало разговора, современные его хранят, но отвечают хуже.
Поэтому опытные вайбкодеры после 20 сообщений открывали новый чат и ставили задачу заново. Многие большие модели уже частично решили эту проблему: когда контекст переваливает за 200 тыс. токенов, разговор автоматически сжимается. Зафиксируем: управление контекстом — главная из этих задач.
Прежде чем решать, что делать с контекстом, разберем, из чего он состоит. В любом промпте, который мы отправляем, есть скрытый системный промпт. Повлиять на него нельзя, если вызов идет не через API. Но и через API вендоры не любят, когда вмешиваются в системные промпты, и могут забанить. Дальше в контексте лежат правила, скилы, ограничения, AGENTS.md и прочее. Большую часть обычно занимают история диалога и результаты, то есть то, что выдала нейросеть. Когда контекст переполняется, что-то приходится обрезать. Можно сжимать историю. Можно выдавать по требованию только то, что нужно, вызывая субагентов. А можно хранить информацию в файлах и вычеркивать ее из диалога.
Точные инструменты
Старые модели плохо считали: сложив 10 и 10, могли получить 22, поэтому их приходилось постоянно проверять. В 2023 году, когда появился Python в песочнице, LLM фактически получила калькулятор. Нейросеть понимает из контекста, что нужно посчитать, пишет для этого код и запускает его. Так она получает точный ответ, а не угадывает его.
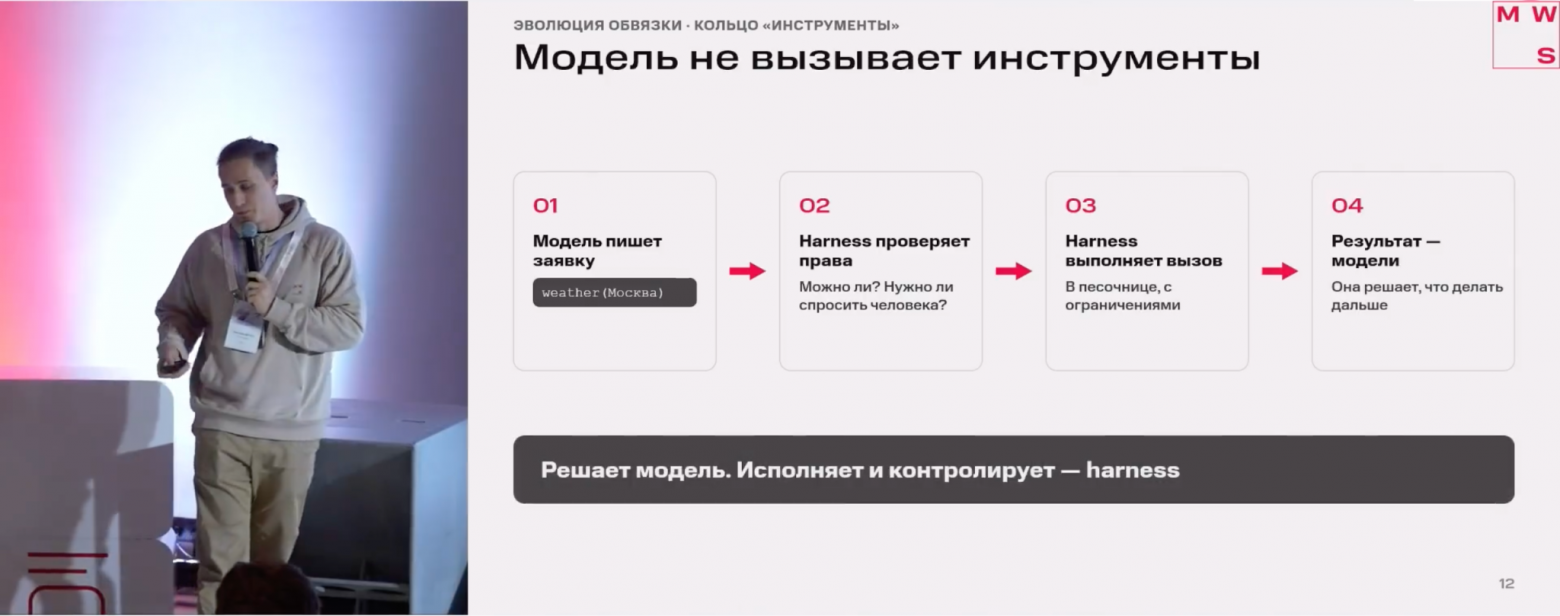
Как это работает? Нейросеть умеет только одно: продолжать текст. Запустить программу или узнать погоду сама она не может, поэтому пишет заявку. Дальше работает харнесс. Он проверяет, есть ли такой инструмент, разрешено ли модели им пользоваться. Если все в порядке, харнесс сам делает вызов и возвращает результат модели.
Цепочка рассуждений
Раньше нейронка не умела выстраивать цикл рассуждений. Для этого придумали ReAct: подумал, сделал, посмотрел, повторил. Это самая важная часть харнесса: от того, насколько качественно проходит этот цикл, зависит качество результата.
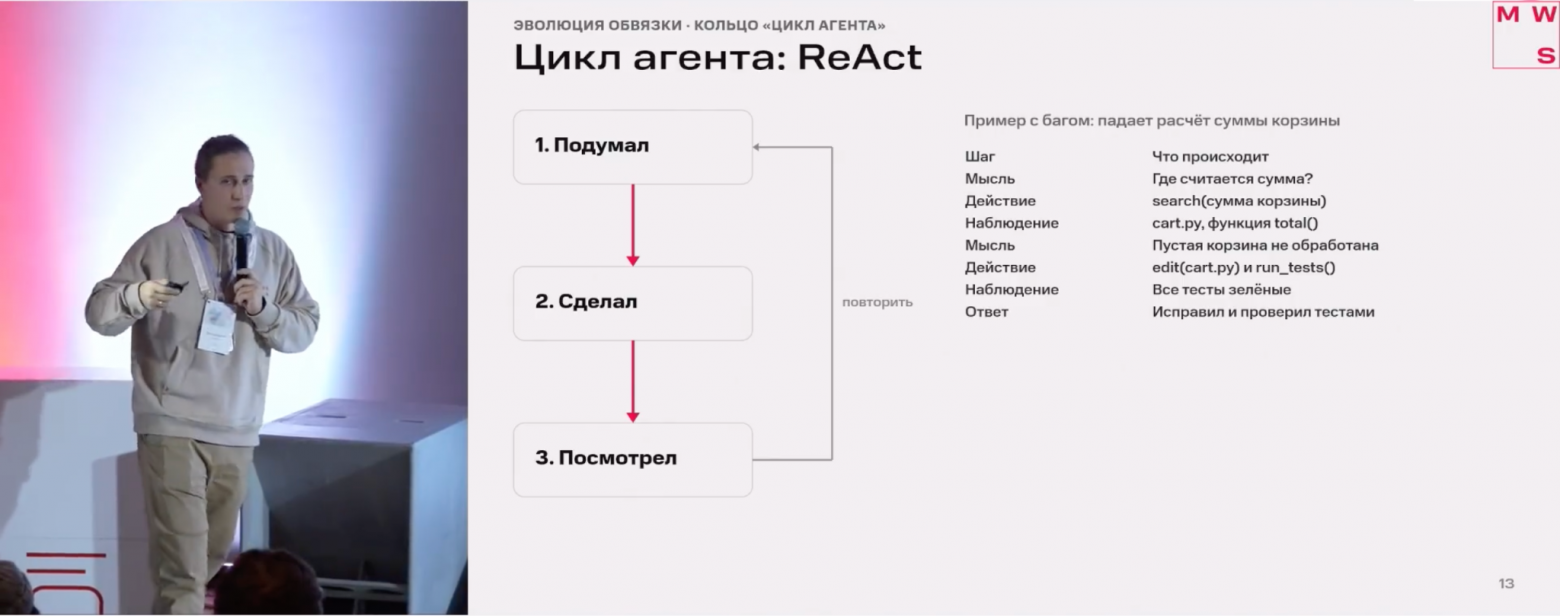
Компания LangChain тестировала своих агентов с моделью GPT-5.2 на 89 задачах в терминале. Там заметили, что иногда не прогоняются тесты или LLM что-то не доделывает, хотя собиралась. Постепенно, итерациями и правками скилов, LangChain подняла модель с 30-го места на 5-е.
Но много инструментов — не значит хорошо. Другой пример — от Vercel. У них был агент с 17 инструментами, и он периодически ошибался в одной задаче из пяти. Тогда в Vercel начали экспериментировать и отключать инструменты. Контекст уменьшался, и в итоге на четырех необходимых инструментах задачи выполнялись на 100%. Поэтому важен агент, который будет выбирать инструменты для других агентов.
Еще важно понимать, что с каждым шагом рассуждения копятся ошибки. Если точность одного шага 99%, цепочка из 10 шагов проходит без ошибок в 90% случаев, а цепочка из 50 шагов — только в 60%. Ломается каждая десятая задача. В примере с корзиной ошибку ловят тесты после каждой правки, до того как агент скажет «готово».
Это решается спецификацией для разработки. В ней прописывают цели и критерии приемки, что и где читать, формат результата, запреты и самопроверку. В идеале под каждую задачу нужна своя спецификация. Хороший пример такого инструмента — OpenSpec.
Харнесс, который улучшает сам себя
Наконец, тренд второй половины 2026 года — автонастройка. Устроено это несложно: агент работает, логи и сессии копятся, настройщик ищет повторяющиеся проблемы и правит навыки, скрипты и проверки.
Некоторые игроки рынка уже настроили себе такое. Данные за сутки агрегируются и уходят на проверку человеку, и он решает, обновлять ли харнесс. В Google Research Harness 2 это происходит автоматически.
Вот один из кейсов автоматического исправления харнесса в MWS:
Агент чинит баги в корзине. В его обвязке есть правила (AGENTS.md), навыки (починка багов) и инструменты (файлы, терминал), а хуков нет. За день проходит шесть сессий, и в трех из них агент сдает работу, не запустив тесты. Логи всех сессий попадают в базу знаний. Раз в сутки настройщик забирает логи, видит, что в трех сессиях из шести тестов не было, и добавляет в обвязку хук «без тестов не сдавать». На следующий день все шесть сессий проходят с тестами.
Как это работает в MWS?
MWS Track — трекер задач, где исполнителем можно назначить человека или агента. Агент возвращает результат в задачу, и человек проверяет его на ревью.
MWS Code — прокси моделей со своей обвязкой, выглядит как консольный клиент. Разработчики могут использовать как внешние, так и внутренние модели. Логируется все: что используется и как. Статистика помогает понять, как развиваться дальше.
Реестр агентов — пилотный проект, через который можно брать готовых настроенных агентов под свои задачи.
AI Memory — пилотный проект, который собирает всю информацию из сервисов, библиотек, документации и инфраструктуры. Работает примерно как RAG: отдельный агент ищет информацию в AI Memory и в нужном виде передает ее тому агенту, который с ней работает.
Оптимизация харнесса в большой организации
Екатерина Иванова, ведущий разработчик в MWS, рассказала, как оптимизировали запуск ИИ в проекте «Цифровой сотрудник».
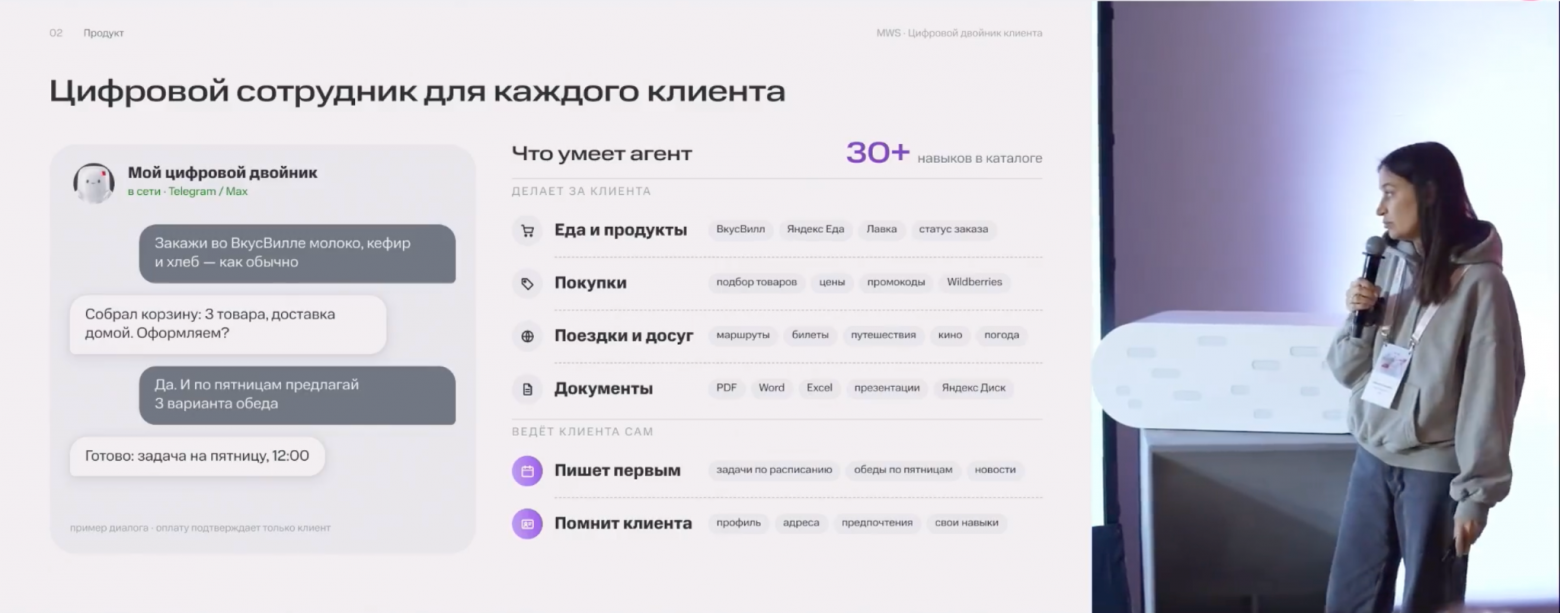
Для пользователя продукт — чат-бот в Telegram и Max. Это цифровой двойник для каждого клиента, который работает как консьерж. Агент запоминает нужные клиенту данные, хранит его адреса и предпочтения. Он ведет себя проактивно, запоминает поведенческие паттерны пользователя и работает с 30+ навыками.
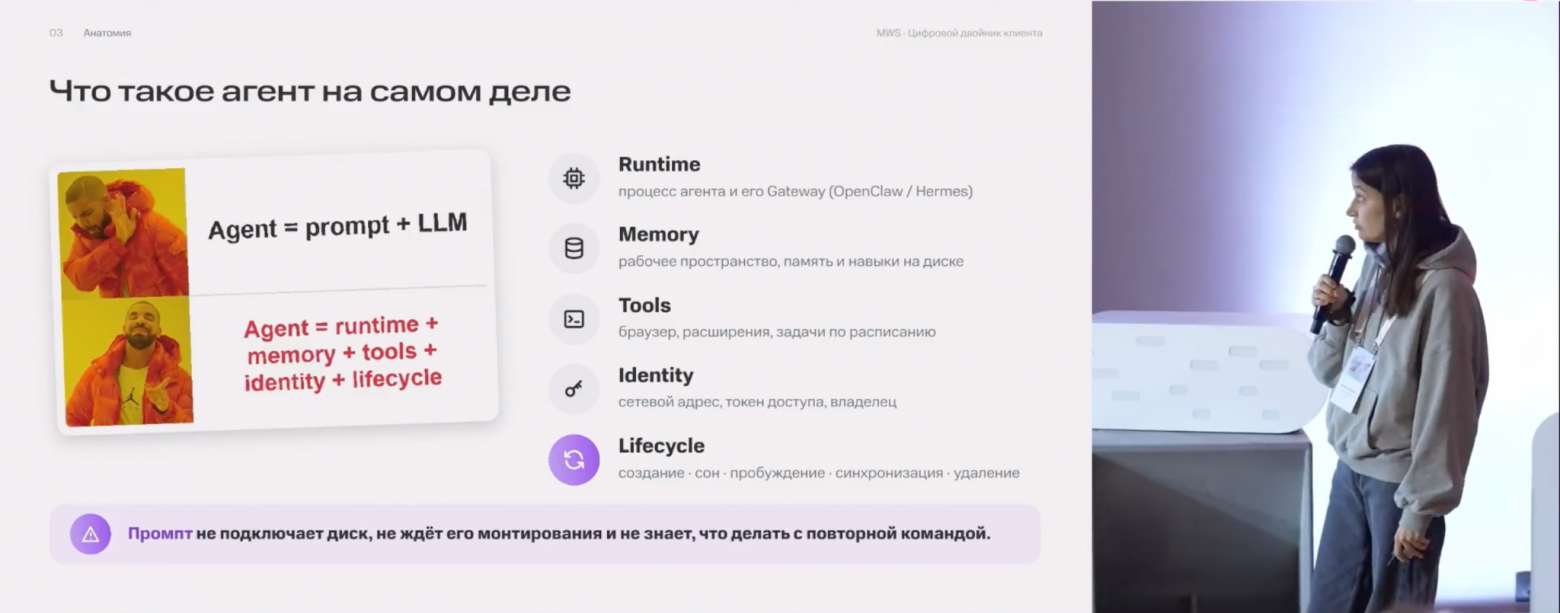
Обычно пользователю видны только промпт и работа LLM. Но под капотом есть еще процесс агента и его Gateway (OpenClaw или Hermes), работа с памятью, инструменты, браузер и расписание, идентификация и жизненный цикл агента.
Ускорение запуска
Когда пользователь пишет промпт в чат, он ждет в среднем 37,6 секунды. В зависимости от условий ожидание доходит до 53,5 секунды. Если все необходимое запустить и держать постоянно включенным, оно сокращается до 24 секунд. При этом сам ответ ИИ занимает 2,3–4,5 секунды, остальное время уходит на подготовку. На что тратятся эти секунды?
4 с — оператор, то есть сервис, который перекладывает манифест агента в Kubernetes;
10 с — подключение диска к ноде;
5 с — монтирование диска в под;
5 с — инициализация контейнеров (браузер, сайдкар и т. д.);
9,5 с — загрузка Gateway агента: инструкции, подключение плагинов;
3,1 с — проверка готовности;
1 с — доставка файлов и адреса на под.
Как убрать это ожидание и какие для этого есть архитектуры?
Свой под на каждого. Этим удобно управлять, агенты изолированы, легко откатить одного пользователя или всех. Но каждый старт с нуля занимает десятки секунд, и первый опыт у пользователя получается негативным. Сейчас в продакшене работает этот вариант.
MicroVM на сессию. Самая сильная изоляция. Но старт гораздо медленнее, эксплуатация гораздо сложнее, а памяти уходит еще больше.
Общий диспетчер на всех. Один процесс маршрутизирует пользователей и решает все через субагентов. Но если он упадет, пострадают все пользователи. К тому же надо решить, где хранить память конкретного пользователя и как управлять жизненным циклом агента.
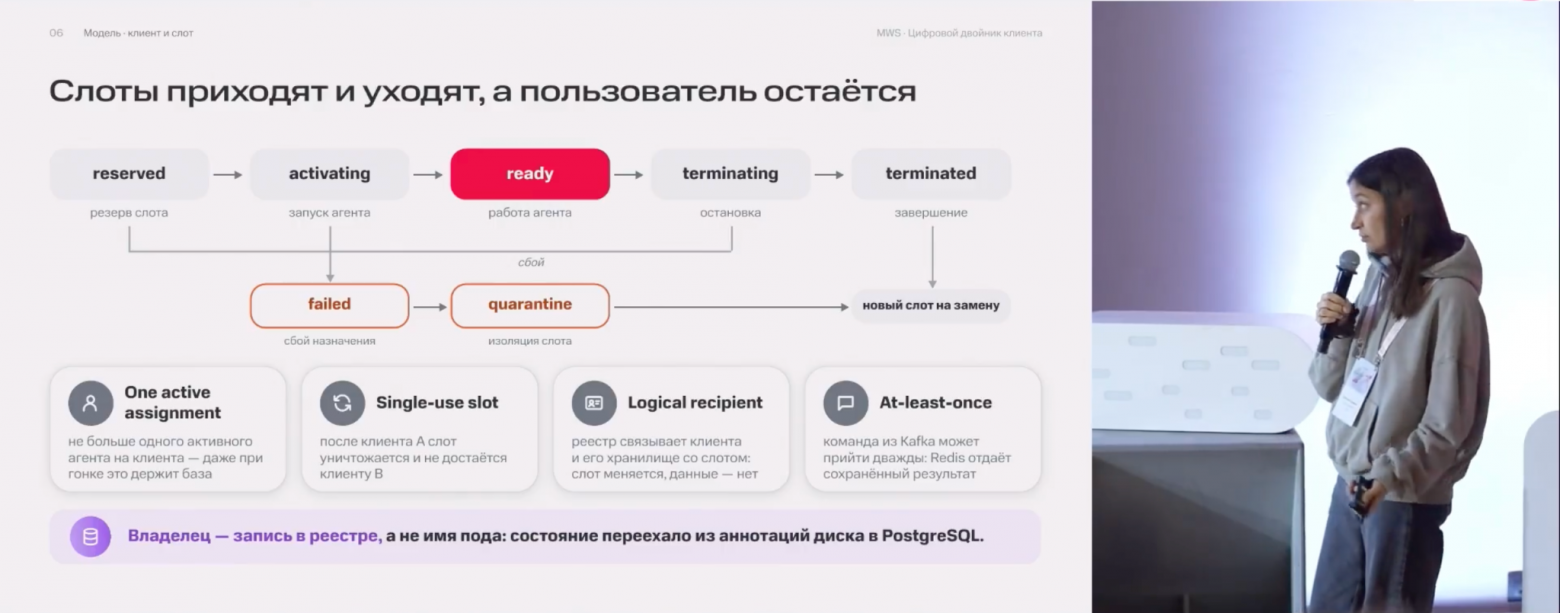
Прогретые слоты. Этот вариант выбрали сейчас. Всю тяжелую подготовку делают заранее, пользователь ждет только запуска агента. Но растет когнитивная сложность системы: нужны общее хранилище, реестр назначений, защита от шаринга данных между владельцами. Осталось доработать этот вариант и дотащить его до продакшена.
Когда у каждого пользователя свой под, его связывают со всеми ресурсами Kubernetes через UUID пользователя с префиксами и постфиксами. Даже база данных для этого не нужна.
Когда появляются слоты, где-то нужно хранить, кто владеет конкретным слотом. Так появляется реестр на PostgreSQL со статусами слотов и их привязкой к пользователям. На одного активного пользователя приходится не больше одного активного слота. Когда пользователь A уходит, его слот не должен достаться пользователю B. Нужна связь пользователя с хранилищем и слотом. Еще нужно, чтобы Kafka присылала необходимые для этого события.
Возвращаемся к 37,6 секунды. Как сократить это время? Все цифры ниже — для OpenClaw.
Переносим в прогретые слоты поднятие пода на нужной ноде, доставку настроек и ключей. Это минус 4 секунды, остается 33,6. Взамен система усложняется: появляются пул прогретых слотов и назначение пользователей в PostgreSQL.
Беремся за подключение и монтирование диска. Вместо блочных хранилищ и диска на каждого пользователя делаем общее хранилище на CephFS. Минус 15 секунд, остается 18,6. Усложняется контроль того, что видит пользователь.
Последнее — инициализация контейнеров и модулей агента. Их прогреваем заранее: от 2 секунд для OpenClaw до 5 секунд для Hermes. Прогрев экономит 5 секунд, но в запросе добавляются закрепление слота за клиентом (0,8 с) и пробуждение агента с токенами (0,3 с), а загрузка Gateway вырастает до 11,5 с. В итоге выигрыш на этом шаге — 1,8 секунды.
После всех шагов время сократили с 37,6 до 16,8 секунды, но цель — максимум 6–8 секунд на всю инфраструктуру. Для этого придется залезать в реализацию агента, например форкнуть его. Дальше команда будет двигаться в этом направлении. Пока время на первую загрузку Gateway осталось, но следующий ответ будет уже заметно быстрее: вместо 9–11 секунд на Gateway будет уходить меньше 0,5 секунды.
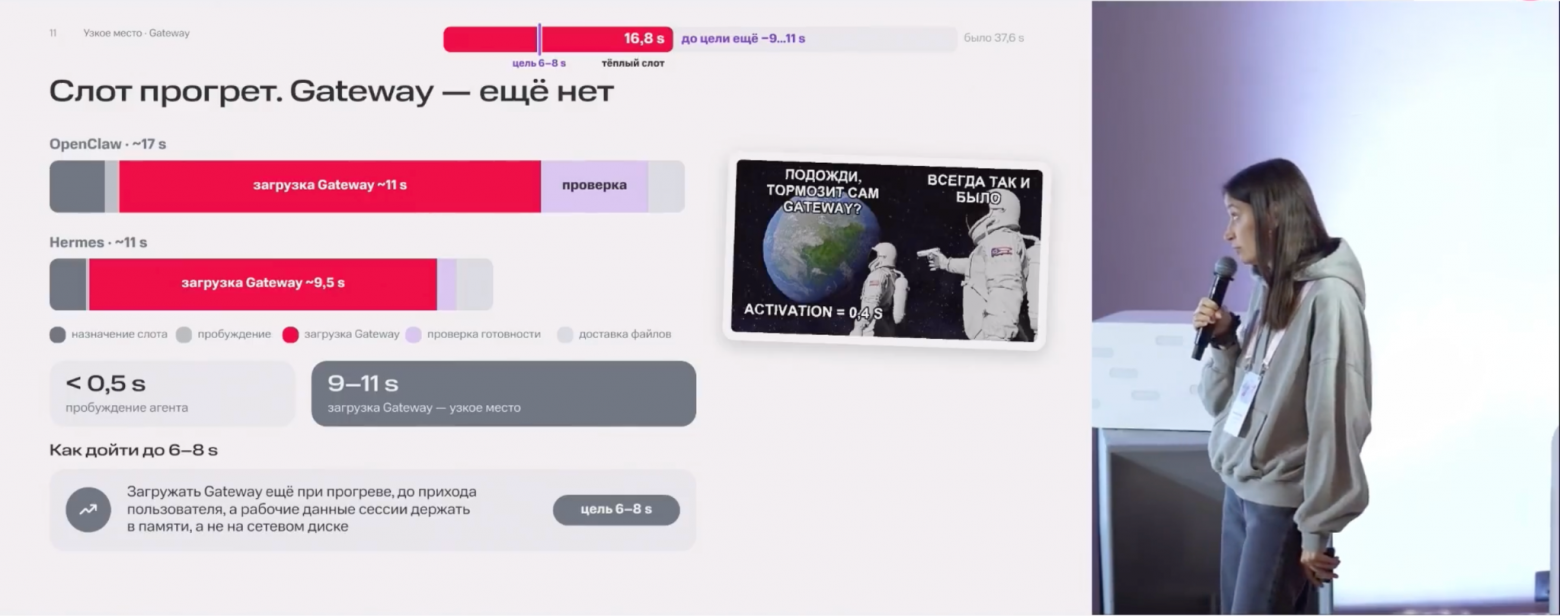
С каждым шагом система усложняется, и появляются новые проблемы.
Проблемы общего хранилища
Главная проблема нового подхода — общий диск. В простой модели, где у каждого пользователя свой под, можно было монтировать блочное хранилище и держать отдельный диск на каждого клиента. В архитектуре с warm pool такая схема не работает: к уже прогретым слотам диск не примонтируешь. Поэтому появляется общее хранилище формата RWX, и при пробуждении слота туда отдают папку конкретного клиента. В текущем варианте все слоты видят общий корень, и из-за переназначения прав через root или группу пользователь может увидеть соседей. Чтобы этого избежать, разграничение нужно перенести на уровень хранилища: монтировать subvolume вместо папок и давать к ним доступ по ключу. Это еще больше усложнит систему. Скорее всего, понадобится отдельный сервис, который будет за этим следить.
Дальше — workspace агента, где могут лежать файлы разных владельцев. Их разделили на области видимости:
managed — доставляются в виде конфигов и версионируются, обновляются и удаляются строго по реестру;
protected — профили и адреса пользователя. Их собирают и ведут data- и ML-инженеры, поэтому эти файлы не трогают;
runtime — файлы агентов, трогать и перезаписывать их нельзя;
user-owned — файлы пользователей, трогать и перезаписывать их тоже нельзя;
seed — файлы, которые доставляют один раз и забывают о них, например при онбординге.
Итог: удалять и обновлять можно только свое, а контекст клиента должен пережить сон и обновление.
Проблемы агентов
Другая проблема связана с появлением новых runtime-фреймворков. Новый runtime не должен ломать общую работу или требовать, чтобы под него переписали всю систему. Поэтому выделяют общий контракт, который работает с любым агентом, а специфику runtime выносят в адаптер и отдельные конфигурационные файлы.
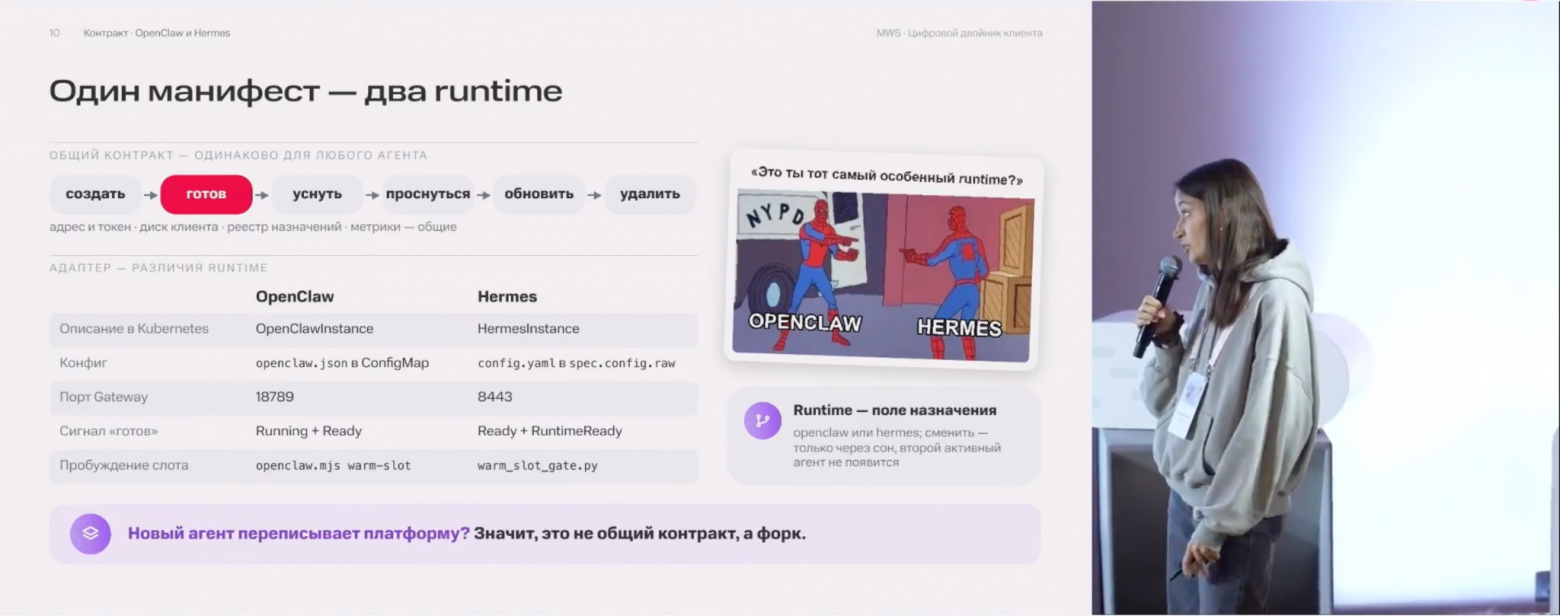
Агентов нужно не только быстро поднимать, но и быстро усыплять, когда пользователь ушел или задумался. Пока это работает по последней отметке времени. Если последняя активность была от пользователя, слот гасят через 30–35 минут. Если слот подняла периодическая задача Cron — через 5 минут. По активности пользователя пока нельзя понять, закончил ли он или думает над вопросом LLM и его надо подождать. Чтобы это решить, нужно залезать в runtime агента. Еще есть Jev, который принимает решение за 0,5 секунды, тогда как обычным моделям нужно 6–8 секунд. Есть гипотеза, что Jev по метрикам клиента сможет понять, ушел он или задумался. Если гипотеза подтвердится, активность пользователя можно будет определять в пределах 5 минут.
Метрики со всех участников снимаются через Prometheus и Grafana. На агенте трейсы смотрят в Langfuse: по ним видно, когда начала работать модель. Еще смотрят логи агента, чтобы понять, сколько запускался Gateway и на какие фазы ушли секунды.
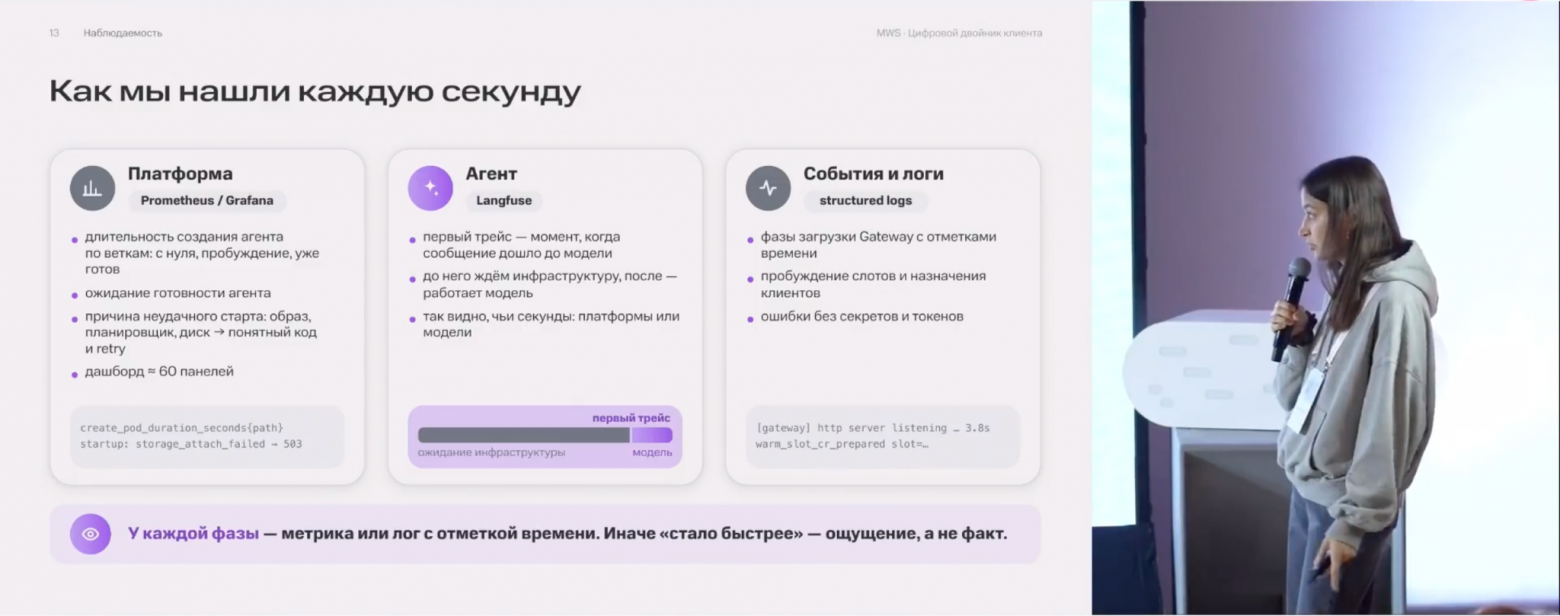
Часть проблем уже решена, над остальными идет работа.
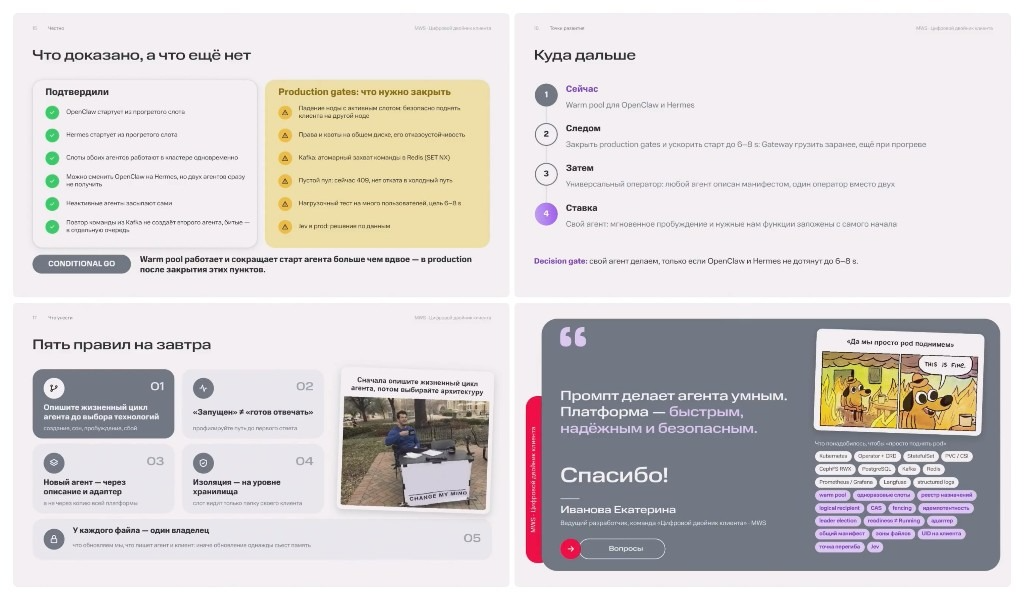
Как ИИ-агенты уживаются с сотрудниками
От харнесса переходим к людям: руководители обсуждали, как агенты встраиваются в работу команд.
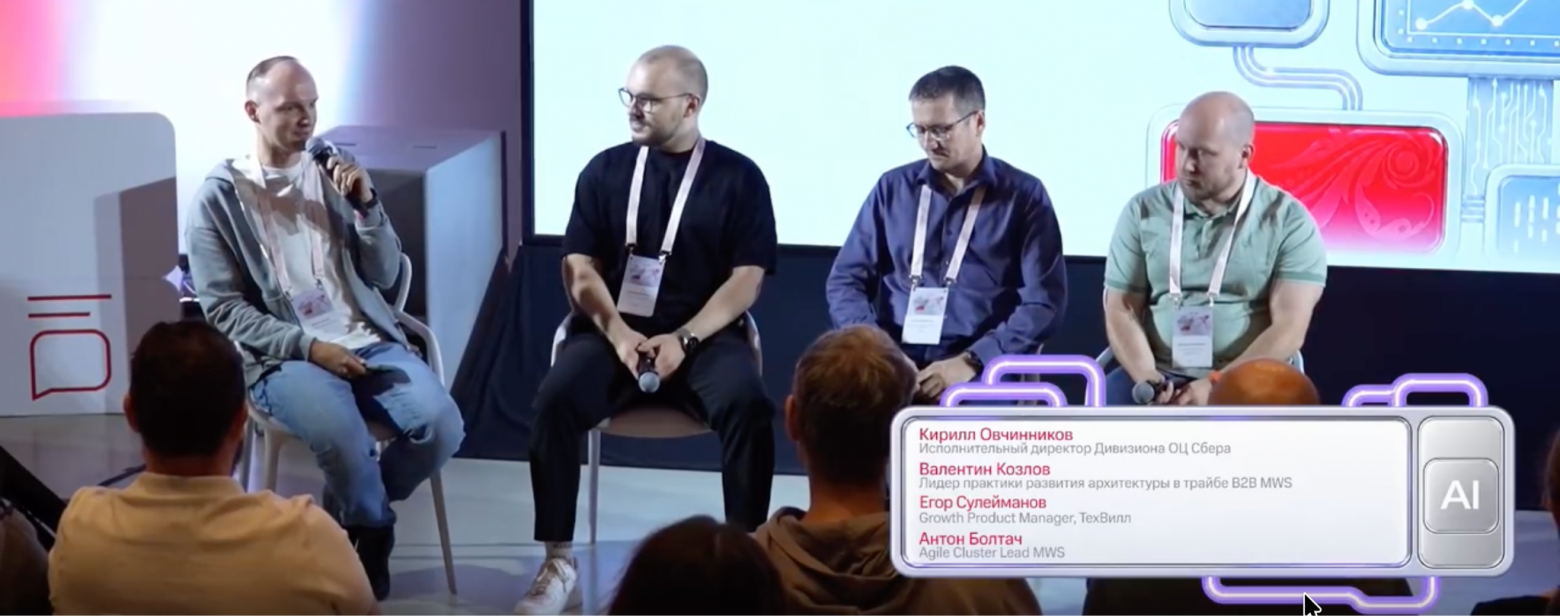
В дискуссии участвовали:
Кирилл Овчинников — лид продукта в Сбере (там делают цифрового сотрудника), а также лид сообщества вайбкодинга в банке;
Валентин Козлов — архитектор трайба B2B в MWS;
Егор Сулейманов — продакт-менеджер ТехВилл (IT-подразделение «ВкусВилла»). Отвечает за «Зефирку», ИИ-ассистента покупателя, и консультирует стартапы по внедрению ИИ;
Антон Болтач — agile cluster lead в MWS.
Как интегрировали ИИ и с чего начинали?
Валентин (MWS). Больше 10 продуктовых команд: монолиты и стартапы. Начинали с вайбкодинга, но в энтерпрайзе он не работает: каждый раз приходится заново поднимать контекст. Магии не получается: мусор на входе — мусор на выходе. Поэтому один из сотрудников предложил фреймворк Genome из двух частей: набор инструкций и правил для агента и подход к описанию продукта, чтобы с ним могли работать агенты. Сейчас фокусируемся на архитектуре и бизнес-анализе, там используется Genome, об этом расскажут в ноябре на Highload. В остальном разработчики и тестировщики уже работают с агентами.
Кирилл (Сбер). Евангелист ИИ. Сейчас ИИ внедряется везде. Он реально помогает людям и ускоряет их, особенно если понимать, как он устроен.
Егор (ТехВилл). С точки зрения продукта в работе все ИИзировано. У агентов есть доступ к MCP аналитики, Figma, репозиториям, трекерам и всем базам данных, и это сильно повышает продуктивность. Но появляется много шума и энтропии, с которыми приходится работать. Концепты ребята делают очень быстро.
Что поменяли в процессах?
Кирилл (Сбер). Последние годы много экспериментировали. Сначала агенты выполняли часть интеллектуальной работы, а сейчас пришли к тому, что они могут ускорять любую работу, в том числе в операционном центре. Движемся к тому, чтобы агент стал активным участником каждой задачи вместе с человеком, которого он усиливает, а не заменяет.
Какие модели использовать: внешние или внутренние?
Егор (ТехВилл). Используем и те, и другие. Это выбор между контролем и скоростью. Локальные безопасны, но для них нужно найти железо и людей и ввести все в эксплуатацию, а это долго. Внешняя модель сильно сокращает время запуска и при этом остается самой совершенной на данный момент. С внешними моделями ответственно подходим к чувствительным и персональным данным. Еще одна проблема внешних моделей: провайдер становится частью бизнеса, а это отдельные риски. Когда начинаешь думать про риски, готовишь оркестрацию, фолбэки, план Б и так далее. Для нашего продукта и команды это допустимо, но в финтехе или медтехе такое не подойдет.
Как живут роли внутри команды?
Валентин (MWS). Сейчас роли наследуются из PDLC/SDLC. Это промежуточный этап: мы привыкли работать в определенном процессе. Поэтому каждый этап по-прежнему ведет соответствующий специалист, но вместе с агентом. Агент — копилот, ответственности у него нет. Отвечает человек, который с ним работает: за процесс и результат, а агент только помогает.
Егор (ТехВилл). Есть общие практики и личная инициатива. Отдельный обмен знаниями пока не нужен, для этого есть тимлиды и техлиды.
Кирилл (Сбер). У агентов две области владения: контекст и харнесс. Контекст формирует человек, и он же за него отвечает. Владелец контекста — разработчик, архитектор или конкретный пользователь агента. За разработку харнесса отвечает отдельный департамент.
Какой эффект от внедрения агентов?
Кирилл (Сбер). В целом агенты сильно помогают: инцидентов стало вдвое меньше, сторей на каждого разработчика — на 25% больше. Кода стало кратно больше, но не все доходит до прода.
Валентин (MWS). Агенты ускоряют конкретные операции. Но чтобы сократить time to market, нужно полностью переработать end-to-end-процессы. В энтерпрайзе они складываются годами и десятилетиями, поменять процесс бывает сложно, все очень инерционно.
Егор (ТехВилл). Нужно проводить A/B-эксперимент: взять команду без агентов и команду с агентами, посадить на один продукт и замерять. Тогда можно прийти к конкретному числу. Без этого точно отделить эффект агентов тяжело. Но субъективно видим, как растет скорость. У продакта вообще счастье: агент может посмотреть всю БД и написать запросы, сделать прототипы в Figma, и все это хорошо работает. Субъективно с агентами я стал в 2 раза быстрее и в 3 раза ленивее. Тренд AI-first в компании однозначно есть, и ТехВилл одним из первых выпустил MCP к своим продуктам.
Какое будущее видите, в том числе для команд?
Валентин (MWS). Команды будут сокращаться, роли — меняться, траты на токены — расти. Мы в той же позиции, что и в начале прошлого века: лошади уходят, машины приходят. Но все меняется в десятки раз быстрее. Появятся продакт-инженеры, которые будут решать задачи от идеи до реализации.
Егор (ТехВилл). Отвечу от лица продактов. Мы не хотим. Мы резко против. Нам такое не нравится, но, скорее всего, мы там окажемся.
Кирилл (Сбер). Все уже меняется. Скоро хорошо будут платить за плитку, электропроводку и то, что нужно всем. В IT останутся только те, кому это очень нравится. Уходит время, когда можно было зазубрить книгу и изображать хорошего работника. Чтобы оставаться хорошим работником, надо гореть работой.
Блиц: ИИ усиливает сильные команды или маскирует слабые?
Егор (ТехВилл). ИИ — как контраст в рентгене. Если есть суперкрутые, он их подсветит. Если что-то плохо или кто-то слабый, это станет еще заметнее. Например, если задачи ставились плохо, то по плохой формализации агент и сделает плохо. Если говорить глобальнее, компания тоже должна быть готова быстро меняться. Если мы упираемся в инфобез, это проблема не команды разработки, и решать ее нужно выше.
Валентин (MWS). Я начинал разработчиком, ушел в управление и потерял навык разработки. Сейчас счастлив, потому что снова могу поставлять ценность от идеи до реализации. Если человек хочет учиться и развиваться, он будет делать это быстрее. Но современная модель мира будет делать людей менее умными.
Кирилл (Сбер). Зависит от общего фона. Если прийти в компанию, где никто не знает ИИ, будешь выглядеть недосягаемым. Но если все вокруг пользуются нейросетями и знают, как выглядит нейрослоп, а ты работаешь meat-proxy, все поймут, что ты деградировал и ничего не умеешь.
Валентин (MWS). Оппонирую. Если понимаете, что спрашиваете у ИИ, вы можете провалидировать ответ. Если базы нет, то что бы вы ни делали, провалидировать его не сможете. На первый план будут выходить базовые навыки: умение логически и критически мыслить. В IT останутся только те, у кого они есть. Остальных из IT выпилят, потому что они не смогут достигать того результата, которого достигнут люди с этими навыками.
Егор (ТехВилл). Согласен с Валентином. Я вот так вместе с ChatGPT сломал водонагреватель: решил, что справлюсь сам и сэкономлю на мастере. Теперь у меня новый водонагреватель.
Экономика внедрения ИИ в бизнесе в целом
До этого речь шла в основном об ИИ в IT, а финальный доклад Дарьи Никитиной из IBS был про внедрение ИИ в бизнесе в целом. Чтобы что-то продать бизнесу, нужно рассказать, какой эффект он получит.
В 2026 году больше 80% крупных компаний в России используют или тестируют LLM. Но ожидаемого эффекта достигают только 5–10% из них. В мире нейросети используют около 90% компаний, и только 35% замечают влияние ИИ на EBIT.
Почему внедрение ИИ не взлетает?
Для автоматизации выбран не тот процесс. Решение — аудит процессов.
Эффект нечем измерить, критерии успеха не сформулированы. Решение — планирование эффектов.
Завышенные ожидания без учета других затрат и рисков. Решение — тоже планирование эффектов.
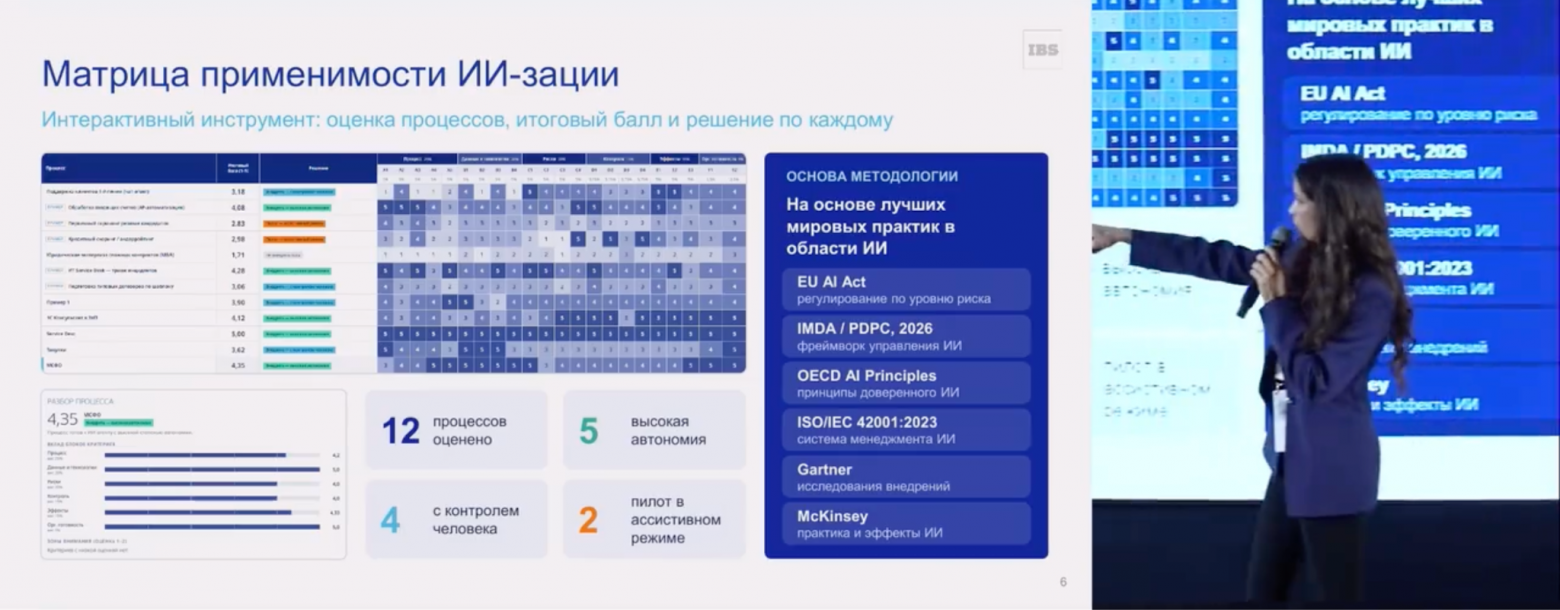
Хорошая новость: это можно предотвратить аудитом процессов. Для экспресс-аудита выписывают все процессы и оценивают каждый по шести блокам (в скобках — вес блока в итоговом балле):
Процесс (25%): как часто он выполняется и насколько он повторяем;
Данные и технологии (20%): есть ли для процесса данные в электронном виде;
Риски (20%): насколько велика цена ошибки;
Контроль (15%): должны ли люди контролировать процесс на всех этапах;
Эффекты (15%): чего ждут от внедрения, о них поговорим ниже;
Орг. готовность (5%): в консервативных отраслях внедрять ИИ сложно, как и там, где руководство не заинтересовано в таком развитии.
Примерно так выглядит эта матрица. В первых столбцах — названия процессов, дальше по каждому процессу идут ответы на 22 вопроса, сгруппированные в шесть блоков. По оценкам считается скоринг бизнес-процессов. Процесс с баллом от 4 до 5 можно внедрять, от 3 до 3,99 — внедрять с контролем человека, от 2 до 2,99 — запускать пилот в режиме ассистента, ниже 2 — не внедрять.
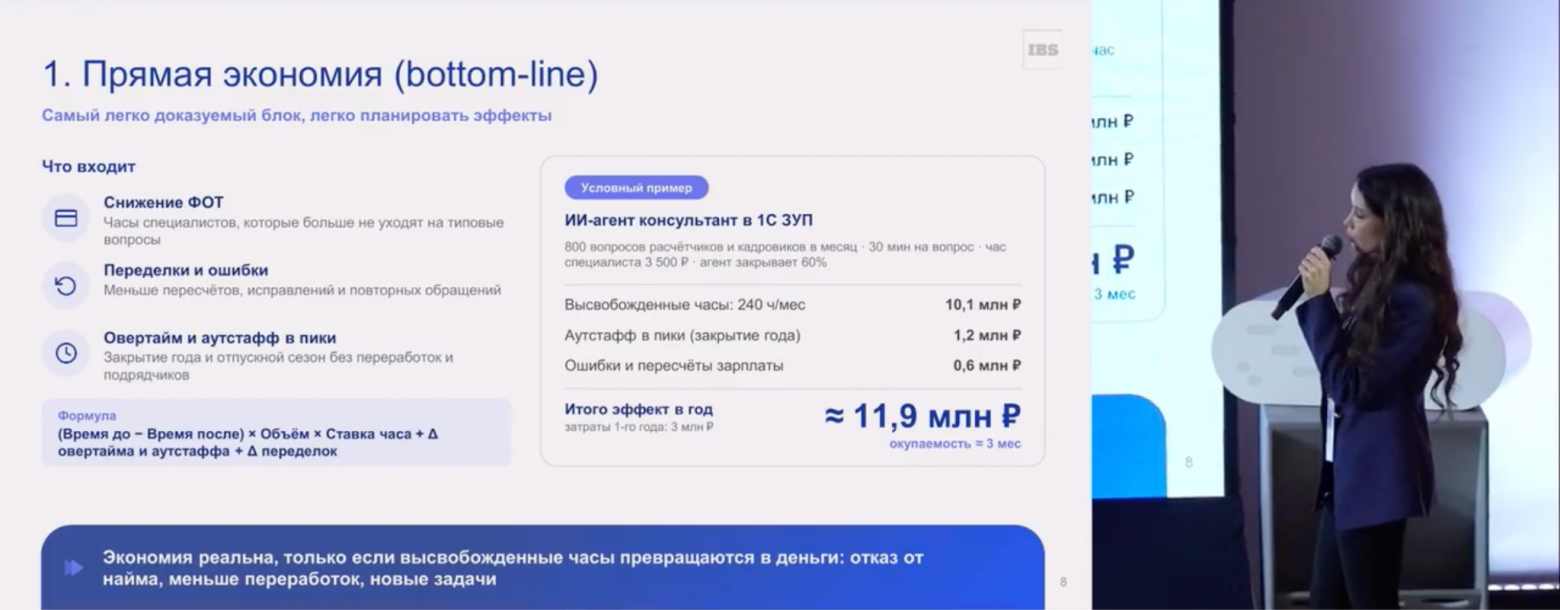
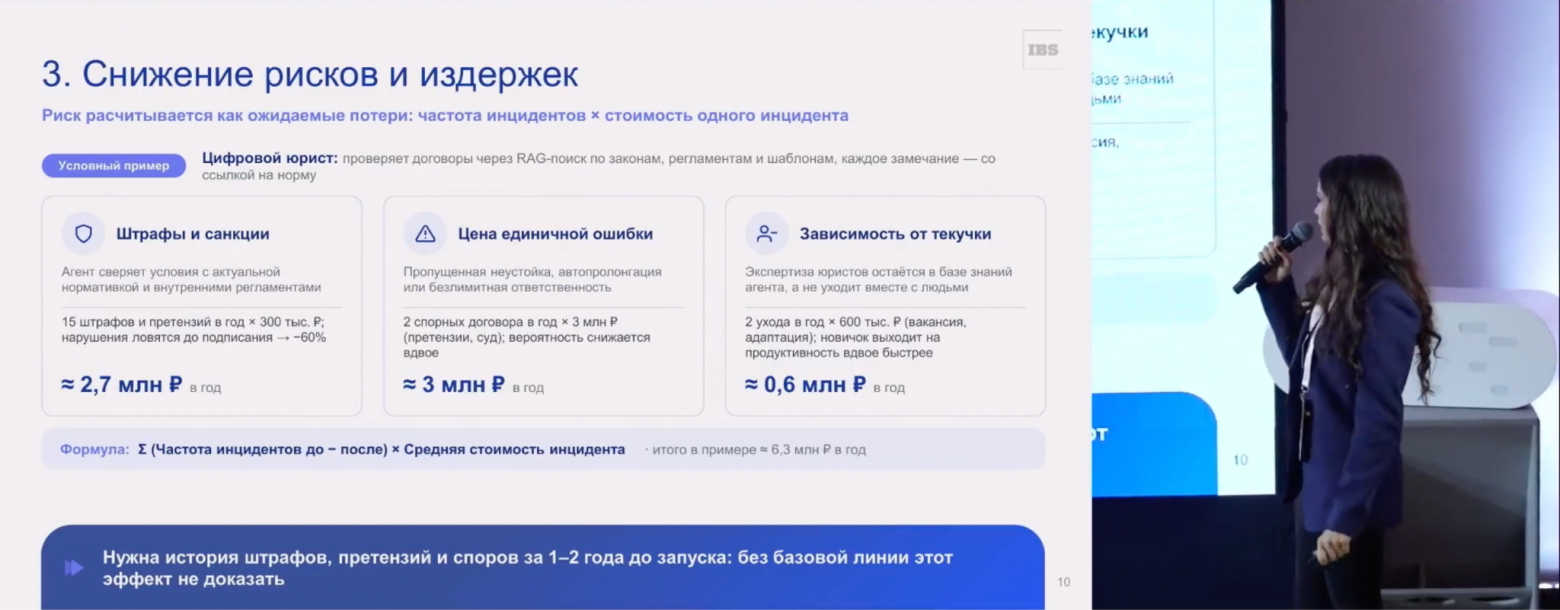
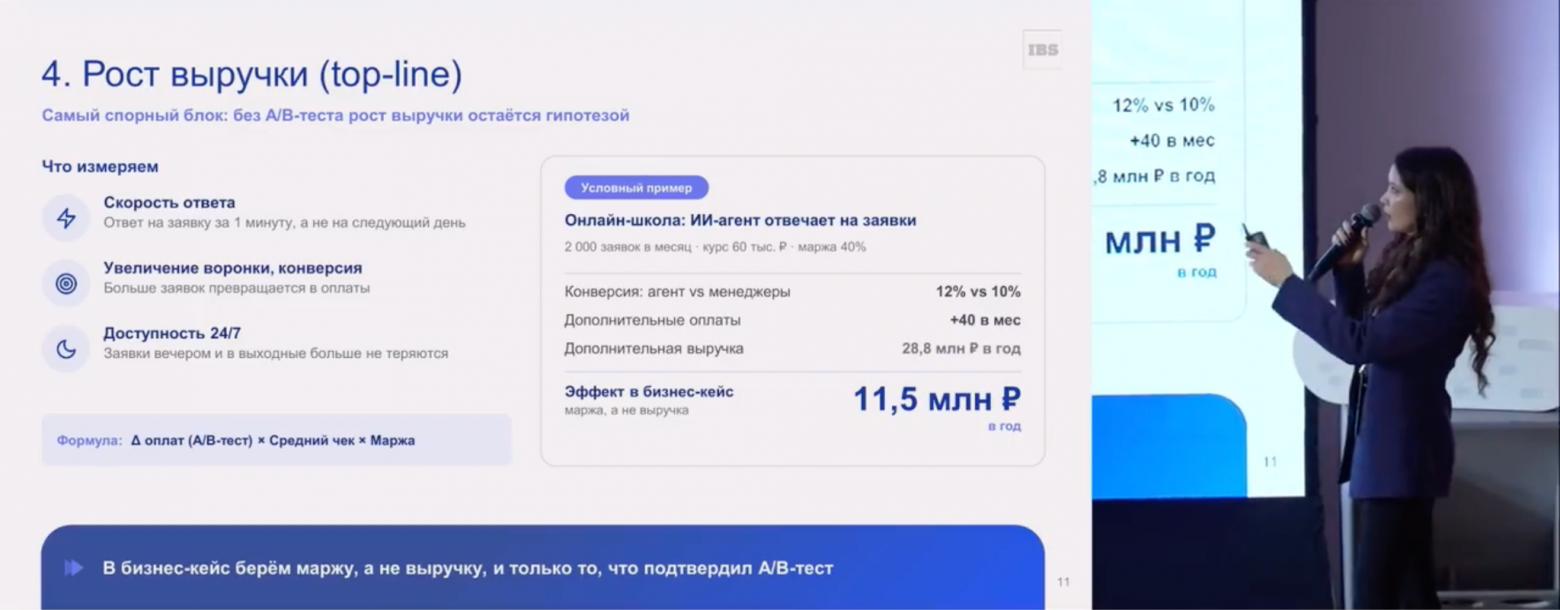
Итак, мы выбрали несколько процессов для внедрения ИИ. Теперь нужно спланировать эффекты. Для каждого процесса можно взять один-два подхода к оценке. Первые три подхода легко доказать, у последних двух самый большой потенциал роста, хотя доказывать их сложнее.
Прямая экономия. Это снижение ФОТ, считают по замеру часов до и после внедрения.
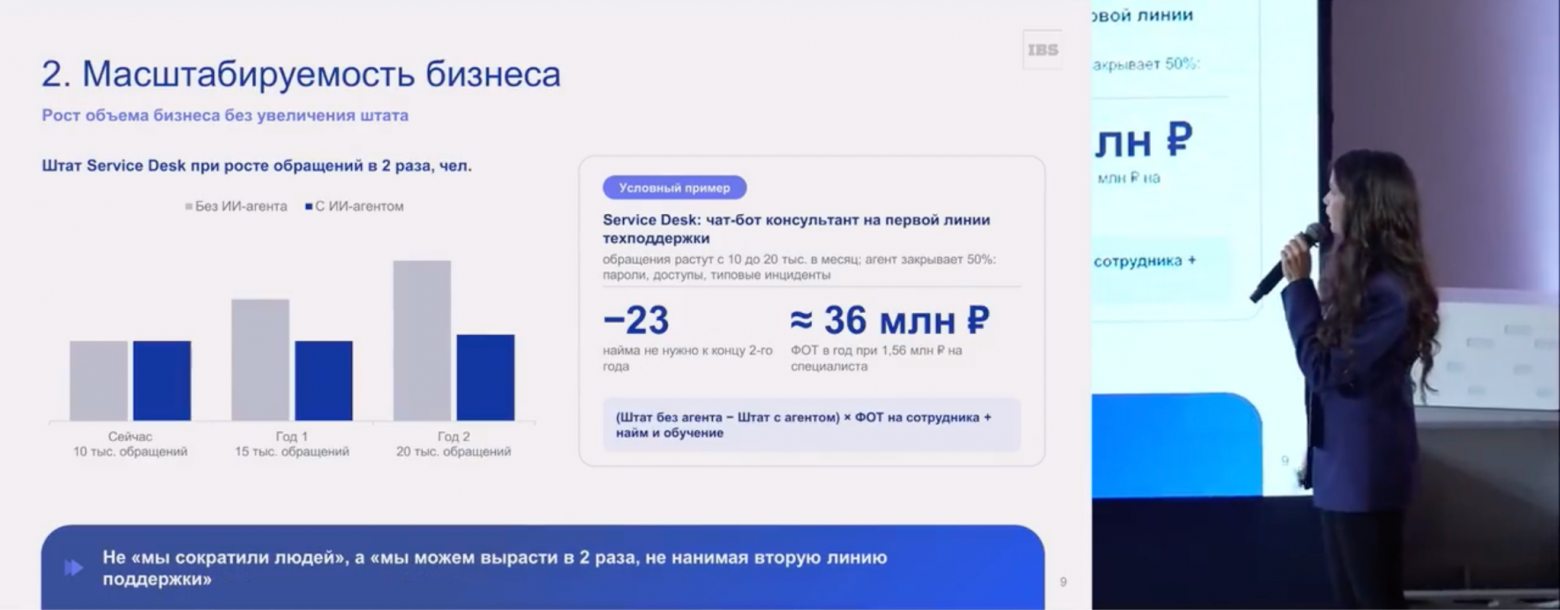
Масштабируемость бизнеса. Бизнес растет без увеличения штата и ФОТ.
Снижение расходов и издержек. Меньше рисков, штрафов и налогов.
Рост выручки. Достигается за счет расширения воронки продаж и ускорения работы с ней.
Удержание клиентов. Агенты улучшают качество сервиса и скорость поддержки.
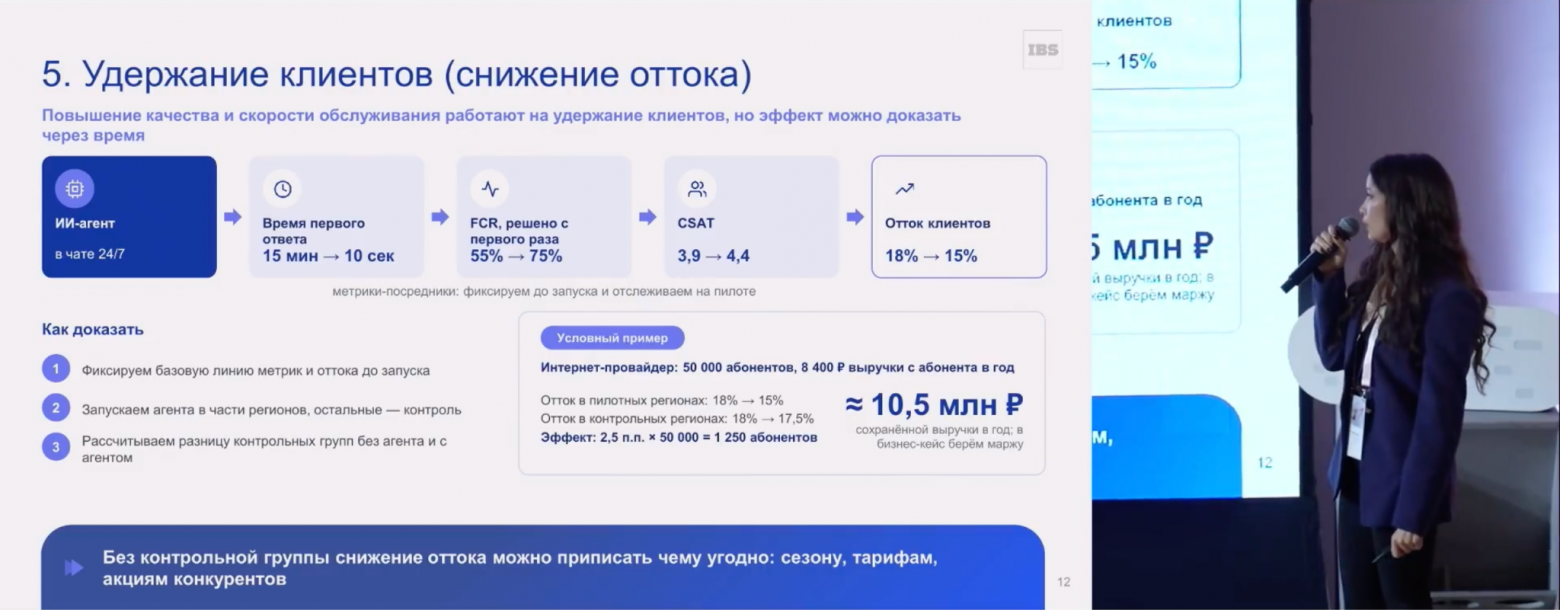
Если первый подход легко доказать, то для пятого нужно считать промежуточные метрики и делить клиентов на две группы: с ИИ и без. Для оценки эффекта достаточно выбрать один подход, можно добавить второй. Если хотите доказать эффект, берите подходы 1–3, если хотите показать амбициозные планы — 4-й и 5-й.
Когда решение о внедрении ИИ принято, сначала проводят аудит процессов по матрице и выбирают для пилота 2–3 процесса. Потом планируют эффекты, выбирают метрики и по ним оценивают результаты пилота. По итогам решают, масштабировать ли внедрение, и составляют план доработки.
С первого дня нужны:
владелец процесса, заинтересованный во внедрении;
ИТ и данные, ведь без качественных данных ничего не взлетит;
риски и ИБ, без этого крупные B2B-клиенты не работают;
бюджет: важно понимать, кто заинтересован во внедрении и кто за него заплатит;
ключевые пользователи, на которых проводят внедрение и проверяют результаты.
Примеры кейсов клиентов IBS:
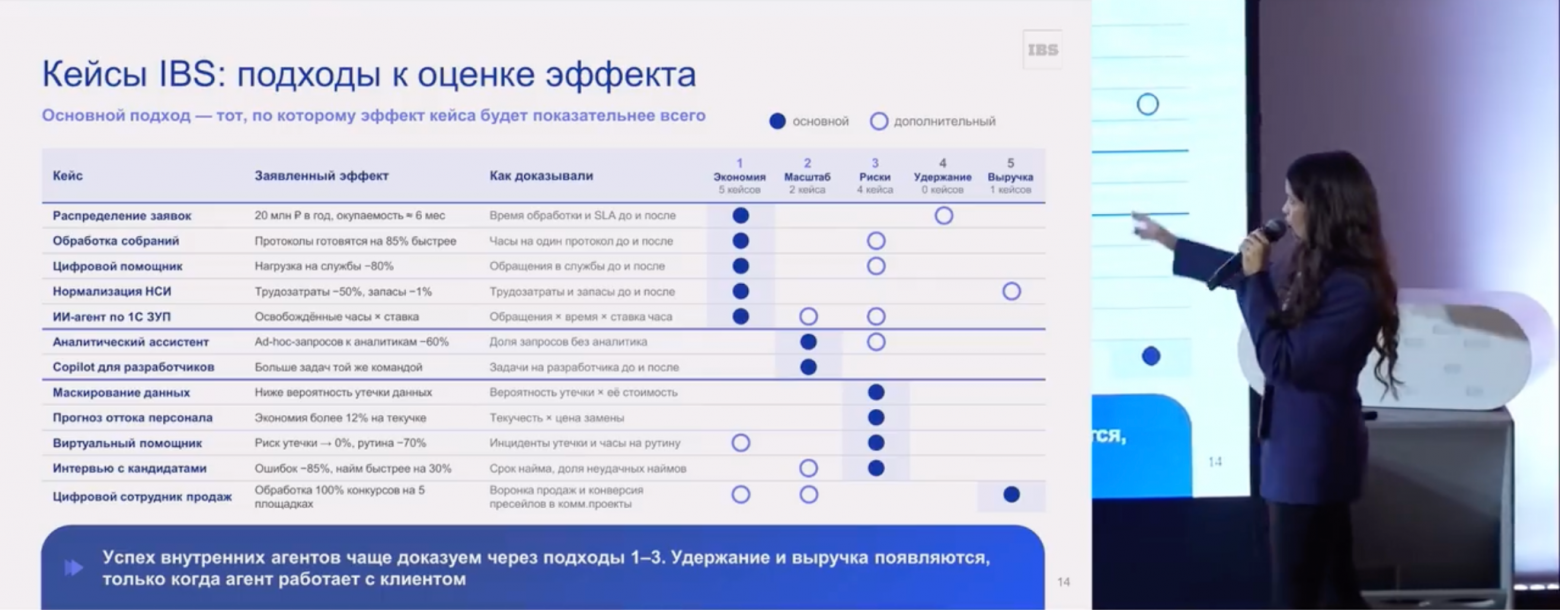
ИИ появился давно, но не было технологий и мощностей для него. Задача, по словам Дарьи, — осознанно применять эти технологии в бизнесе и понимать, какой эффект вы получите.
Как прошел митап
На митапе мне понравились уровень докладов и нейро-DJ, которая объявляла каждого выступающего, а потом играла DJ-сет на афтепати.
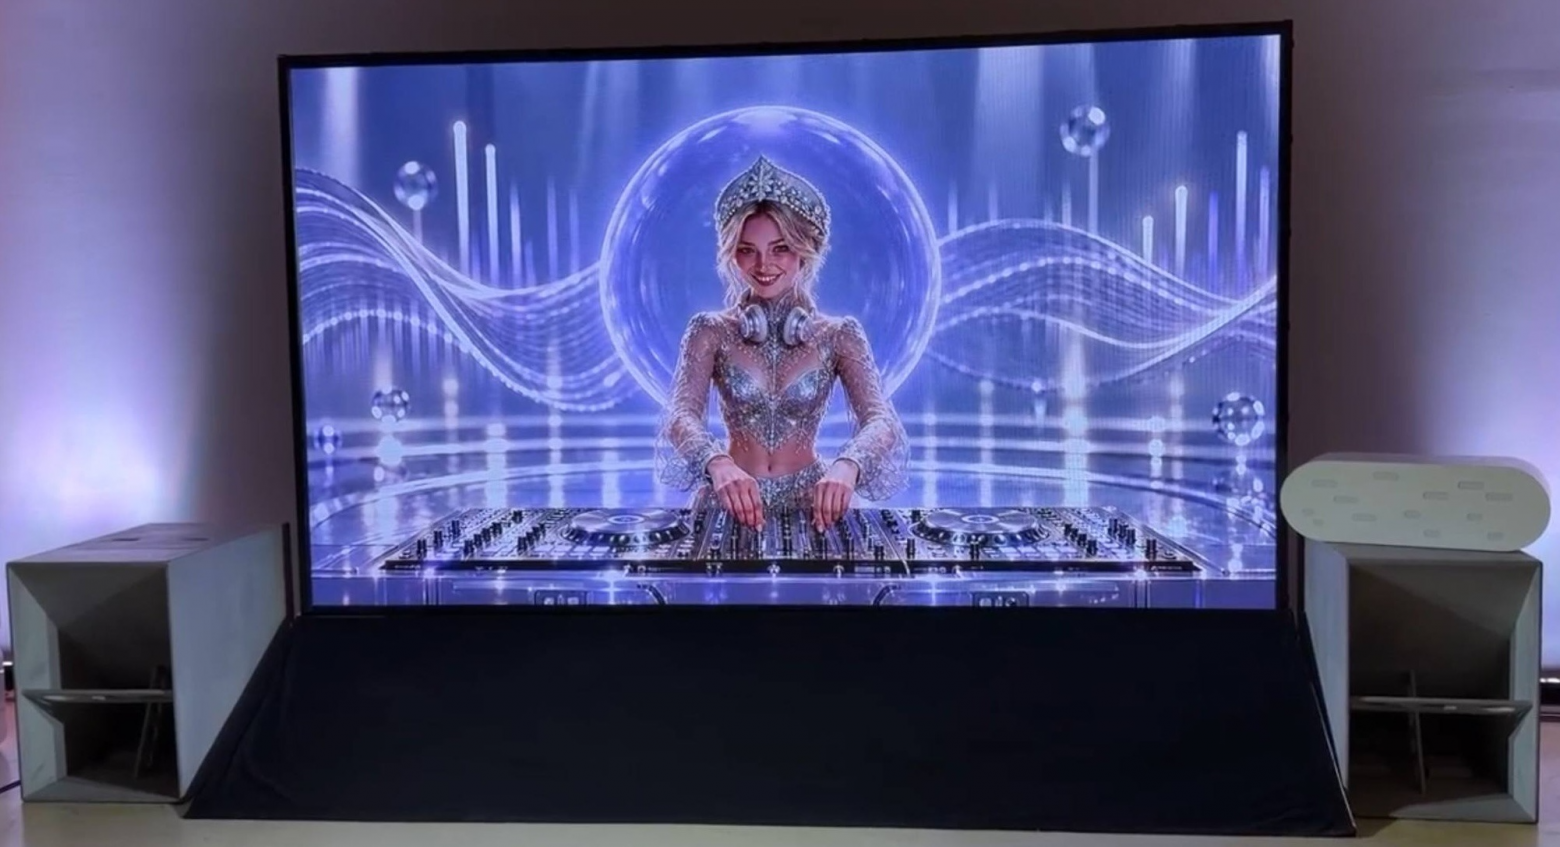
Были закуски, чай и кофе, а на афтепати — пиво и вино. Стульев в зале хватало, и все доклады я слушал сидя. Что можно улучшить в следующий раз: разделить зону выступлений и фуршета. Начиная со второго выступления стало очень шумно, и выступающих не всегда было слышно, хотя, возможно, дело в акустике помещения. Еще я не совсем понял, кто был целевой аудиторией мероприятия. Было много технарей и продактов, в очереди за кофе я пообщался с инвестором, в зале было много руководителей. Это уже третье мероприятие по ИИ за год, на котором я бываю, и на каждом почему-то очень голодные люди налетают на еду.
Я сам когда-то организовывал крупные мероприятия и знаю, что на них всегда что-то идет не так. Если все идет идеально — жди беды. Здесь были негативные моменты, но мероприятие мне понравилось, а информация с митапа для меня крайне важна. Теперь пазл с ИИ у меня наконец сложился: я понимаю, что нужно сделать, чтобы настроить свой харнесс, и что предложить по этому поводу на работе.
Комментарии 0