Три платы Raspberry Pi 5 на столе, а на них — кластер, в котором крутятся контейнеры и виртуальные машины, есть мультитенантность, managed базы данных и всё остальное, что дает Cozystack.
Зачем это нужно? Cozystack обычно ставят на стойку серверов в дата-центре, и чтобы просто пощупать платформу, приходится арендовать железо или поднимать виртуалки в облаке. А три малинки стоят как один вечер в ресторане, помещаются в рюкзак и работают от розетки. На них можно учиться, показывать Cozystack на конференции, отлаживать свою автоматизацию или держать дома маленькое облако. Ну и было интересно проверить, насколько платформу вообще можно ужать и что в ней сломается первым.
Три платы Raspberry Pi 5 на столе, а на них — кластер, в котором крутятся контейнеры и виртуальные машины, есть мультитенантность, managed базы данных и всё остальное, что дает Cozystack.
Статья делится на две части: сначала я расскажу, как вам поставить этого Cozy-франкенштейна на малинки, а потом поплачу о том, как я это делал.
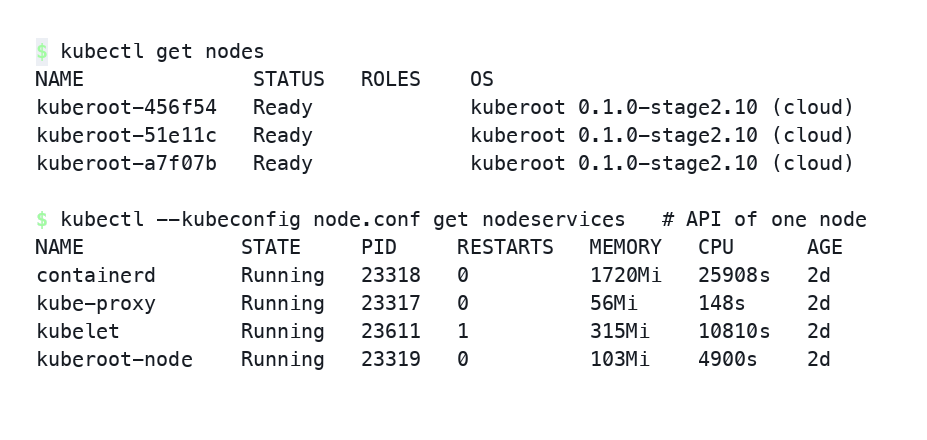
К сожалению, самих малинок у меня не было, так что пока обошелся виртуалками. Хорошо, если вы поставите все это на реальное железо и расскажете, что пошло не так.
Часть первая: как поставить Cozystack на Raspberry Pi
Что понадобится
Я сразу выставил жесткое ограничение: платы Raspberry Pi 5 по 8 ГБ RAM. Малинки на 4ГБ платформу, естественно, не потянут, а малинки на 16ГБ использовать как-то уже совсем неспортивно.
На каждую малинку добавляем по NVMe-накопителю через PCIe-плату и карту microSD под загрузочный образ. На NVMe система устанавливается и там же живёт реплицированное хранилище, а карта нужна только для того чтобы загрузить установщик, после её можно вынуть. Pi 4 тоже сгодится, в этой статье расчёт по памяти сделан именно под четыре ядра Cortex-A76 пятой модели.
Сборка образа
Готового образа Cozystack для малинок нет, его придётся собрать самостоятельно. Причем устанавливать Cozystack на платах мы будем не на Talos, а поверх kuberoot.
kuberoot — мой экспериментальный проект, набор для сборки дистрибутивов Kubernetes, которые сами себе операционная система: ядро Linux, init, kubelet и control plane упакованы в один образ, а узлом управляют через kubectl, как любым другим объектом кластера. Вырос он из моей старой статьи «Неизбежное будущее Kubernetes» о том, что оркестратору пора пойти путём ядра Linux и обрасти дистрибутивами, а подробно про устройство kuberoot я рассказывал в отдельной статье.
Я выбрал kuberoot, потому что иначе пришлось бы тащить штатный для Cozystack KubeVirt, а на малинках он упирается в железо: у Pi нет hugepages, а импорт дисков в CDI на arm64 пока никто не проверял. Плюс сам KubeVirt выглядит оверхэдом для таких скромных ресурсов. В kuberoot есть бандл cloud, который запускает на одном узле и контейнеры, и виртуальные машины, причём машины рабоают напрямую через KVM процессами Cloud Hypervisor, без KubeVirt и libvirt. Сам kuberoot вместе с control plane и etcd занимает около гигабайта на одну ноду, остальное остаётся платформе.
Поддержка Raspberry Pi для kuberoot пока живёт в ветке integration/pi-cloud:
git clone -b integration/pi-cloud https://github.com/kuberoot-dev/kuberoot.git
cd kuberoot
Все файлы, о которых дальше идёт речь, — скрипты сборки, манифест сборщика, патч для гипервизора — лежат в этой ветке, их можно посмотреть и на GitHub.
Из этих исходников собирается ядро с модулями DRBD для реплицированного хранилища, программы на Go, рутовая файловая система, initramfs и гипервизор Cloud Hypervisor, который для arm64 компилируется из Rust. Сборка объёмная: ей нужно около 60 ГиБ под исходники, кэши компиляторов и результаты, до 16 ГиБ памяти и несколько часов процессорного времени. Поэтому я собирал ее на виртуалке в облаке, а не на своем маке. Под описан в hack/hetzner/builder.yaml: в нём контейнер с Go и инструментами для ядра, контейнер с Alpine для сборки корневой системы и маленький HTTP-сервер, через который потом забирается результат. Сборщик рассчитан на Cozystack и просит том класса replicated; при сборке в своем кластере поменяйте storageClassName на свой.
Управляет сборщиком скрипт hack/hetzner.sh, который запускается на вашей машине: он копирует в под исходники, запускает там сборку и собирает из её результатов образ загрузочной карты. Название скрипта досталось от первого стенда и ни к чему не обязывает. Кластер, контекст и пространство имён скрипт берёт из переменных окружения:
export KUBECONFIG_WORKSHOP=~/.kube/config   # kubeconfig кластера для сборщика
export KUBE_CONTEXT=my-cluster              # контекст в нём
export KUBEROOT_NS=kuberoot-build           # пространство имён (должно существовать)

hack/hetzner.sh builder                     # создать под-сборщик и его том
KUBEROOT_DISTRO=cloud hack/hetzner.sh build arm64
KUBEROOT_DISTRO=cloud hack/hetzner.sh media arm64
build собирает всё перечисленное выше, а Cloud Hypervisor — из закреплённых исходников и с патчем, без которого на реальных платах виртуальные машины не заведутся. media собирает из них образ загрузочной карты media.img, дальше в статье я называю его носителем. В носитель для arm64 вдобавок попадают прошивочные блобы Raspberry: их никто не собирает, их скачивают, прибив гвоздями к конкретному выпуску, и media делает это сама.
Для гипервизора сборщику нужен кросс-компилятор GCC 12 для aarch64-linux-gnu и Rust 1.93.0 с целью aarch64-unknown-linux-gnu. Версия Rust берётся из закрепления в build/cloud-hypervisor/pin.env, а не та, что сегодня считается стабильной. Ставить их руками не нужно: скрипт доставит их в под сам, а если не сможет — скажет, какого именно инструмента не хватает.
В версии, о которой идёт речь в статье, сборка cloud даёт такие файлы:
Файл | Размер |
|---|---|
| 473 МиБ |
| 281 МиБ |
| 22,5 МиБ |
| 5,9 МиБ |
| 1,9 МиБ |
Гипервизор собран статически и уже лежит в корневой файловой системе образа, в /usr/bin/cloud-hypervisor, так что на плату ничего доставлять не нужно. Рядом, в /usr/share/kuberoot/cloud-hypervisor-build.json, записано, из каких исходников и каким компилятором он собран.
Перед тем как записывать образ на карту, стоит проверить, что собралось именно то, что нужно. Рядом с бинарниками гипервизора лежит файл vmm/build-contract, в котором сборка сама указывает архитектуру, версию Rust и возможность, которую добавил патч:
architecture=arm64
target=aarch64-unknown-linux-gnu
rust_version=1.93.0
features=kvm
capability=arm-gicv2-acpi-cpu-hotadd-v1
Запись носителя
Готовый media.img надо скачать со сборщика (он раздаёт результаты по HTTP) и сверить контрольную сумму:
kubectl --context "$KUBE_CONTEXT" -n "$KUBEROOT_NS" port-forward svc/builder 8080:8080
curl -O http://127.0.0.1:8080/arm64/media.img
shasum -a 256 media.img
Теперь записываем образ на карту. Сначала найдите её в списке дисков и внимательно проверьте, что это именно она: dd сотрёт на выбранном диске всё.
diskutil list external physical          # macOS; на Linux — lsblk
diskutil unmountDisk /dev/diskN
sudo dd if=media.img of=/dev/rdiskN bs=4m status=progress
sync && diskutil eject /dev/diskN
На macOS записывайте в rdiskN, а не в diskN: это устройство без буферизации, и запись идёт примерно на порядок быстрее. На Linux то же самое делается в /dev/sdX с bs=4M oflag=direct.
Одна и та же карта подходит для всех трёх плат: под конкретную плату на ней ничего не настроено, так что карты можно не подписывать.
Первая плата и выбор базы данных кластера
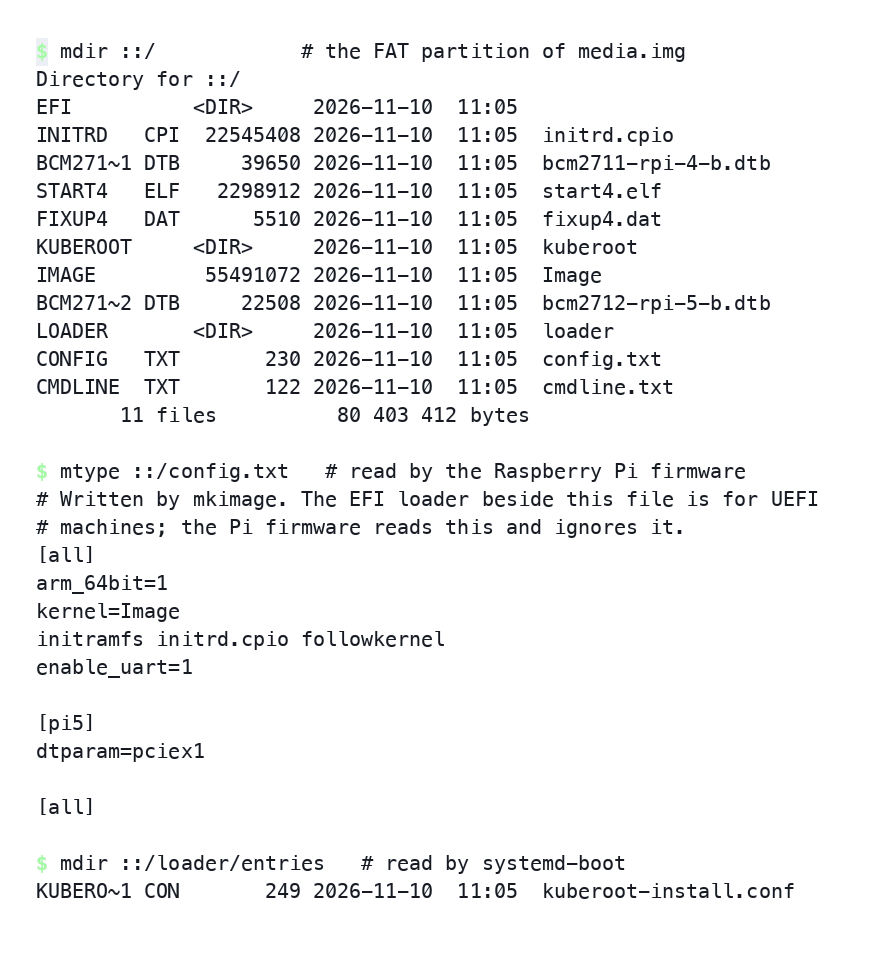
Вставьте карту в первую плату и включите питание. Прошивка Raspberry берёт с FAT-раздела карты config.txt, а systemd-boot — каталог /loader с того же раздела. Друг другу они не мешают, поэтому один и тот же образ загружает и плату, и виртуальную машину.
Pi 5 больше ничего не нужно: вся его прошивка хранится в EEPROM. А Pi 4 нужны ещё файлы прошивки, потому что в его EEPROM записан только первый этап загрузчика, — но они на карте уже есть.
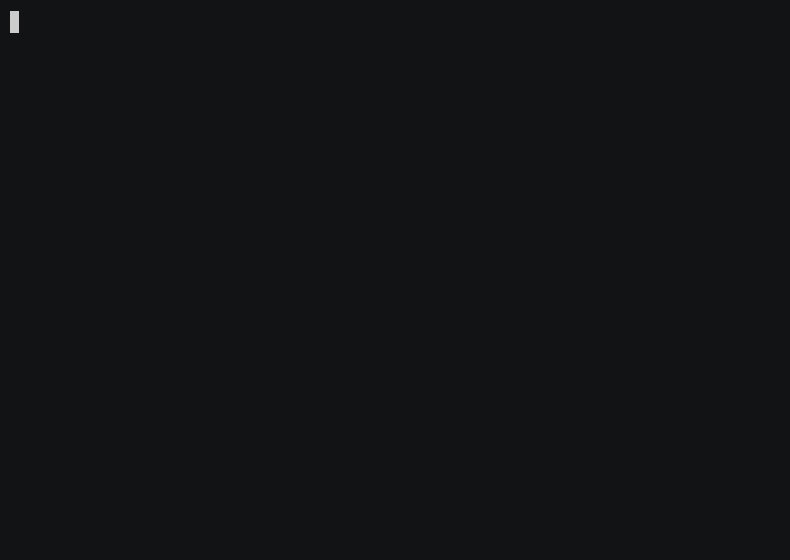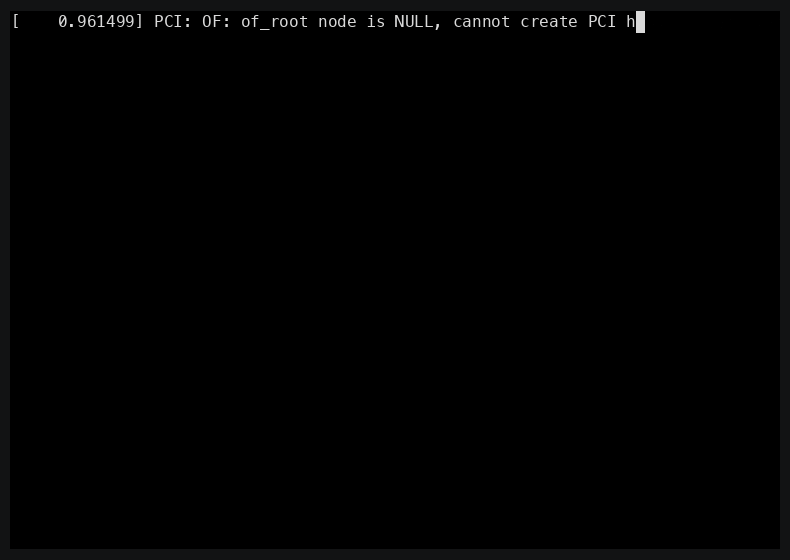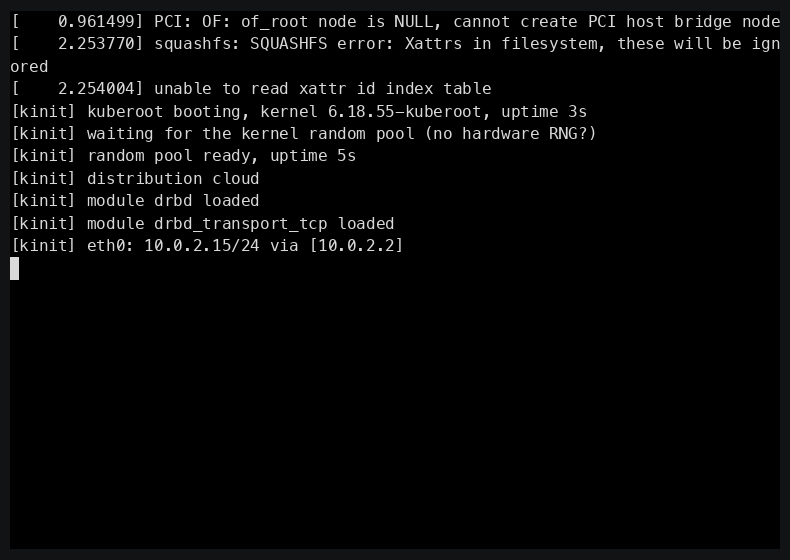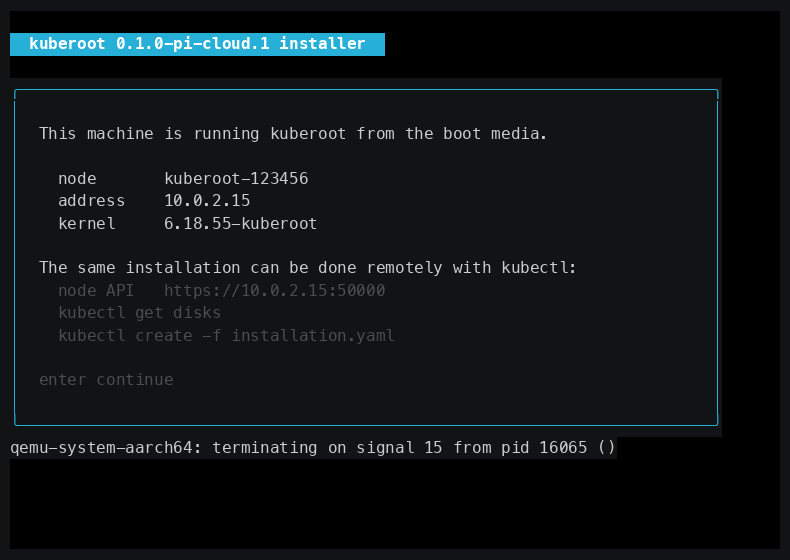
Плата загружается в установщик, он поднимает API узла и сам подсказывает, как к нему подключиться:
kuberoot 0.1.0-pi-cloud.1 installer

  This machine is running kuberoot from the boot media.
    node       kuberoot-123456
    address    10.0.2.15
    kernel     6.18.55-kuberoot

  The same installation can be done remotely with kubectl:
    node API   https://10.0.2.15:50000
    kubectl get disks
    kubectl create -f installation.yaml
Ни SSH, ни командной оболочки на этих узлах нет. Узлом управляют через API Kubernetes, в том числе когда кластера ещё нет: именно так его и устанавливают. Можно продолжить с консоли платы, но удобнее сразу работать через kubectl со своего компьютера — с остальными двумя платами всё равно придётся делать так.
На первой плате выбирается база данных кластера, и поменять её потом нельзя. Для трёх управляющих узлов нужен etcd, поэтому первую плату надо загрузить с параметром ядра kuberoot.datastore=etcd. Он задаётся при сборке образа карты:
hack/hetzner.sh media arm64 kuberoot.datastore=etcd
Кластер, созданный на kine (это хранилище для одного узла поверх SQLite), так на kine и останется. Автоматического перехода на etcd нет: пришлось бы поднимать новый кластер и переносить нагрузки руками.
Теперь установка на NVMe:
apiVersion: node.kuberoot.dev/v1alpha1
kind: Installation
metadata:
  name: install
spec:
  disk: nvme0n1
  reboot: true
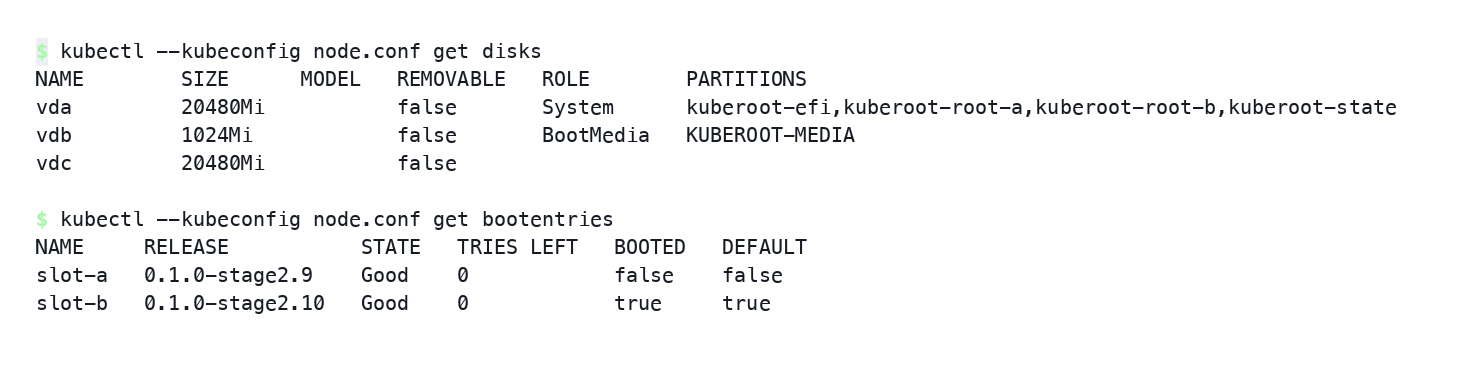
Имя диска покажет команда kubectl get disks, если направить kubectl на API узла — адрес установщик выводит в консоли. Установщик разобьёт накопитель на EFI-раздел с systemd-boot, два корневых раздела и раздел для данных, а затем перенесёт туда ключи узла, сведения о кластере и, если узел управляющий, снимок базы данных кластера. Корневых разделов два, и это сделано, чтобы правильно выполнять обновления: новая версия записывается в неактивный раздел и загружается в пробном режиме, и если за пять минут узел не стал Ready, он вернётся на прежнюю версию.
Оставшиеся малинки
Остальные две платы ставятся с такой же карты и точно так же (можно сразу записать три карты). Потом их надо присоединить к кластеру как менеджмент-ноды, и делать это необходимо в кластере, а не на нодах:
apiVersion: node.kuberoot.dev/v1alpha1
kind: JoinTicket
metadata: {name: cp-2}
spec:
  nodeName: kuberoot-dcaf7a
  role: ControlPlane
  address: 10.0.0.12
По такому JoinTicket узел добавляется в etcd сначала в режиме learner: он копирует себе данные кластера, но в кворуме пока не участвует. Полноправным участником etcd он становится, когда получит все данные и синканется с остальными узлами.
Порядок важен: сначала установка, потом присоединение. Если сделать наоборот, установщик запишет на диск etcd из одного участника, и база на узле разойдётся с кластерной.
Рабочие узлы, если вы добавите их позже, ходят к API-серверу через локальный балансировщик, встроенный в API узла. Он следит за сервисом kubernetes и сам узнаёт, какие управляющие узлы появились, а какие пропали. Поэтому не нужны ни виртуальный IP, ни внешний балансировщик, и всё работает в обычной домашней сети.
Хранилище
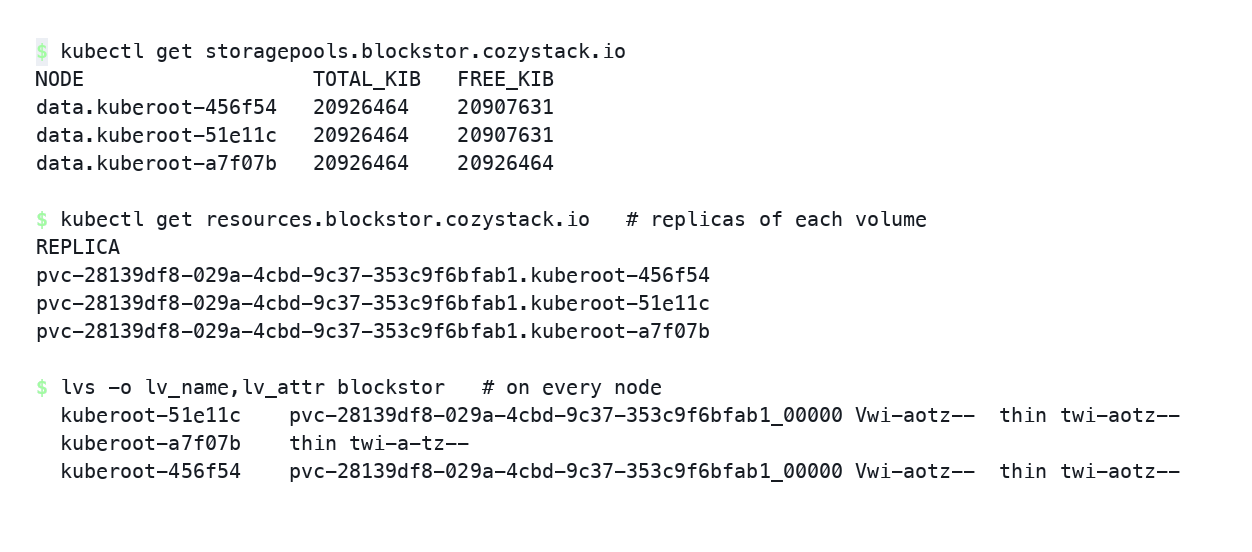
Реплицированные диски даёт blockstor. Он реплицирует тома через DRBD поверх thin pool LVM (пула с тонким выделением места) на NVMe каждой платы и отдаёт API, совместимый с LINSTOR, поэтому сверху работает обычный CSI-драйвер LINSTOR. На трёх узлах при placementCount: 2 у тома две копии с данными, а третья плата получает реплику без данных: через неё под на этой плате работает с томом по сети.
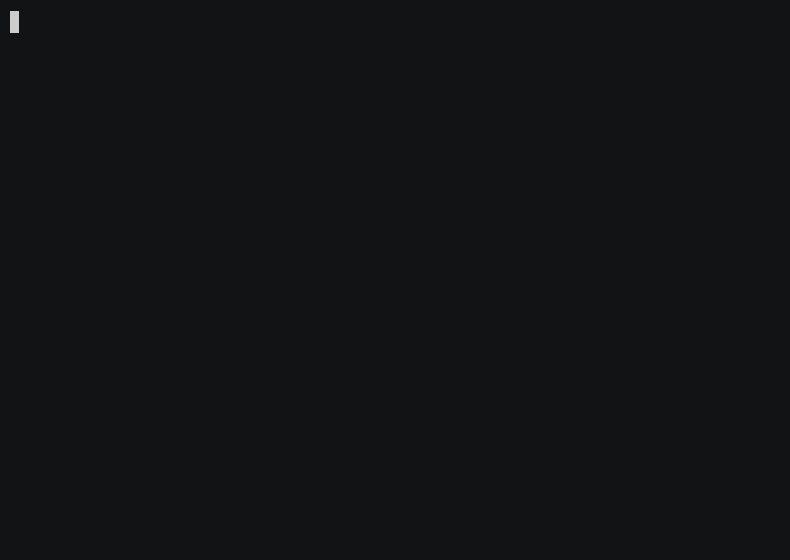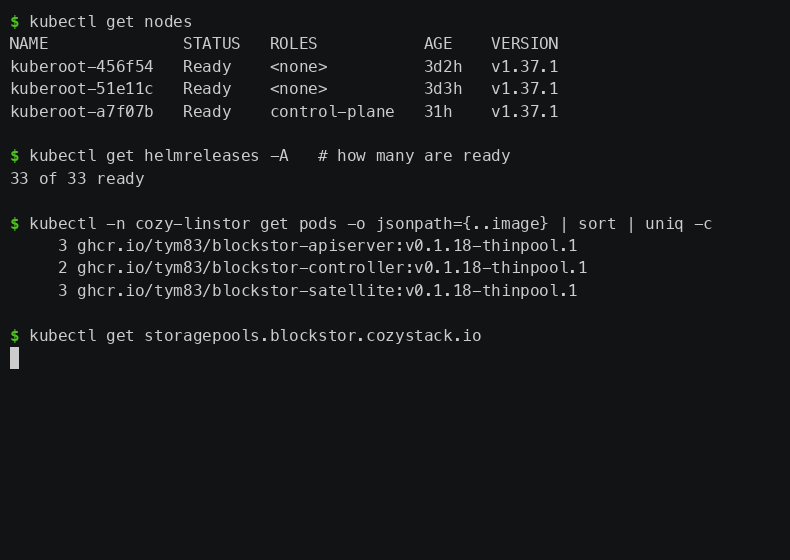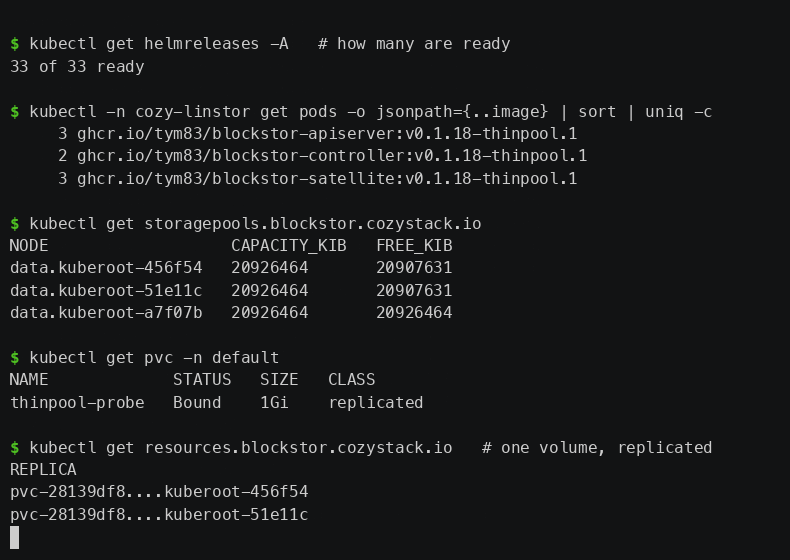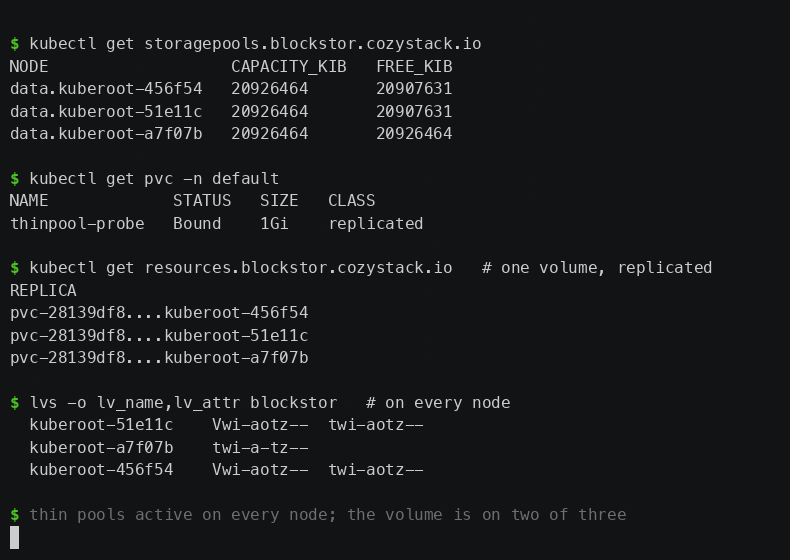
Об одной особенности лучше знать до первой перезагрузки платы. После перезагрузки thin pool остаётся на диске, но не активируется, и пока его не активировать, LVM не сообщает, насколько он заполнен. blockstor видит в пуле отсутствие свободного места, пропускает эту плату, и тома перестают создаваться во всём кластере с сообщением, что не хватает узлов или пулов, — хотя все узлы в сети и пулы на месте. Поэтому после каждого обновления узлов проверяйте пул в поде blockstor-satellite на каждой плате:
lvs -o lv_name,lv_attr blockstor
У активного пула атрибуты начинаются с twi-a, у неактивного — twi---tz--, и его надо поднять командой lvchange -ay blockstor/thin. В сборке из статьи это уже исправлено: blockstor сам активирует неактивный пул и перечитывает его ёмкость, исправление отправлено в апстрим (cozystack/blockstor#229). Если ставите blockstor без него, проверяйте вручную.
Установка Cozystack
Кластер поднят, хранилище работает — пора ставить Cozystack, который и даст тенантов, управляемые базы данных, виртуальные машины и тенантные Kubernetes-кластеры.
Ставить нужно не обычный Cozystack, а мой форк cozyroot, выпуск v1.7.0-alpha.13. Обычный Cozystack рассчитан на серверы, и на трёх платах по 8 ГиБ без переделок не поместится и не переживёт потерю узла. Вот что я поменял в форке:
Хранилище без Java. Вместо LINSTOR, которому нужна JVM, хранилищем управляет blockstor с тем же API — на плате с 8 ГиБ это экономит заметную часть памяти.
Сеть cozyplane. Сеть подов и тенантов на eBPF вместо Kube-OVN, которому нужен Open vSwitch в ядре.
Размеры компонентов под железо. Запросы памяти и процессора у компонентов платформы теперь задаются под конкретное железо, а не одни на все случаи. Без этого платформа просила больше памяти, чем есть на плате.
Способность пережить потерю узла. Flux, оператор Cozystack, его контроллер, дашборд и контроллер объектного хранилища теперь работают в двух копиях на разных узлах или возвращаются сами, когда их узел пропал. Добавлено предупреждение мониторинга, если кластер больше не может потерять ни одного узла.
Мелкие исправления вроде правильного домена кластера вместо зашитого
cozy.localи остановленной виртуальной машины, которая больше не числится сломанной.
Каждое изменение — отдельный PR в репозитории форка, в апстрим Cozystack я их пока не отправлял.
И еще два момента, которые на этом железе надо настроить правильно с первого раза.
Первый — адрес API-сервера. В режиме generic оператор Cozystack берёт его из настроек и записывает в собственный Deployment. Если указать адрес конкретной платы, то после её замены оператор так и будет подключаться туда, где никого нет, и пересоздание пода не поможет, потому что адрес зашит в Deployment. Укажите вместо этого локальный балансировщик, который есть на каждом узле:
cozystack:
  apiServerHost: 127.0.0.1
  apiServerPort: 6444
Это касается всех компонентов, которым нужен адрес API-сервера, в том числе k8sServiceHost и k8sServicePort у Cilium. Адрес 127.0.0.1:6444 переживает потерю или замену любой платы и работает для компонентов с hostNetwork: true.
Второй — память. Из 8 ГиБ на плате дистрибутив оставляет за системой 3,5 ГиБ: 1 ГиБ уходит в пул памяти для виртуальных машин, 2,5 ГиБ — на службы самого узла и процессы гипервизора. Подам остаётся около четырёх. Размер пула задаёт параметр API узла --machine-memory-budget-mib=1024. Если подстраиваете это под платы с другим объёмом памяти, меняйте всё вместе: пул для машин, резерв kubelet и лимиты памяти отдельных служб.
Запуск виртуальной машины
Виртуальная машина описывается обычным ресурсом Kubernetes, а гипервизор работает процессом на узле, а не в поде:
apiVersion: vm.kuberoot.dev/v1alpha2
kind: VirtualMachine
metadata:
  name: worker
  namespace: default
spec:
  cpus: 1
  maxCPUs: 4
  memory: 1Gi
  maxMemory: 1Gi
  replicas: 1
  disk:
    size: 4Gi
    image: https://example.org/debian-13-uefi.qcow2
maxCPUs и maxMemory позволяют менять размер машины без перезагрузки: увеличиваете cpus или memory в этих пределах, и работающий гость получает ресурсы сразу. Сами пределы задаются при создании машины и потом не меняются — ни добавить, ни убрать их нельзя. Машина без пределов устроена проще: при смене размера она перезапускается.
На плате тут два ограничения. Первое: весь maxMemory сразу резервируется в пуле виртуальных машин узла, даже если гостю пока отдана малая часть. С пулом по умолчанию в 1 ГиБ машину с maxMemory: 4Gi поэтому просто не создать — либо держите пределы небольшими, либо увеличивайте пул вместе с резервом. Второе: при заданном maxMemory оба значения памяти должны быть кратны 128 МиБ, этого требует virtio-mem.
Добавлять процессоры на ходу на ARM можно, только если это поддерживает сам гипервизор. Перед запуском API узла спрашивает у cloud-hypervisor список его возможностей и ищет в нём горячее добавление процессоров с KVM и GICv2, до восьми виртуальных процессоров. Если поддержки нет или гипервизор не ответил, машина не запускается, причём раньше, чем будет остановлено что-то уже работающее. Как раз для этого и нужна пропатченная сборка, о ней — вторая часть.
Что получилось
В итоге на столе стоят три малинки, и вместе они — полноценное маленькое облако. Все три платы равноправны: на каждой свой API-сервер и своя копия etcd, поэтому кластер переживает выключение любой из них, а данные томов лежат в двух копиях на разных платах. Сверху работает Cozystack с дашбордом и своим API, и пользоваться им можно так же, как обычной инсталляцией в дата-центре.
Через дашборд создаёте тенант, а в нём заказываете то, что нужно: PostgreSQL или другую управляемую базу данных, виртуальную машину. Всё это ставится из тех же пакетов, что и в обычном Cozystack, без переделок под малинки. Тот же набор доступен через kubectl и API Cozystack, так что на этих платах можно отлаживать свои манифесты, CI и автоматизацию, прежде чем нести их на настоящее железо.
Ресурсов, конечно, немного: на каждой плате подам остаётся около 4 ГиБ, а виртуальным машинам — гигабайт. Пара баз и пара небольших виртуалок влезут, нагруженный продакшен — нет. Зато это настоящая платформа с тенантами, хранилищем и отказоустойчивостью, которую можно унести в кармане: для домашней лаборатории, стенда на конференции или обучения работе с Cozystack.
Часть вторая: что пришлось переделать
Почти все правки, о которых пойдёт речь ниже, сделаны в kuberoot — в образе, который ставится на платы, и в его сборке. Это мой экспериментальный проект, так что «внёс исправление» здесь значит «поправил у себя», а не «закинул в апстрим большого и важного проекта». Cozystack менять не пришлось, хватило правльных нстроек.
Контроллер прерываний
Cloud Hypervisor на ARM работает только с контроллером прерываний GICv3, а в процессоре BCM2712 у Raspberry Pi 5 стоит более старый GICv2. Из-за этого обычный Cloud Hypervisor не может запустить на Pi 5 ни одной виртуальной машины, и без исправления всё, что я выше писал про виртуалки, на плате бы не заработало.
Обойти это настройками нельзя: гостевая ВМ получает тот контроллер прерываний, который есть у железа хоста, а GIC-400 — это GICv2. У серверных ARM-процессоров есть GICv3 с расширениями для виртуализации, часть из них умеет ещё и эмулировать GICv2. У Pi есть только GICv2, так что гипервизор, который знает лишь GICv3, гостевую ВМ на нём не запустит вообще.
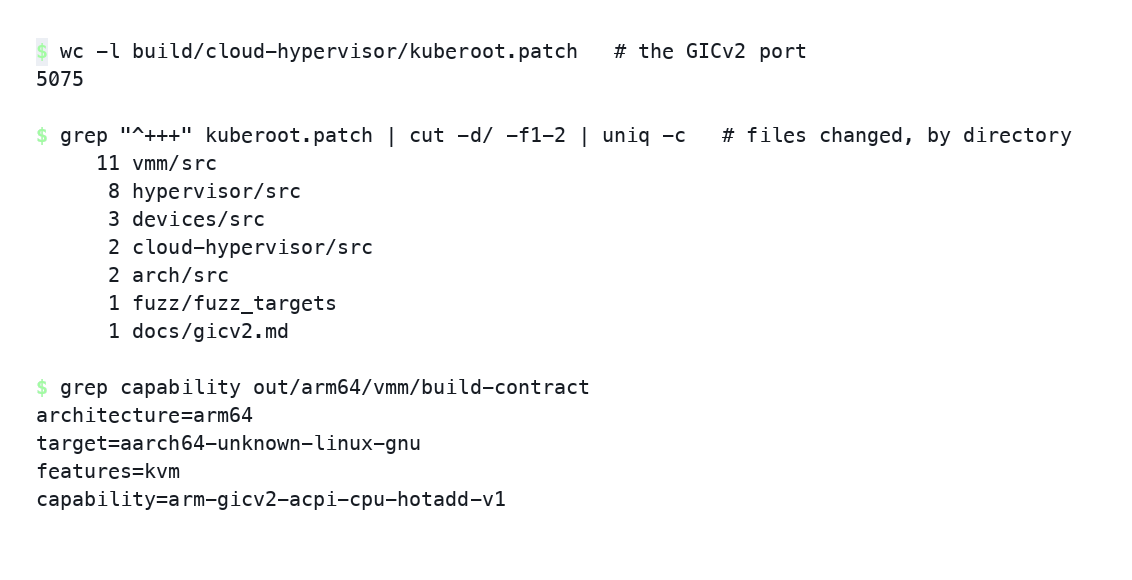
Поэтому я написал патч к Cloud Hypervisor. Он лежит в репозитории kuberoot, в build/cloud-hypervisor/kuberoot.patch, и накладывается на исходники Cloud Hypervisor при сборке образа; в сам Cloud Hypervisor я его не отправлял. Патч добавляет поддержку GICv2, а там, где есть GICv3, по-прежнему выбирается он: на сервере ничего не меняется, на плате работает другая ветка кода. Это около пяти тысяч строк поверх Cloud Hypervisor v53.0, и больше всего работы потребовал не сам контроллер прерываний, а то, что от него зависит: таблицы ACPI, которые описывают гостю систему с GICv2, и горячее добавление процессоров, которое должно сообщать гостю о новом процессоре через эти таблицы, а не через механизмы GICv3, как в апстриме.
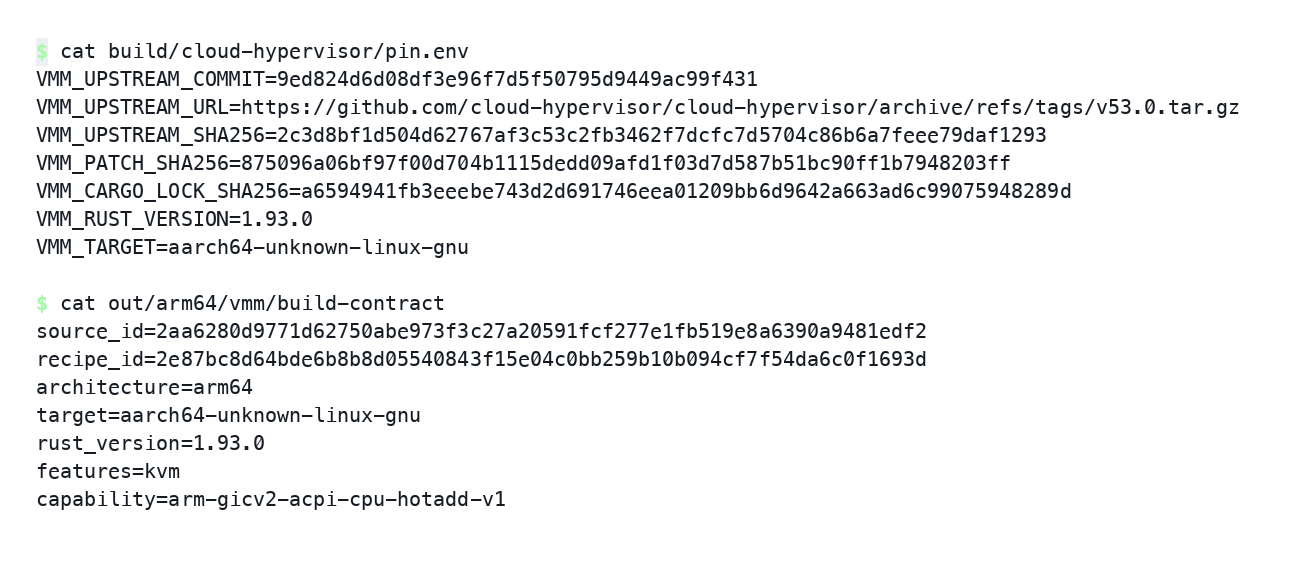
Патч большой, поэтому сборка сама подтверждает, из чего и что именно она собрала. В pin.env записаны коммит апстрима и контрольные суммы архива, патча и Cargo.lock; если не совпадает хоть одна, сборка останавливается. Исходники проверяются по контрольной сумме, а не по тегу, который можно передвинуть. Собранный бинарник сообщает о себе capability=arm-gicv2-acpi-cpu-hotadd-v1, и API узла спрашивает об этом сам бинарник, прежде чем запускать машину с пределами роста. Для проверки и для запуска берётся один и тот же открытый файл, чтобы его нельзя было подменить в промежутке. Запасного варианта с обычной сборкой нет намеренно: если гипервизор не умеет того, что нужно, он должен явно отказаться, а не запускать гостей, которые потом поведут себя иначе.
Память на плате с 8 ГиБ
Больше всего возни было с памятью, и ошибки здесь пригодятся не только тем, кто ставит Cozystack на малинки.
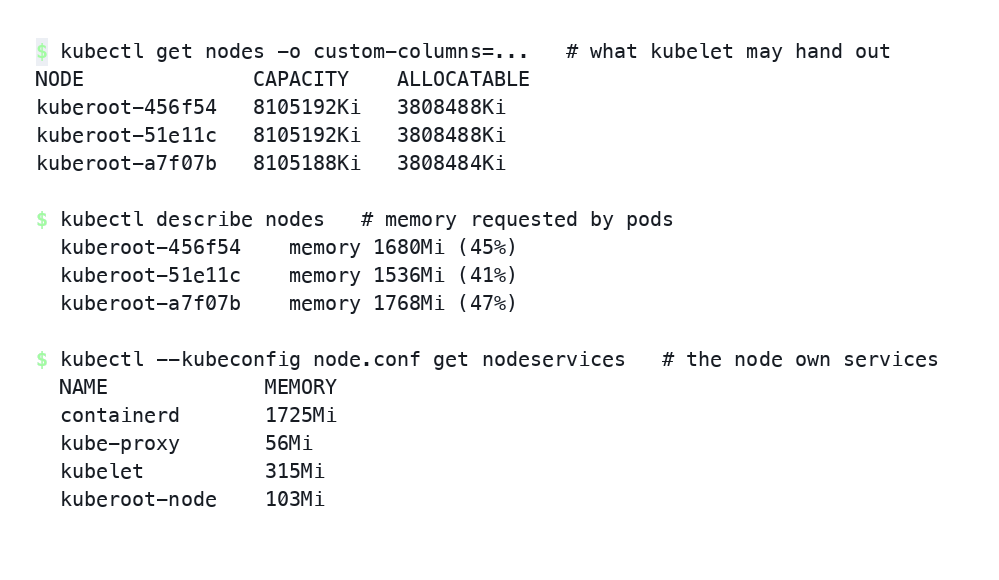
В первой попытке я рассчитывал резерв в основном под гостей: 4 ГиБ в пул, 2 ГиБ на службы. Подам осталось 1,6 ГиБ, и платформа просто не установилась. Ошибка очевидная, нашлась за минуты.
Тогда я поднял резерв под службы до 2 ГиБ. Установка прошла, но проблема стала куда хуже. Kubelet принимал поды, считая свободной память, которую уже занимали службы узла, и тут же начинал эти поды вытеснять. После каждого вытеснения оставался объект пода. Кэш API-сервера рос на этих объектах, API-сервер съедал больше памяти, вытеснений становилось ещё больше — и кластер застрял в состоянии, где вытеснял тысячи подов в час, а со стороны выглядел просто нагруженным. Вывод: сначала измерить, сколько памяти службы занимают на работающем узле, и только потом выбирать резерв. На этом профиле службы занимают около 3,3 ГиБ, резерв — 3,5.
Была и вторая проблема, менее заметная. Теперь у каждой службы узла задан GOMEMLIMIT, примерно вдвое выше измеренного рабочего объёма. Без него сборщик мусора Go даёт куче вырасти до двойного объёма живых данных и неохотно возвращает память системе: один всплеск — массовое удаление объектов или перестройка кэша — надолго поднимает потребление службы. API-сервер так дошёл до 2,1 ГиБ и держался на этом уровне до перезапуска. На сервере этого никто не заметит, а на плате с 8 ГиБ от этого зависит, влезет платформа или нет.
И резерв, и GOMEMLIMIT настраиваются в kuberoot, в дистрибутиве cloud: это свойства образа, который стоит на плате, а не Cozystack.
Носитель и установщик — одно целое
Тест, который ставил предыдущую версию и обновлял её до текущей, начал падать, и всегда в одном и том же месте: установка не доходила до конца. Это выглядело как ошибка обновления.
Дело оказалось не в обновлении. Расположение файлов на носителе — часть той же версии, что и установщик: mkimage раскладывает файлы, а установщик знает, где их искать. Тест собирал оба носителя программой mkimage из текущей ветки, и получалась смесь: новая раскладка и старый установщик. Текущая ветка перенесла initramfs в корень носителя и умела находить его в обоих местах, а предыдущая версия искала только там, где он лежал раньше. Поэтому она записывала загрузчик и ядро и останавливалась. А раз симптом был «установка не заканчивается», а не «файл не найден», на смену раскладки это совсем не походило.
Исправил я это в тесте kuberoot: каждый носитель теперь собирается из исходников той версии, которая с него загружается, и тест берёт для этого исходники предыдущей версии. Вывод тут общий: если инструмент читает файлы, которые записал другой инструмент, их версии должны совпадать, а когда не совпадают, ошибка вылезает совсем не там, где расхождение.
Две ошибки, которые пытались скрыться
Сборка гипервизора под arm64 завершилась с кодом 1 и без единого сообщения об ошибках. Последней строкой в журнале был успешно пройденный шаг, и казалось, что сборка упала на уже сделанной работе. Виновата была проверка command -v для кросс-компилятора: при set -e она завершает скрипт, ничего не написав. А ни компилятора, ни Rust в сборщике не было вовсе. Теперь каждый инструмент проверяется там, где впервые нужен, и если его нет, скрипт называет его по имени — вместо загадки получилась одна понятная строка.
Следующую попытку kubelet вытеснил прямо посреди сборки. В сообщении был назван один контейнер: Rust установился в его домашний каталог и забил маленький локальный диск. Но лимит на временное хранилище считается на весь под, поэтому убиты были все четыре контейнера вместе с идущей сборкой. Временные файлы компиляторов, GOPATH и кэш Go манифест по той же причине уже держал на постоянном томе. Теперь туда переехал и Rust, а RUSTUP_HOME, CARGO_HOME и PATH к ним заданы в манифесте, а не выставляются скриптом. Обе правки — в скриптах сборки kuberoot и манифесте сборщика.
Две поломки, которые видно только после замены узла
Обе вылезли, когда я вывел из кластера один управляющий узел и присоединил вместо него новый. До этого их не было видно.
Оператор Cozystack ушёл в цикл падений, набрал 257 перезапусков и всё пытался подключиться к выведенной плате. Адрес не застрял где-то в состоянии пода и не лежал в ConfigMap: он был записан в Deployment при установке платформы в режиме generic. Пересоздание пода ничего бы не изменило. Код Cozystack здесь править не пришлось, хватило настройки при установке, которую я описал в первой части: направить оператор на локальный балансировщик узла 127.0.0.1:6444. Он есть на каждом узле и поэтому переживает замену любой платы. Cilium на этих узлах уже ходит по тому же адресу.
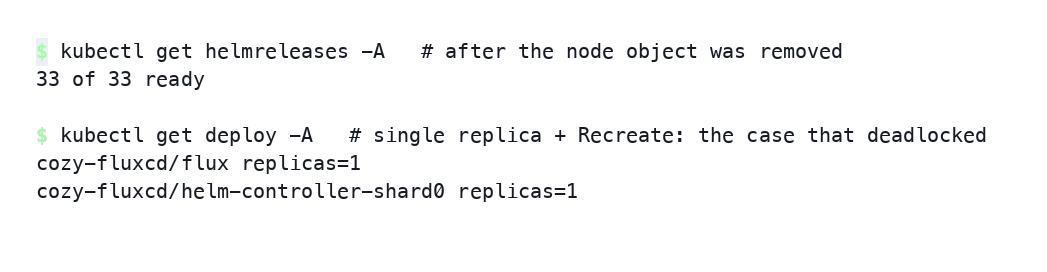
Вторая поломка застопорила проект на сутки. Flux простоял 29 часов, и снаружи это выглядело так: все HelmRelease в дереве жаловались, что зависимость не готова, а корневой при этом сообщал, что готов. Причиной был Deployment с одной репликой и стратегией Recreate, при которой новый под создаётся только после того, как старый полностью исчезнет. Старый под висел в Terminating на выведенной плате, то есть вечно, и новый так и не появлялся. Сами HelmRelease были ни при чём: они показывали состояние, которое уже никто не обновлял.
Кода здесь тоже никто не правил, помогло ручное действие — удаление объекта Node выведенной платы: сборщик мусора убрал все пятнадцать зависших подов, контроллер получил новый под, и тридцать три HelmRelease сами стали Ready. Вывод общий: под, зависший в Terminating на мёртвом узле, перестаёт быть мелочью, как только его контроллер не может создать замену. А Recreate с одной репликой — именно такой случай.
Что проверено, а что нет
На настоящем железе не проверено ничего: плат у меня нет.
В эмуляторе, на том же образе, который пошёл бы на карту, проверено следующее: носитель cloud для arm64 загружается, ядро с конфигурацией для Pi стартует, модули DRBD загружаются, сеть поднимается по DHCP, установщик доходит до своей консоли с работающим API узла, а образ правильно сообщает свою версию. Более ранний прогон зашёл дальше: носитель загрузился, установщик записал диск, установленная система загрузилась с него и подняла kube-apiserver за 42 секунды. Горячее добавление процессоров и памяти в пропатченном гипервизоре я гонял на эмулированном ARM-хосте с GICv2 и вложенной виртуализацией KVM — кроме железа, это единственное место, где код для GICv2 действительно исполняется.
На amd64 с настоящим KVM проверено хранилище целиком: том создан и выдан на трёх узлах меньше чем за двадцать секунд, а thin pool’ы остались активными, пока все компоненты хранилища по очереди перезапускались.
Если у вас есть Pi 5 и хочется их проверить, убедитесь, что ядро загрузилось в EL2 и /dev/kvm существует. Проверьте, что cloud-hypervisor --host-capabilities выдаёт arm-gicv2-acpi-cpu-hotadd-v1. Создайте VirtualMachine с небольшими пределами и посмотрите, начинает ли гость загружаться: если с GICv2 что-то не так, гость упадёт ещё на инициализации контроллера прерываний. Потом увеличьте cpus — это проверит горячее добавление. В vm.info у машины должно стоять config.cpus.acpi_hotplug: true, иначе добавление даже не начнётся.
Комментарии 0