В предыдущей статье я разбирался, какие эксперты реально живут в VRAM у Strata, пока она крутит Qwen3.8-Flash-Next на GTX 1070. На этот раз - короче и практичнее: несколько конкретных приёмов ускорения, которые стоит проверить, если вы гоняете большую MoE-модель на домашнем железе. Один из них - патч, который я написал и прогнал сам, с цифрами “было/стало” на реальном движке. Остальные - то, что уже работает в Strata “из коробки”, просто не всегда включено и не всегда замечено.
1. Спекулятивное декодирование (MTP/drafting)
Идея старая (ещё с speculative decoding для dense-моделей): маленький “черновой” слой предсказывает несколько токенов вперёд, большая модель проверяет их все за один проход вместо одного токена за раз. Если угадал - считаем сразу несколько токенов по цене одного forward pass.
В Strata это --spec N --mtp <путь>: за одно окно верификации проверяется до N предложенных токенов. Цена - чуть VRAM под черновой слой и буферы, выгода - чаще 1.3-1.6x к скорости генерации, когда черновик угадывает хорошо (код и повторяющиеся паттерны - угадывает отлично, свободная проза - похуже). Включается почти бесплатно, если черновая модель уже скачана.
2. KV-кэш в RAM, а не в VRAM (--kv-resident)
На картах, где VRAM в дефиците (как у меня - 8 GB), обычный путь - ужимать контекст или квант. Но есть менее очевидный рычаг: --kv-resident N держит в VRAM только скользящее окно внимания (N токенов), а весь KV-кэш целиком утекает в pinned RAM.
Выигрыш не в скорости самого внимания - а в том, что освобождённая VRAM достаётся кэшу экспертов. Для MoE это обычно выгоднее: лишний гигабайт под резидентные эксперты снижает долю обращений к CPU/PCIe чаще, чем экономия на KV ускоряет attention. Проверяется легко - смотрите в логе долю expert cache N% hit до и после.
3. Батчинг нескольких запросов в одно окно (--batch/--parallel)
Если вы обслуживаете больше одного пользователя (или просто гоняете несколько параллельных агентов), --batch N - это continuous batching по сути: несколько разговоров декодируются в общих окнах верификации, так что общие веса (dense-слои, общий эксперт) читаются один раз на все, а не по разу на каждого.
На одной карте выигрыш в основном не в throughput на одного пользователя (он чуть падает из-за долей cache), а в том, что никто не ждёт в очереди, пока обслуживается другой. На нескольких GPU с layer-split цифры куда интересней - в docs/BATCHING.md у Strata разложено по полочкам, вплоть до того, сколько слотов стоит VRAM и когда --batch-groups важнее serial-режима.
4. Адаптивная резидентность экспертов
Это основная фишка Strata, про которую - вся предыдущая статья: кэш экспертов не статичен, он сам перекладывает веса между VRAM/RAM/SSD по частоте обращений, причём делает это прямо во время батч-окон, не останавливая генерацию (--adapt-every, --adapt-swaps). В этой статье не повторяю детали - но если вы ещё не включили адаптацию и сидите на статичном профиле экспертов, это первое, что стоит проверить: разница между “застывшим” и “живым” кэшем на моём железе была от 1.5x до 2x в зависимости от того, насколько однороден поток промптов.
5. Автоматическое обнаружение общего префикса - то, что я добавил сам
Вот тут я встал в тупик с хорошим вопросом: а что если клиент - обычный OpenAI-совместимый чат-бот и вообще не знает про strata_prefix?
У Strata уже есть механизм: клиент может явно пометить, где в промпте кончается общая часть (strata_prefix: {"tokens": N}), и движок запинивает чекпоинт на этой границе - следующий запрос с тем же началом не перечитывает её заново. Работает отлично, но требует, чтобы клиент сам это посчитал и прислал. На практике это почти никто не делает - ни агентные фреймворки, ни простые чат-клиенты.
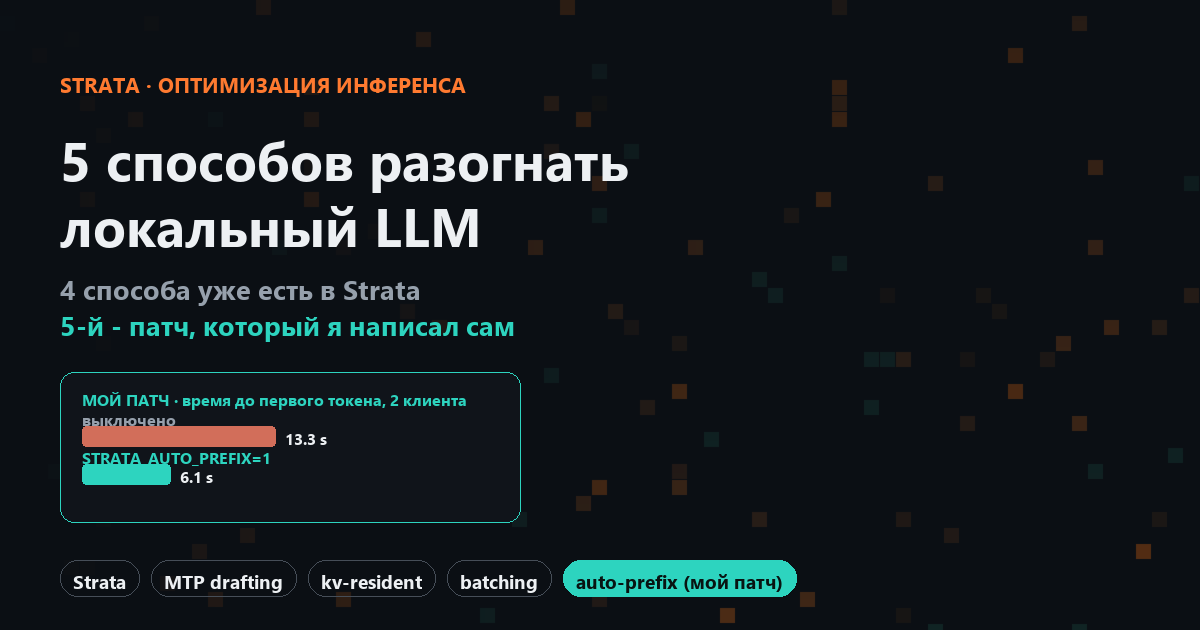
Я добавил небольшой слой на стороне сервера (STRATA_AUTO_PREFIX=1, по умолчанию выключено): он держит radix-trie по id токенов недавно принятых промптов и бюджет на количество одновременных “пинов” (каждый пин - это VRAM, отнятая у кэша экспертов, бесплатных пинов не бывает). Когда приходит новый запрос без явного strata_prefix, сервер сам ищет совпадение и подставляет границу - движок не видит разницы между “клиент сказал” и “сервер догадался”.
Проверил на реальном движке (Strata 0.2.12, build 0.1.58, одна GTX 1070 8 GB, Qwen3.8-Flash-Next UD-IQ4_XS), два клиента с одним длинным общим документом, никто не шлёт strata_prefix вручную:
|
| |
|---|---|---|
медиана перечитанных токенов | 886 | 468 |
медиана токенов из кэша | 0 | 413 |
медиана времени до первого токена | 13.3 с | 6.1 с |
Как и обязательные для апстрима before/after на одном железе - это не “похоже на x2”, это два прогона одного и того же бенчмарка на одной машине, отличается только одна переменная среды.
Код - в ветке DmNep/Strata@auto-prefix-cache, тесты (22 кейса на mock-движке + полный regression-прогон 451 существующих тестов) там же. Предложил фичу мейнтейнерам апстрима как issue, не PR - у них в CONTRIBUTING.md чётко написано: для нетривиальных фич сначала согласовать scope, а не сразу тащить код. Обсуждение - Niko1221/Strata#5808.
Итого
Из пяти способов четыре уже есть в Strata и просто ждут, чтобы их включили; пятый - моя добавка сверху, по мотивам того, что реальные клиенты обычно не знают о таких механизмах и их нужно обнаруживать автоматически. Если у вас MoE-модель на скромной карте - начните с проверки --kv-resident и --spec/--mtp, это обычно самый быстрый выигрыш без переписывания ни строчки кода.

Комментарии 0