У нас было 15 000 ₽ в месяц, команда из пяти человек и катастрофическая нехватка времени на ручное тестирование. И мы призвали Духа Машины.
Мы команда тестирования Главной страницы Яндекса. Как и у любой QA‑команды, у нас гора рутины: открыть задачу; понять, что в PR; накидать чек‑лист; написать тест‑кейсы; автоматизировать; потом чинить, когда тесты падают на CI. Теперь Дух Машины берёт на себя значительную часть этой рутины: читает тикеты и PR, пишет чек‑листы, кейсы и автотесты, чинит упавшие тесты и ревьюит код. Он помогает всем тестировщикам команды.
В статье мы расскажем о том, как устроен Дух Машины, сколько стоит в рублях, на какие грабли мы наступали и как сделать похожее у себя. Архитектура не привязана к конкретной модели: для каждого шага можно подобрать доступный вариант подходящей мощности.
С чего всё начиналось
Первая версия Духа Машины жила в плагине Roo Code для VS Code. Процесс взаимодействия был таким: открываешь редактор, выбираешь режим «Дух Машины», пишешь «Составь чек‑лист по задаче» или «Напиши автотест по кейсу», а агент сам идёт в Трекер, читает PR, анализирует изменения, выдаёт результат.
Это работало, но пользоваться такой версией могли только те инженеры, которые и так умеют автоматизировать и не боятся открыть IDE ради одной задачи. Остальная команда просто смотрела со стороны.
Проблема в том, что для вызова агента нужно было:
Открыть IDE.
Поднять окружение.
Убедиться, что доступы и инструменты живы.
Выбрать режим «Дух Машины».
Сформулировать и отправить запрос.
Получалось, что мы просто заменяем одну ручную работу на другую. Хотелось, чтобы результат появлялся сам — по событию в Трекере, без участия инженера.
Архитектурная идея получилась простой и универсальной — её можно легко адаптировать под любую внутреннюю инфраструктуру:
Событие в Трекере (статус/комментарий)
        ↓
HTTP-триггер → CI/CD-action
        ↓
Робот-аккаунт запускает пайплайн AI-агентов
        ↓
Цепочка субагентов (каждый со своим скилом)
        ↓
Результат обратно в тикет/PR
За этой цепочкой стоят разные компоненты: одни отвечают за запуск и доступы, другие — за выполнение задачи и знание правил проекта.
Робот — отдельный сервисный аккаунт, от имени которого агент работает с Трекером, репозиторием, TMS и CI.
Триггеры в Трекере — правила, которые запускают пайплайн при смене статуса задачи или появлении кодового слова в комментарии.
CI‑action в репозитории — сценарий, который подготавливает и запускает агента с набором скилов.
Субагенты — отдельные запуски моделей для узких подзадач, которые передают результаты друг другу через JSON.
Скилы — инструкции для конкретных задач: порядок действий, шаблоны и правила проверки качества.
Банк памяти — база знаний проекта: архитектура, принятые подходы и способы решения типичных проблем.
Среда запуска — изолированное окружение, в котором агент получает доступ к репозиторию и инструментам. У нас эту роль выполняет тасклет в CI.
Перед выкаткой этого решения в прод мы прошли секьюрити‑ревью: какие данные агент читает и пишет, какие действия запрещены. Часть возможностей сознательно не включали — например, запретили агенту доступ к реальной странице в браузере из автоматического трекерного флоу. Из‑за этого агент пишет черновик теста по кейсу вслепую, запускает прогон в CI, а потом сам правит локаторы по его отчёту.
Анатомия Духа
Триггеры: как вызвать агента
Для запуска агента мы настроили два типа триггеров в очереди Трекера: по комментарию и статусу.
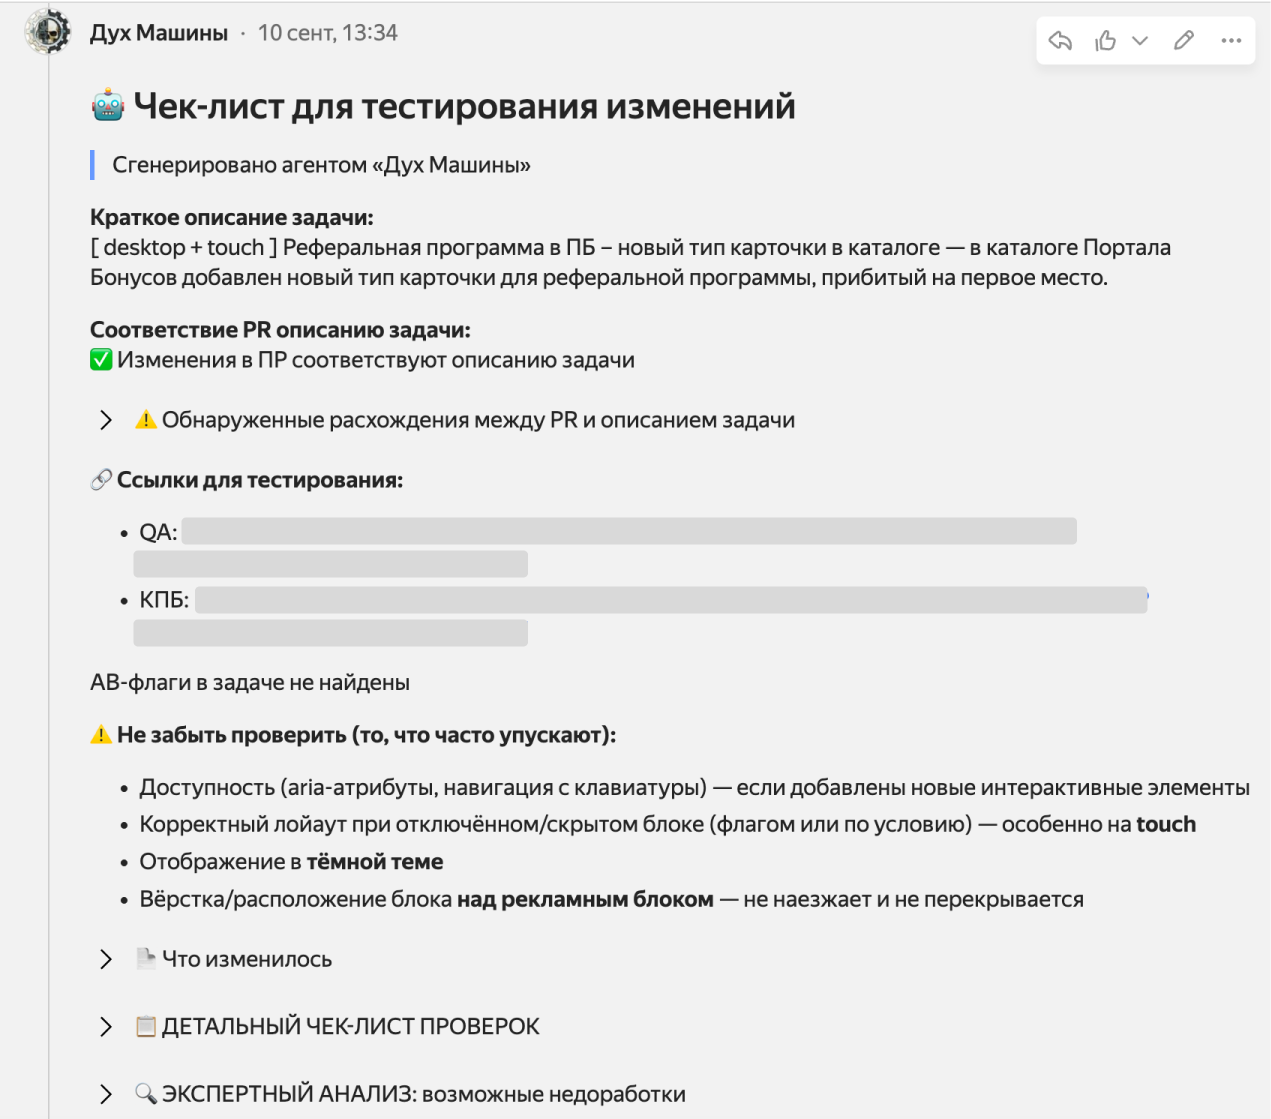
Запуск по комментарию. В тикете можно написать кодовое слово (у нас — «ДухМашины»), и агент подгрузит в задачу чек‑лист о её тестировании с потенциальными багами. Удобно для повторной генерации, если разработчик обновил PR.
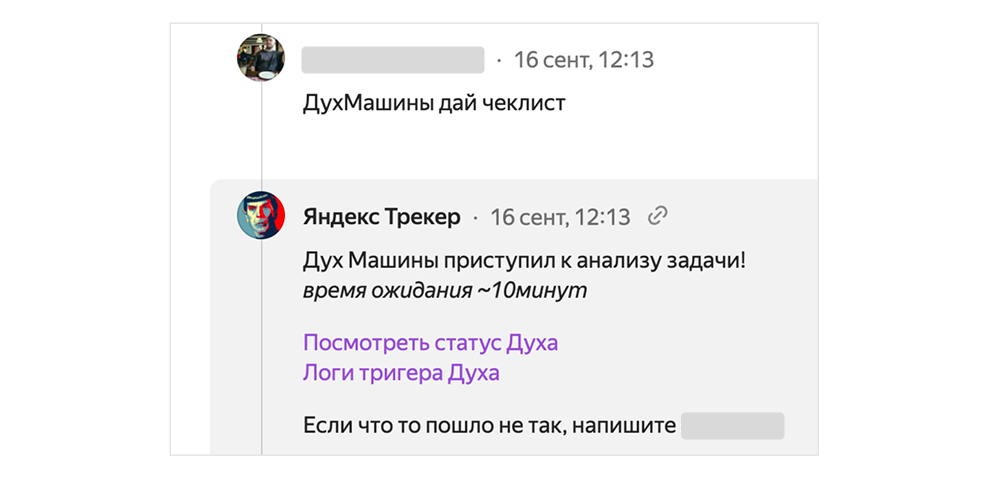
Поле | Значение |
Событие | Создан комментарий |
Текст | Содержит «ДухМашины» |
Запуск по статусу. Когда задача переходит в статус «Можно тестировать», агент стартует сам. Тестировщик открывает тикет и видит уже готовый чек‑лист.
Поле | Значение |
Событие | Задача изменена |
Статус | Стал равен «Можно тестировать» |
Оба триггера шлют HTTP POST в CI Public API и запускают нужный action.
Для генерации автотестов работает похожая схема: либо пишем комментарий со ссылкой на тест‑кейс из TMS, либо переводим задачу в статус «Написание автотестов». Чтобы агент не спамил, мы поставили предохранитель: агент сначала запрашивает подтверждение инженера и только после «да» начинает сборку PR в репозитории.
Субагенты вместо монолита: почему мы отказались от одного большого промпта
Первая версия интеграции Духа в Трекер была монолитом: один агент читал задачу, анализировал PR, составлял и публиковал чек‑лист. Это работало, но очень медленно, да и стоило дорого — весь огромный контекст был в одном запросе. Мы решили разделить процесс на субагентов и скилы:
Субагенты — это отдельные запуски моделей под каждую подзадачу.
Скилы — директории со SKILL.md, правилами и шаблонами. Перед стартом нужная директория копируется в окружение агента и задаёт контекст под конкретный тип работы.
Чек‑лист генерируется в три шага:
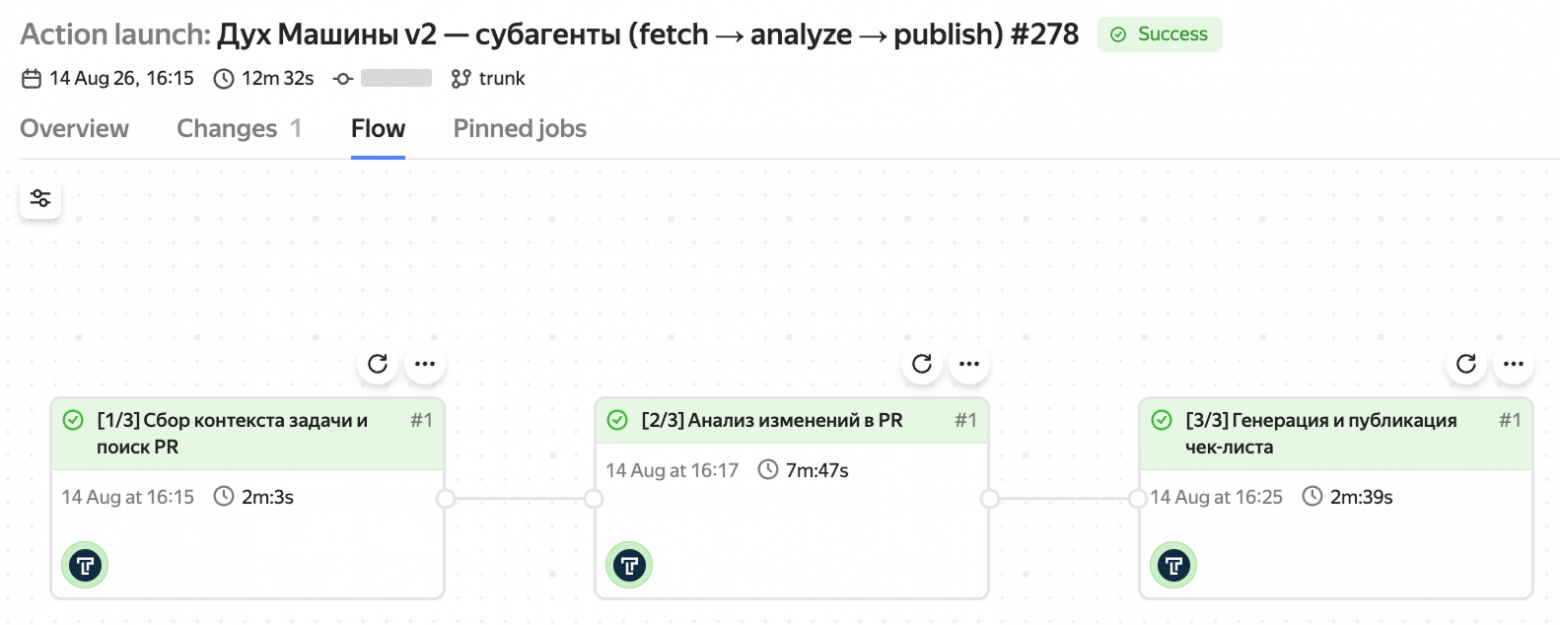
[1/3] fetch-context        -- читает задачу, ищет PR
         ↓ JSON
[2/3] analyze-pr           -- разбирает изменения в коде
         ↓ JSON
[3/3] generate-and-publish -- собирает и публикует чек-лист
Между шагами — валидируемый JSON. Главный плюс такой системы в том, что если упадёт один шаг, перезапустится только он, а не весь пайплайн.
Монолит | Субагенты | |
Прозрачность | Один большой чёрный ящик | Видно, на каком шаге проблема |
Стоимость | Весь контекст в одном агенте | Каждый агент работает только со своим контекстом |
Надёжность | При падении перезапуск всего | При падении перезапускается только упавший джоб |
Отладка | Сложно понять, где ошибка | Логи каждого субагента отдельно |
В итоге каждый шаг получает только нужный контекст, а при сбое мы повторяем только его. Так мы сократили расходы и упростили отладку пайплайна.
Пайплайн автотестов: от трёх шагов к шести
Для чек‑листов хватило трёх шагов. С автотестами пришлось пойти дальше: написать код и создать PR оказалось недостаточно.
В первой итерации автотестов пайплайн состоял из трёх шагов:
Взять кейс.
Написать тест.
Создать PR.
Но локаторы получались неточными. Напомню: из соображений безопасности у агента не было доступа к браузеру, и он не видел живую страницу. Поэтому добавили обратную связь: агент запускает тест в CI, правит локаторы по отчёту и запускает тест снова.
Так три шага превратились в шесть:
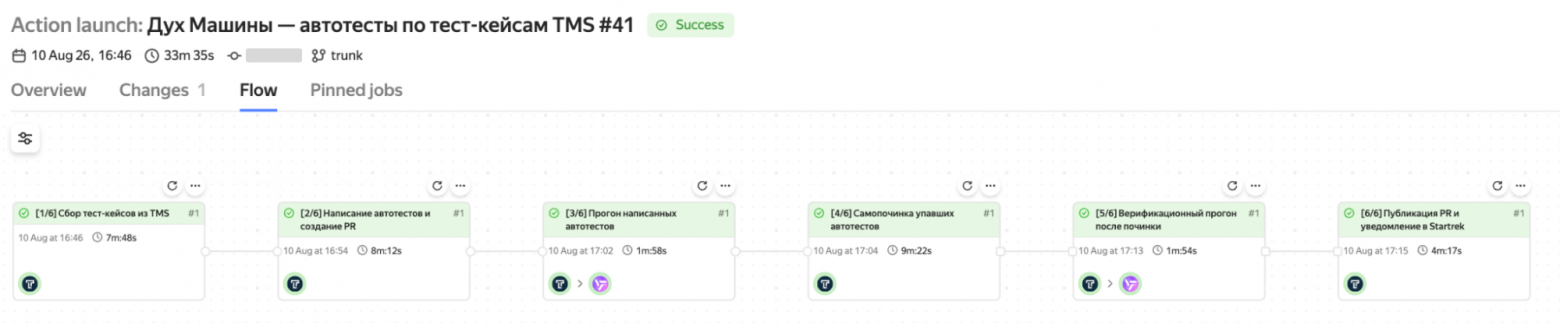
[1/6] fetch-testcases  -- задача из Трекера + кейсы из TMS + логин автора запроса
[2/6] write-tests      -- черновик Playwright-теста в репозитории Arcadia
[3/6] run-tests        -- прогон (не LLM)
[4/6] self-heal        -- правка локаторов по отчёту
[5/6] verify           -- повторный прогон (не LLM)
[6/6] notify           -- PR в Arcadia + комментарий в Трекер
Результаты зависят от сценария. После генерации чек‑листа Дух оставляет в тикете:
сводку изменений;
ссылки на тестовые стенды;
чек‑лист для проверки вёрстки, функциональности, браузеров и устройств;
потенциальные риски.
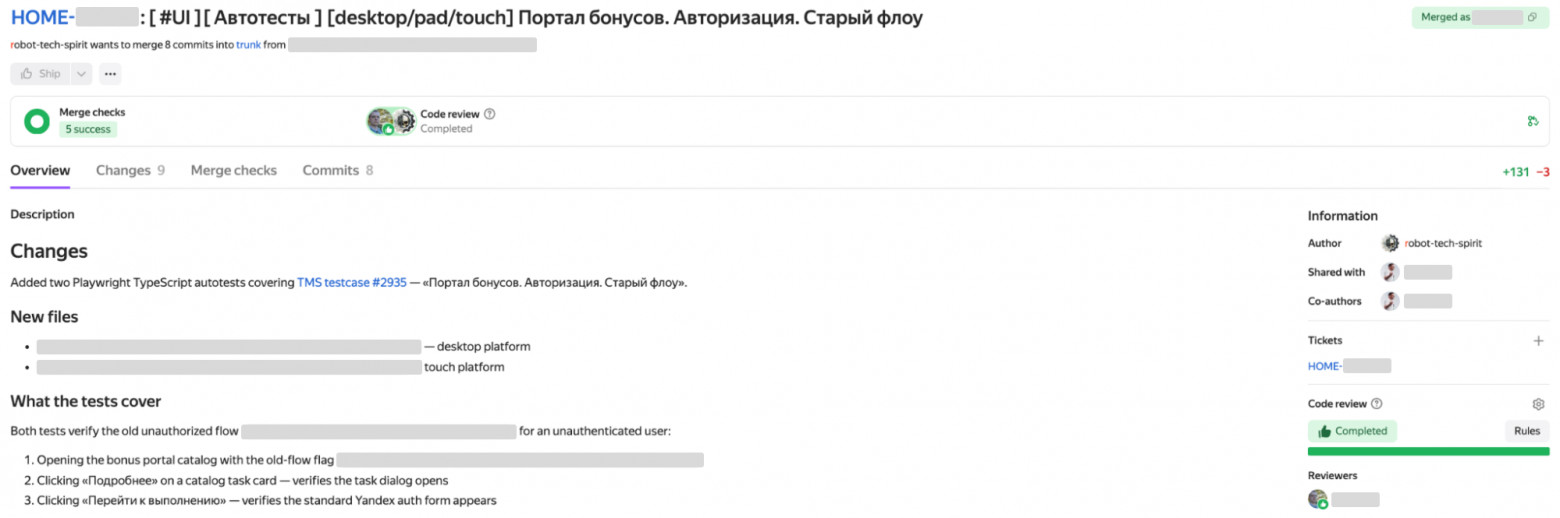
После генерации автотеста в тикете появляется комментарий со ссылкой на готовый PR. Сам PR остаётся в репозитории, и автор задачи может сразу заливать в него правки.
Нюанс с правами, который всех бесил: кто автор PR?
Когда агент работает в IDE, все ветки и коммиты создаются под личной учёткой инженера. Но в трекерном флоу агент работает под учёткой Духа Машины, а не инженера. PR в репозитории технически создаётся роботом, но как быть, если тестировщику нужно дотюнить локаторы и запушить правки? Без прав на пуш пришлось бы клонировать PR — а это дополнительные действия.
Как мы это решили:
На первом шаге пайплайна в Трекере достаём логин автора, который написал комментарий или перевёл тикет в нужный статус.
Протаскиваем логин через всю цепочку субагентов.
На финальном этапе робот создаёт PR в репозитории и сразу добавляет автора в соавторы и владельцы ветки.
В итоге PR создаёт Дух, а инженер может сразу заливать в него правки под своей учёткой. Не нужно заводить отдельную ветку, чтобы поправить пару локаторов.
В каких задачах без человека пока никуда
Дух Машины берёт на себя значительную часть рутины, но финальный контроль остаётся за инженером. Пайплайн устроен так:
Агент создал артефакт (чек-лист/кейсы/PR)
        ↓
Человек валидирует
        ↓
При необходимости правит
        ↓
Ревью и мёрж / решение по задаче
Дух собирает контекст, накидывает первый вариант и оформляет его по правилам проекта. Инженер проверяет, что получилось: не упущены ли сложные сценарии и пограничные случаи, верно ли учтена бизнес‑логика. Решение мёржить или не мёржить тоже остаётся за человеком.
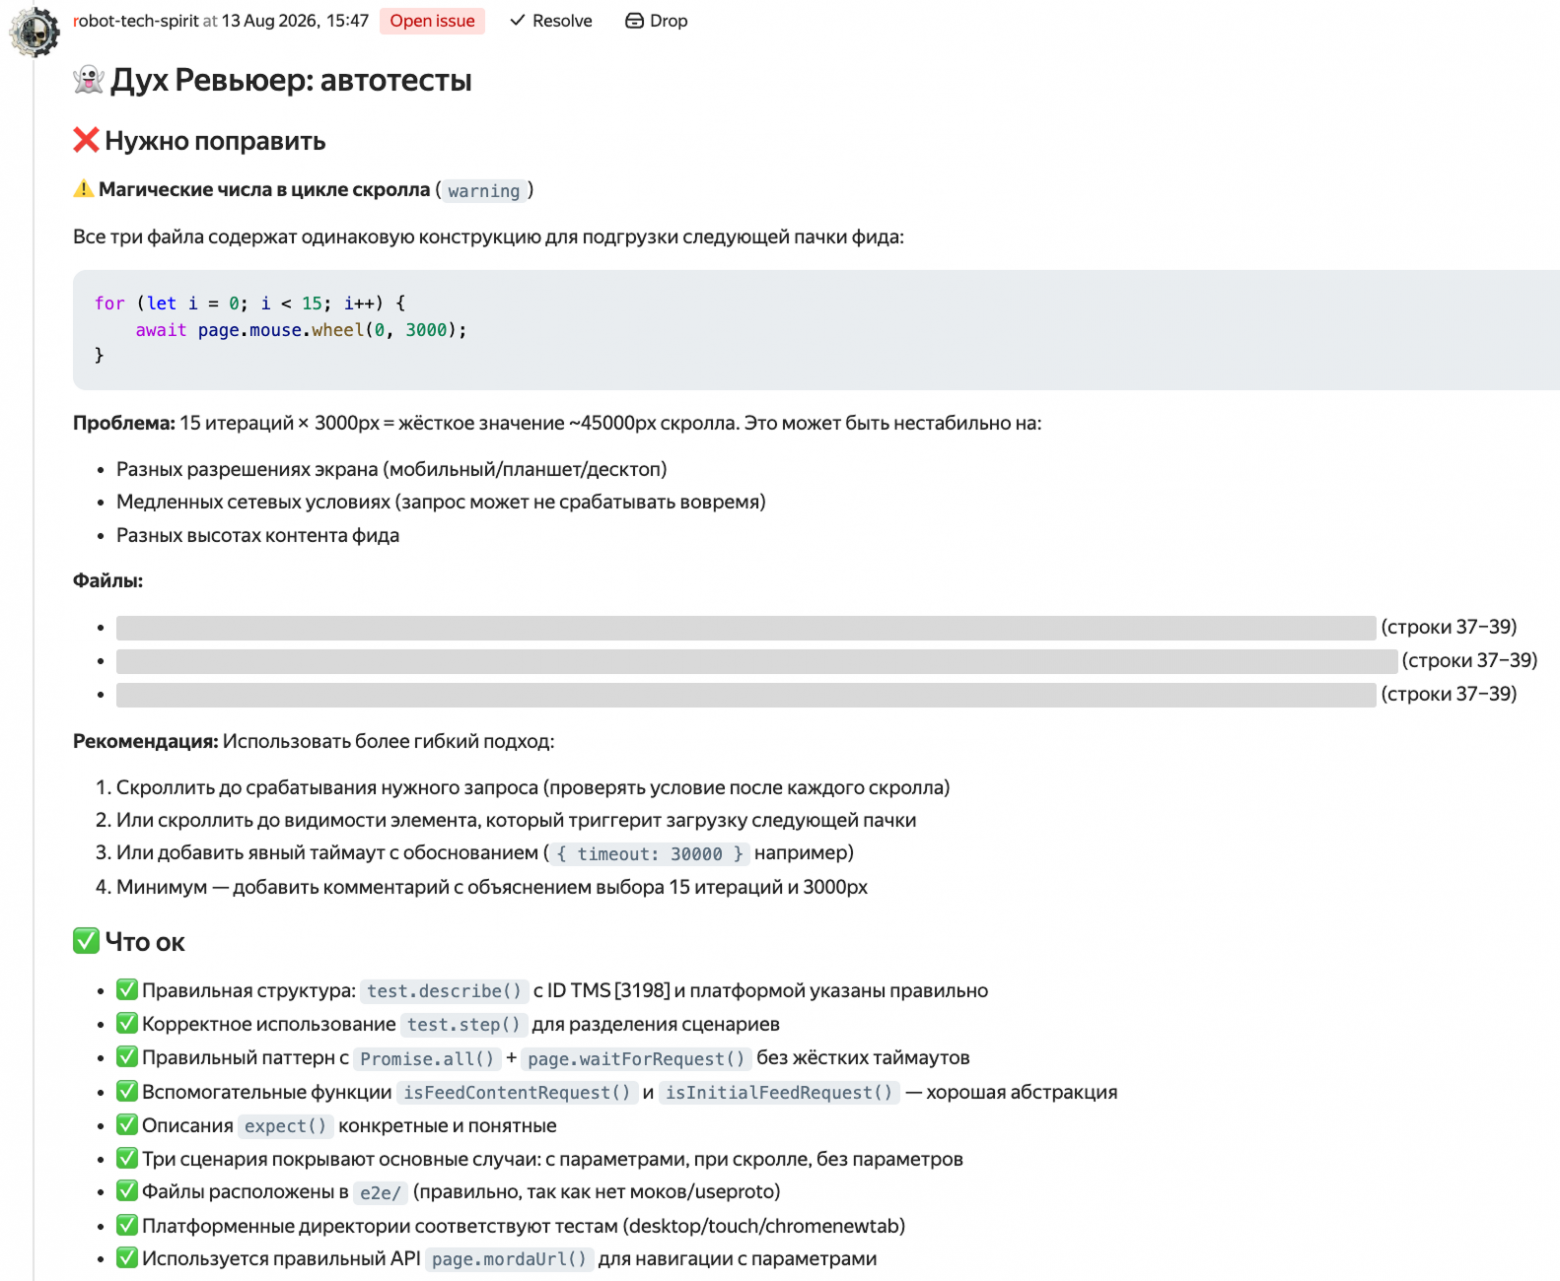
Важный момент:Дух Машины — не заменитель живого человека. Это помощник в рутинной работе и недорогой способ подготовить необходимую базу для последующей доработки тестировщиком.
Знания Духа
Скилы: как научить агента вашим правилам
Скил — обычная рабочая инструкция, как для джуна, только в репозитории. В ней описано, что делать по шагам, какие шаблоны использовать и как проверять результат.
skills/
  write-e2e-test/
    SKILL.md           -- что делать, шаг за шагом
    templates/
      test-template.ts -- заготовка теста
    rules.md           -- именование, e2e vs integration, хелперы
Вот упрощённый пример SKILL.md без внутренней специфики:
# Написание e2e-теста по тест-кейсу

## Вход
- ссылка на тест-кейс
- платформа (desktop/touch)
- домен/зона, если есть

## Правила
- тест с моками → integration/, без моков → e2e/
- название: [ID_кейса] Краткое описание
- в начале файла — ссылка на кейс
- хелпер на один тест — в файле; на несколько — в helpers

## Шаги
1. Прочитать кейс целиком (предусловия, шаги, ожидания)
2. Собрать структуру теста по шаблону
3. Не придумывать проверки, которых нет в кейсе
4. Вернуть путь к файлу и содержимое

## Результат
- готовый файл теста
- список допущений, если что-то было неоднозначно
Здесь агент получает и порядок действий, и правила проекта: куда положить тест, как его назвать и когда вынести хелпер в отдельный файл.
В нашем репозитории живут отдельные скилы для:
сбора контекста;
анализа PR;
публикации чек‑листа;
выгрузки кейсов из TMS;
написания теста;
создания PR;
ревью кейсов;
ревью кода;
починки падений.
Чем уже скил, тем дешевле и стабильнее шаг. Один «скил на всё» почти всегда дороже и хуже отлаживается.
Банк памяти: откуда агент знает «как у нас принято»
Если скил отвечает на вопрос «Что сделать сейчас?», то банк памяти — на вопрос «Как это вообще устроено в нашем проекте?». Без него агент каждый раз заново разбирается, куда класть e2e, какие фикстуры уже есть, какие селекторы стабильны и на какие грабли команда уже наступала. С банком памяти эти знания у него под рукой — в документах, которые поддерживают люди.
У нас банк памяти — набор Markdown‑документов в репозитории. Вот какие разделы в нём есть:
Раздел | Какая внутри информация для агента |
Обзор проекта | Стек, структура директорий, основные команды |
Как писать тесты | Пошаговый процесс, приоритет селекторов, антипаттерны |
Справочники фреймворка | Готовые фикстуры, хелперы, что уже не надо изобретать |
Отладка | Типовые падения и как их чинить |
Интеграции | Трекер, TMS, отчётность — куда ходить и что писать |
Аналитика | Что считать успехом, какие метрики смотреть |
Вот упрощённый пример структуры файлов:
memory-bank/
  01-project-overview.md
  02-core-testing-guide.md
  03-framework-reference.md
  04-problems-and-debugging.md
  05-integrations.md
  06-analytics.md
Банк памяти нужно поддерживать в актуальном состоянии: нашли новый паттерн или антипаттерн, починили нестабильный тест — записали то, что пригодится дальше. Критерии у команды простые:
добавляем только то, что переиспользуется в следующих задачах;
не тащим детали одного тикета;
не дублируем то, что уже написано.
Скил без банка памяти — это джуниор‑специалист с чек‑листом, но без онбординга. Банк без скилов — это документация, которую забывают почитать в нужный момент. Вместе они дают агенту и алгоритм, и контекст проекта.
Банк памяти тоже стоит токенов: он попадает в контекст. Поэтому его не стоит раздувать «на всякий случай». Короткий актуальный гайд всегда лучше 200 страниц устаревших документов.
Обитель Духа
Среда запуска: где гоняем агента и какие есть альтернативы для вас
Когда агент работает в IDE, у него есть всё необходимое окружение: репозиторий открыт, доступы у человека под рукой. Когда агент стартует из Трекера, окружение нужно готовить автоматически. Сценарий запуска должен:
Подтянуть код репозитория на нужной ревизии.
Положить рядом скилы и банк памяти.
Получить доступ к инструментам: Трекеру, TMS, PR.
Запустить цепочку субагентов.
Опубликовать результат в тикете или создать PR.
Залогировать потраченные токены и итоговую стоимость.
У нас роль такого раннера играет тасклет — джоба в CI, которую можно вызвать по API. По сути, это «контейнер с агентом», который монтирует репозиторий и выполняет AI‑задачу от имени Духа Машины. Вот схема его работы:
Трекер (webhook / HTTP POST)
        ↓
CI Public API
        ↓
Тасклет/job:
  - провести checkout репозитория
  - скопировать skills/ + memory-bank/
  - запустить субагента N с нужной моделью
  - прочитать/записать JSON между шагами
  - опубликовать результат
Тасклет — наша внутренняя обёртка, но сама идея универсальна. Снаружи та же идея собирается из привычных кубиков:
Что нужно собрать | Примеры составляющих |
Триггер из таск‑трекера | Jira Automation, GitHub Issue Webhooks, Linear Webhooks, YouTrack Workflows |
Среда с репозиторием | GitHub Actions, GitLab CI, CircleCI, self‑hosted runner, обычный docker‑job |
Агент и управление его шагами | Claude Code, Codex, OpenAI Agents SDK, LangGraph, CrewAI, собственный скрипт на SDK модели |
Секреты и робот | GitHub App, bot‑user + secrets в Vault/CI |
Инструменты | API Jira/Linear; TestRail, Xray, Allure TestOps, gh/glab, Playwright в CI |
Наблюдаемость | Логи джобы + отдельная таблица cost/tokens на шаг |
Минимальный каркас запуска — шаги пайплайна в примере опущены:
# псевдо GitHub Actions
on:
  repository_dispatch: # или webhook из Jira
jobs:
  agent:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - run: cp -r skills memory-bank ~/.agent/
      - run: agent run --skill write-e2e-test --input "$ISSUE_PAYLOAD"
      - run: gh pr create --title "..." --body "..."
Чтобы перенести такую архитектуру в свою инфраструктуру, придерживайтесь пяти правил:
Фиксируйте версию кода. Запускайте агента на конкретной ревизии или коммите, чтобы все шаги работали с одной версией репозитория.
Храните инструкции в репозитории. Скилы и банк памяти должны лежать в файлах рядом с кодом, а не в памяти чата, чтобы их можно было версионировать и обновлять вместе с проектом.
Разделяйте выполнение на шаги. Запускайте субагентов в отдельных джобах или шагах пайплайна, а результаты передавайте между ними в JSON.
Считайте затраты каждого шага. Записывайте входные и выходные токены и стоимость, чтобы видеть, на что уходит бюджет.
Ограничивайте доступы агента. Заранее определите, какие API и действия ему разрешены, а какие запрещены.
Если коротко: для повторения нашей схемы нужен CI, который может принять внешний триггер, подготовить окружение и запустить агента. Скилы, банк памяти и передачу результатов между шагами выстраивайте уже под свой проект.
Требования Духа
Экономика: сколько стоил наш эксперимент
Изначально на команду из пяти человек у нас был бюджет 15 000 ₽ в месяц, и мы решили использовать его на полную!
Вот таблица наших расходов:
Месяц | Потратили |
1 | 11 600 ₽ |
2 | 9300 ₽ |
3 | 14 600 ₽ |
4 | 15 000 ₽ |
К четвёртому месяцу мы выбрали весь лимит, а запросов было больше, чем могли запустить. За последние два месяца Дух Машины подготовил больше 210 чек‑листов и около 40 PR с автотестами. Показали эти результаты руководству, и бюджет увеличили до 30 000 ₽ в месяц.
Посчитаем, во сколько нам обходится одна операция. Для пересчёта в рубли использовали курс $1 = 86,89 ₽.
Чек‑лист по задаче — итого ~127 ₽ (~$1,46)
Шаг | Стоимость |
[1/3] Сбор контекста | ~12 ₽ ($0,14) |
[2/3] Анализ PR | ~86 ₽ ($0,99) |
[3/3] Генерация и публикация | ~29 ₽ ($0,33) |
Итого | ~127 ₽ ($1,46) |
Написание автотеста с PR и починка теста — в среднем 130–260 ₽ (~$1,5–3)
Столько сейчас стоит и написание автотеста с PR, и починка упавшего теста. Бывает и дешевле $1,5 — зависит от размера кейса и того, сколько шагов self‑heal реально отработало.
Раньше, в первых версиях пайплайна, на один автотест легко могло уходить до 518 ₽ ($6).
Шаг | Стоимость |
[1/6] Получение контекста и кейсов из TMS | ~89 ₽ ($1,02) |
[2/6] Написание тестов | ~183 ₽ ($2,11) |
[3/6] Прогон | Не LLM |
[4/6] Self‑heal локаторов | ~166 ₽ ($1,91) |
[5/6] Повторный прогон | Не LLM |
[6/6] PR в Arcadia + комментарий в Трекер | ~79 ₽ ($0,91) |
Итого | ~518 ₽ (~$5,96) |
Сейчас тот же сценарий в среднем укладывается в $1,5–3 за счёт более узких скилов, более короткого контекста на шаг и подбора модели под сложность джобы.
Операция | Ориентир сейчас |
Ревью кода автотеста | ~17 ₽ (~$0,20) |
Написание автотеста + PR | ~130–260 ₽ ($1,5–3) |
Починка упавшего теста | ~130–260 ₽ ($1,5–3) |
Что реально экономит деньги, а что — нет
До этой стоимости дошли не сразу. Когда бюджет стал заканчиваться, первой идеей было: «Переведём скилы и банк памяти на английский — токенов будет меньше». Посчитали на уже созданных Духом автотестах и сравнили разницу:
перевод скилов даёт экономию около 13 ₽ (~$0,15) — это около 2,5%;
со всем банком памяти в среднем сценарии — 3–6% экономии.
Получается большая работа и маленькая экономия, да ещё и русскоязычной команде поддерживать инструкции на английском сложнее. Оставили русский.
А вот что реально сработало для экономии — не звать дорогую модель туда, где справится дешёвая. Разделили шаги по сложности:
Рутинные действия: сходить в Трекер или TMS, собрать контекст, оформить комментарий по шаблону. Здесь хватает экономичной модели, а иногда и просто скрипта.
Задачи с анализом: написать тест, разобрать падение, собрать содержательный чек‑лист. Здесь нужна модель помощнее.
Перенос одной джобы с дорогой модели на дешёвую экономил около 87 ₽ (~$1) с операции без потери качества.
Что Дух Машины умеет сейчас и что с ним будет дальше
Сейчас Дух Машины помогает нам с повседневными задачами QA‑инженера — запускается по триггерам в Трекере или работает вместе с инженером в IDE.
В Трекере Дух:
составляет чек‑лист при переходе задачи в статус «Можно тестировать»;
генерирует и ревьюит тест‑кейсы;
пишет автотест по кейсу и создаёт PR с инженером в соавторах;
ревьюит код автотестов;
чинит упавшие тесты.
В IDE — то же самое интерактивно, когда нужен диалог и ручная навигация по сложной задаче.
Ещё мы отдельно завели Духа Методолога: он собирает программу обучения автоматизации для новичков на реальных примерах проекта. Готовить такую программу для каждого нового человека — тоже повторяющаяся работа, а Дух помогает сделать из этого систему!
Дальше в планах — связать отдельные сценарии в цикл: «задача → чек‑лист → кейсы → автотест → зелёный CI» и продолжать удешевлять рутинные шаги, сохраняя качество результата на более сложных.
Чек‑лист: как внедрить AI‑агентов у себя в QA‑процессы
Если хотите внедрить похожую архитектуру у себя, начните с одной повторяющейся задачи и доведите её до рабочего сценария.
Выберите одну рутину. Подойдёт задача, которую команда регулярно решает похожим способом: написать однотипный e2e‑тест, подготовить чек‑лист или разобрать типовое падение CI.
Опишите скил и заведите банк памяти. В скиле зафиксируйте порядок действий, шаблоны и правила проверки результата. В банке памяти — устройство проекта и принятые подходы. Храните всё в репозитории.
Разделите процесс между субагентами. Для начала можно выделить три шага: собрать контекст → сделать работу → опубликовать результат. Между шагами передавайте JSON с понятной структурой — так проще искать ошибки и считать затраты.
Заведите робота и отдельные секреты. Создайте для агента отдельный аккаунт, выдайте минимальные права и настройте логирование действий.
Пройдите ревью безопасности до запуска. Зафиксируйте, что агент читает и пишет, какие действия ему запрещены и как отозвать доступы. По результатам ревью ограничьте набор инструментов. Мы, например, отключили прямой браузерный доступ к внутренним стендам.
Подключите среду запуска агента. У нас триггер вызывает тасклет в CI; у вас это может быть другая CI‑джоба. Начните с запуска по комментарию, а запуск по статусу добавьте, когда стабилизируете стоимость и качество. Для генерации автотестов подавайте на вход уже отревьюенный кейс из TMS.
Считайте токены и стоимость каждого шага. Записывайте входные и выходные токены и расходы на модели. Нам такой учёт помог сравнить экономию от перевода инструкций и замены модели на отдельном шаге.
Оставьте финальный контроль человеку. Агент готовит черновик, инженер проверяет и при необходимости правит. Решение принять чек‑лист, сохранить кейсы или мёржить PR остаётся за человеком.
И только после всех предыдущих шагов масштабируйте на всю команду. Начните с одного сценария и одного‑двух пользователей. Проверьте, сколько времени он экономит, сколько требует правок и во что обходится. Затем подключайте всю команду и добавляйте новые сценарии.
Итоги
Начали с агента в IDE для нескольких энтузиастов, а пришли к инструменту, которым пользуется вся команда. По дороге выяснили три вещи:
Агент должен быть там, где команда уже работает. Для нас это Трекер: чтобы получить чек‑лист или запустить написание автотеста, не нужно открывать IDE и поднимать окружение.
Узкие шаги проще отлаживать и удешевлять. Разделение на субагентов помогло сократить контекст, повторять только упавший шаг и подбирать модель под сложность задачи.
Автоматизация не заканчивается на генерации. Тест нужно прогнать, ошибки — разобрать, результат — проверить человеку. Именно эти шаги превращают черновик от агента в то, что можно мёржить.
Если у вас есть рутина, которая повторяется каждый день, начните с неё. Не обязательно автоматизировать весь процесс: иногда достаточно одного шага, который все ненавидят делать руками.
Пишите в комментариях, применяете ли вы AI в работе и что уже переложили на плечи агентов?


Комментарии 0