В прошлой статье я рассказывал, как наш трёхнедельный RAG-пилот по технической документации растянулся на три месяца. Мы собирались научить корпоративный AI отвечать на вопросы инженеров и менеджеров, а вместо этого обнаружили, что сначала нужно разобраться в собственных документах.
С тех пор мы продвинулись. Собрали базу знаний, настроили поиск, подготовили сотни контрольных вопросов и наконец начали испытывать ассистента на реальных инженерных задачах.
Промежуточный результат — 84% правильных ответов на тестовом наборе из 188 вопросов. Для нас это способ проверить гипотезу: сможет ли ассистент взять на себя рутинную навигацию по десяткам разнородных заводских спецификаций и сократить количество обращений к инженерам по типовым параметрам оборудования.
Но общие проценты скрывают самое важное — как именно система ошибается в сложных инженерных запросах.
Оказалось, AI может найти нужный документ, правильно извлечь из него число и всё равно ошибиться. Может отказаться отвечать на вопрос, для которого в базе есть все исходные данные. Или не заметить, что сама постановка задачи ошибочна.
Сегодня о том, как мы тестируем корпоративный RAG на реальной заводской документации, на каких задачах он спотыкается и какие ошибки нам уже удалось закрыть.
От Excel-реестра к 27 тысячам фрагментов
Напомню задачу. ПСМ производит энергетическое оборудование, и мы хотим, чтобы менеджер или инженер мог обычным языком задать вопрос по конкретной электростанции и получить ответ на основании технической документации.
Для пилота выбрали газопоршневую электростанцию AGBa1000 мощностью 1 МВт.
В предыдущей статье я рассказывал о 44 вариантах её комплектации. Здесь другое число 44 — столько документов вошло в тестовую базу знаний: руководства по эксплуатации, описания систем, технические листы, инструкции производителей комплектующих.
Из них 29 PDF, 12 Word и 3 Excel. Ровно половина документов русскоязычные, половина — на английском. Но если считать по объёму поискового индекса, 94% фрагментов приходится на английский язык: большие руководства производителей комплектующих написаны на нём.
Весь массив система разделила на 27 007 поисковых фрагментов.
И здесь возникла первая интересная задача. Наш инженер задаёт вопрос по-русски, а ответ может находиться в англоязычном паспорте двигателя, в таблице на 150-й странице или в документе, название которого вообще не содержит обозначения нашей установки.
Недостаточно загрузить файлы. Нужно, чтобы система понимала, какие документы относятся к конкретной комплектации, умела сопоставлять терминологию и находила применимые данные.
Параллельно мы пошли двумя путями. Сначала внедрили RAG-поиск в уже работающий корпоративный AI-ассистент, чтобы сотрудники могли его тестировать. Отдельно продолжили разрабатывать целевую RAG-платформу с более строгими механизмами поиска и проверки источников.
Решения не конкурируют. Первое позволяет получать обратную связь сейчас, второе должно стать полноценным инструментом в дальнейшем.
Измеряем качество, а не впечатление от ответа
Большая проблема с тестированием языковых моделей в том, что они умеют очень убедительно разговаривать.
Можно задать десять вопросов, получить десять красивых ответов и решить, что система работает. Но что делать, если в одном из этих ответов перепутаны напряжение генератора или допустимое давление газа?
Решили проверять конкретные технические факты.
Подготовили несколько контрольных наборов с эталонными ответами. В них вошли вопросы по параметрам оборудования, эксплуатационным режимам, документации комплектующих и практические сценарии работы со станцией.
Параметры основного замера:
Объект проверки: RAG-поиск по базе знаний газопоршневой электростанции AGBa1000 (44 документа: руководства, паспорта систем, сервисные инструкции производителей комплектующих).
Контрольный набор: 188 вопросов по режимам работы, электрическим параметрам, комплектации и регламентам ТО.
Методика оценки: автоматическое сопоставление извлеченных чисел с эталоном и проверка смыслового соответствия найденным фрагментам независимой моделью (это автоматизированный тест сходимости, но не экспертная приёмка).
Дата фиксации: замеры «до» и «после» оптимизации поиска на 12 сентября 2026 года.
Вот результат:
Метрика | Было | Стало |
Точность ответов | 77,7% | 84% |
Нужный документ в первой десятке результатов | 94,1% | 96,3% |
Нужный документ на первом месте | 62,8% | 71,3% |
Все эталонные числа присутствуют в ответе | 70,8% | 78,3% |
Ложные отказы «нет данных» | 11,7% | 6,9% |
Рост обеспечили два изменения: переход от разбивки на крупные куски текста к индексации строк таблиц как самостоятельных фактов и подбор оптимального окна контекста (передача модели 10 фрагментов вместо 5).
За общими процентами скрывается важный нюанс: на 26 вопросов система стала отвечать правильно, а на 14, наоборот, ухудшила результат — чаще всего из-за необоснованного отказа искать данные.
А когда профильные специалисты завода выборочно сверили часть эталонов вручную по первоисточникам, выяснилась еще одна деталь: в 19 случаях ошибся не AI, а сам эталонный ответ, составленный при подготовке теста. Прежде чем требовать точности от модели, нужно убедиться, что в контрольных данных нет ошибок.
Кейс №1. Как две опоры превратились в 161
Начнем с классической задачи на извлечение данных из таблицы.
В газопоршневой станции AGBa1000 электрическая мощность 1000 кВт выдается генератором на 0,4 кВ в базовом режиме длительной нагрузки. В зависимости от типа соединения с двигателем генератор может быть с одним опорным подшипником и жестким фланцем к маховику или на двух собственных подшипниковых опорах через упругую муфту.
Тестировщик задал прямой вопрос:
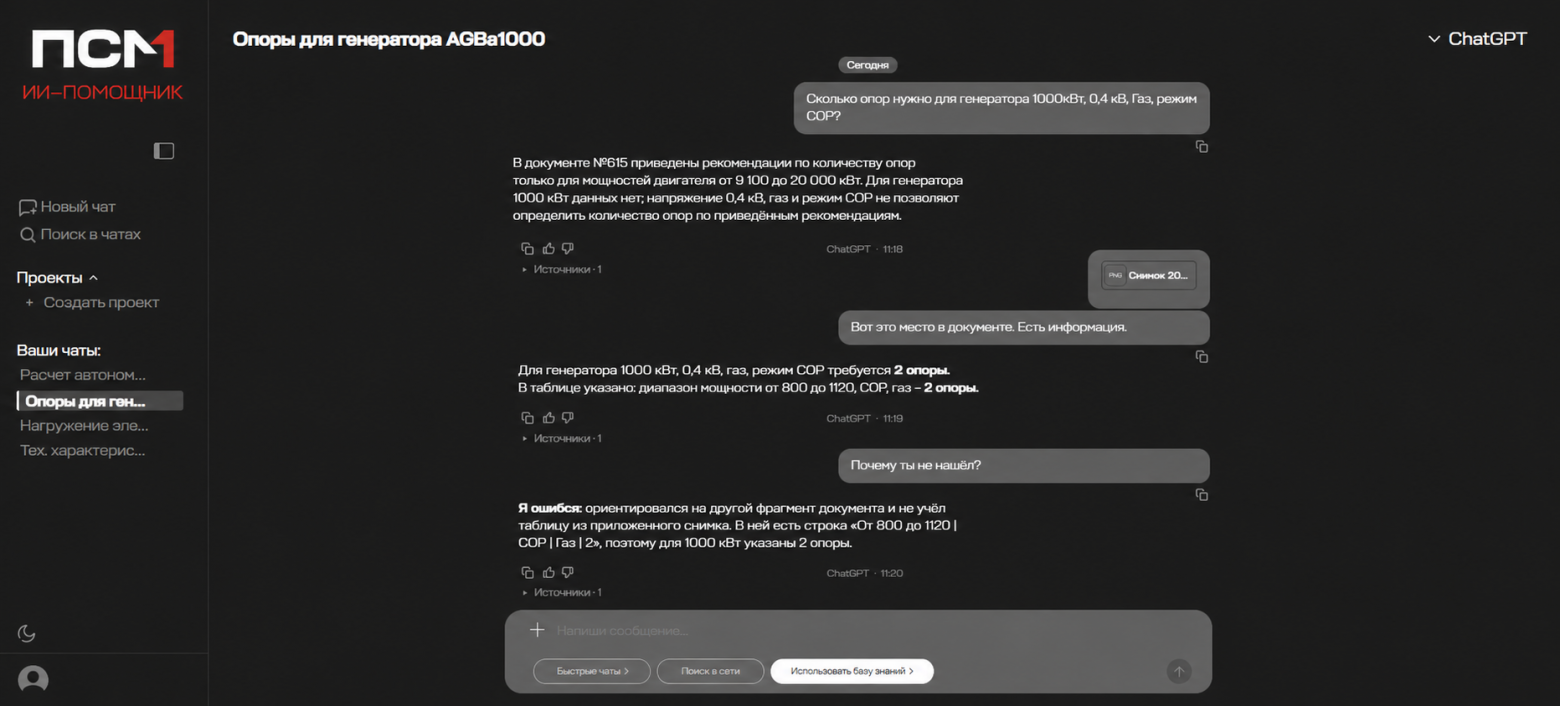
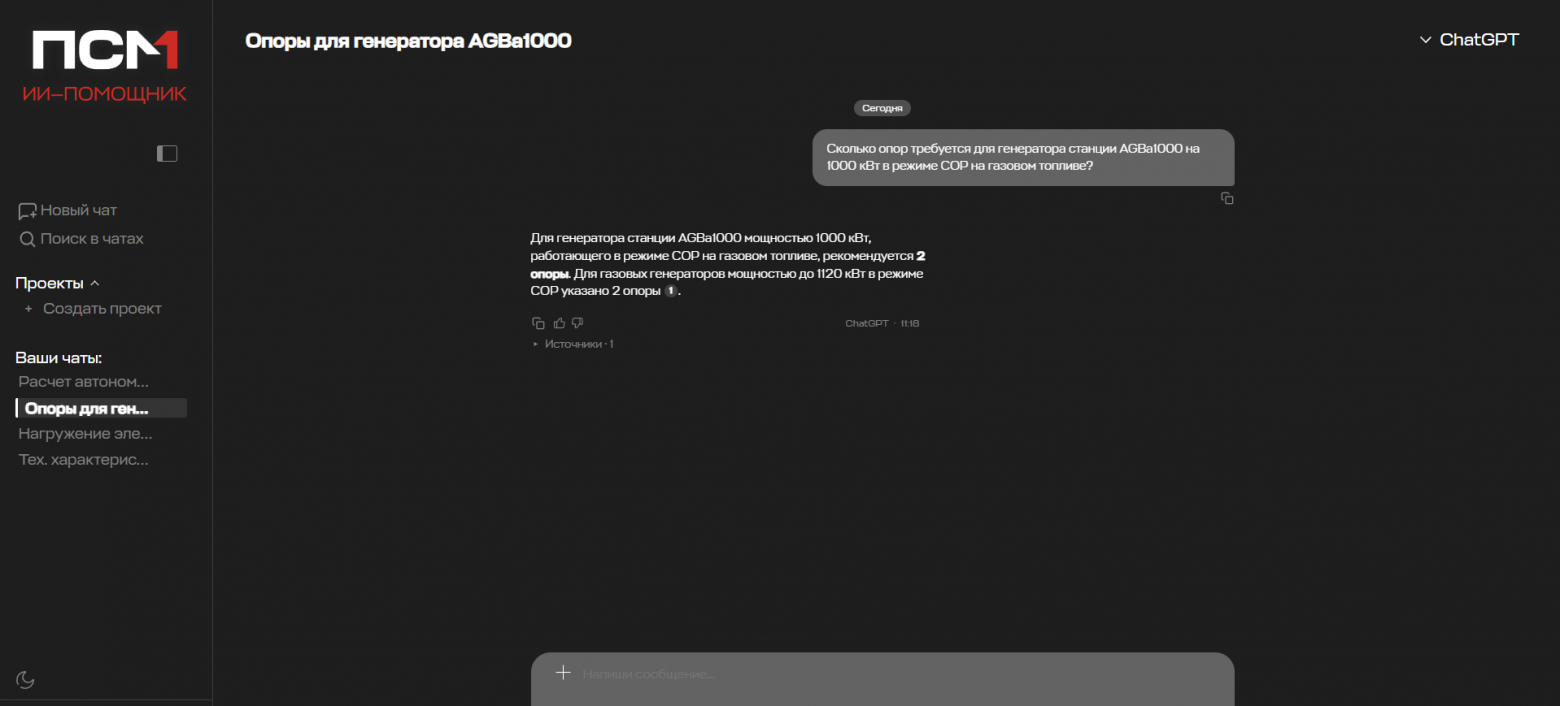
«Сколько опор требуется для генератора станции AGBa1000 на 1000 кВт в режиме COP на газовом топливе?»
В базе знаний есть официальное техническое письмо производителя генераторов. В нем содержится таблица применяемости, где для диапазона мощностей 800–1120 кВт, газового привода и режима COP четко указано исполнение: 2 опоры.
Однако ассистент эту информацию не увидел:
Ответ AI: «В предоставленной технической документации нет информации о количестве опор для генератора мощностью 1000 кВт».
Пользователь отправил в чат скриншот этой страницы документа. По картинке модель смогла распознать строку и исправилась: «Для диапазона 800–1120 кВт в режиме COP требуется 2 опоры». То есть в текстовом слое документа система информацию потеряла, а визуально на скриншоте нашла.
В другом тесте произошла более интересная ситуация. При автоматической обработке этого же отсканированного письма в поисковом индексе модуль распознавания споткнулся о сложную верстку: объединенные ячейки заголовков и разделители столбцов сместились. В результате числовые значения из соседних колонок склеились в одну строку.
Диапазон мощности 800–1120 кВт превратился в фантастические 16 000–16 100 кВт, а проектные 2 подшипниковые опоры, подцепив индекс соседней графы, трансформировались в 161 опору! Представьте реакцию инженера, которому корпоративный помощник советует заложить в проект станции 161 опору генератора.
Причина ошибки оказалась не в галлюцинациях LLM. Модель добросовестно пересказала то, что получил поисковый индекс. Проблема возникла на самом первом этапе, при парсинге сканированного документа. В заводском архиве полно сканов писем, опросных листов, чертежей с объединенными ячейками и мелких сносок. Если парсер разрушает структуру таблицы, дальше уже не имеет значения, насколько умна ваша нейросеть.
Вывод: качество инженерного RAG зависит от надежности оцифровки данных. Сканированные таблицы нельзя скармливать общему текстовому парсеру «как есть»: их нужно либо индексировать построчно с явным сохранением заголовков колонок, либо предварительно валидировать специальными моделями распознавания таблиц.
Кейс №2. AI нашёл два документа, но не смог связать их между собой
Теперь задача сложнее — на сопоставление разнородных документов.
Тестировщик спросил:
«Какими ступенями можно нагружать газопоршневую электростанцию AGBa1000?»
В руководстве по эксплуатации станции ассистент нашел общее требование: прием нагрузки должен выполняться ступенчато. Однако конкретные величины шагов в РЭ не регламентированы. Система честно ответила, что подтвердить точный шаг нагрузки для станции не может.
При этом в базе знаний лежало официальное техническое письмо производителя двигателя с рекомендациями для семейства 16M33: наброс не более 10% от номинала на шаге до 50% мощности и не более 5% в диапазоне 50–100%. Но модель не сопоставила эти данные со станцией, поскольку в письме наименование электростанции AGBa1000 не упоминается.
Логическая цепочка для сотрудника здесь кажется очевидной:
Электростанция AGBa1000 → приводной двигатель Baudouin 16M33G6N0/5 → рекомендации производителя двигателя.
Но в этой задаче скрыта инженерная граница, о которой в рабочей группе возникла дискуссия.
Разработчики справедливо отмечали, что модель не имеет права переносить параметры комплектующих на готовое изделие без подтверждения. Рекомендации Baudouin даны для «голого» двигателя на заводском стенде. А комплектная ГПУ на объекте включает генератор, турбокомпрессоры, газовую рампу с определенным давлением подачи и собственную систему управления. Скорость приема нагрузки готовым агрегатом зависит от качества газа, температуры воздуха и режима работы (параллельно с сетью или в изолированном острове). Тестировщики наоборот возражали, что связь уже содержится в документации, и её просто нужно обнаружить.
В итоге сформулировали более точную задачу. Ассистент должен уметь находить подтверждённые связи между оборудованием и комплектующими, но при этом различать справочные рекомендации производителя двигателя и гарантированные характеристики конкретной электростанции.
Каким должен быть правильный ответ ассистента:
Сообщить, что в руководстве по эксплуатации AGBa1000 фиксированные ступени нагрузки не заданы.
Указать, что станция укомплектована двигателем Baudouin 16M33G6N0/5.
Привести справочные рекомендации изготовителя двигателя с точной ссылкой на письмо.
Явно зафиксировать границу применимости. Указать, что эти цифры относятся к двигателю, а допустимые ступени для комплектного энергоблока определяются проектом и требуют согласования.
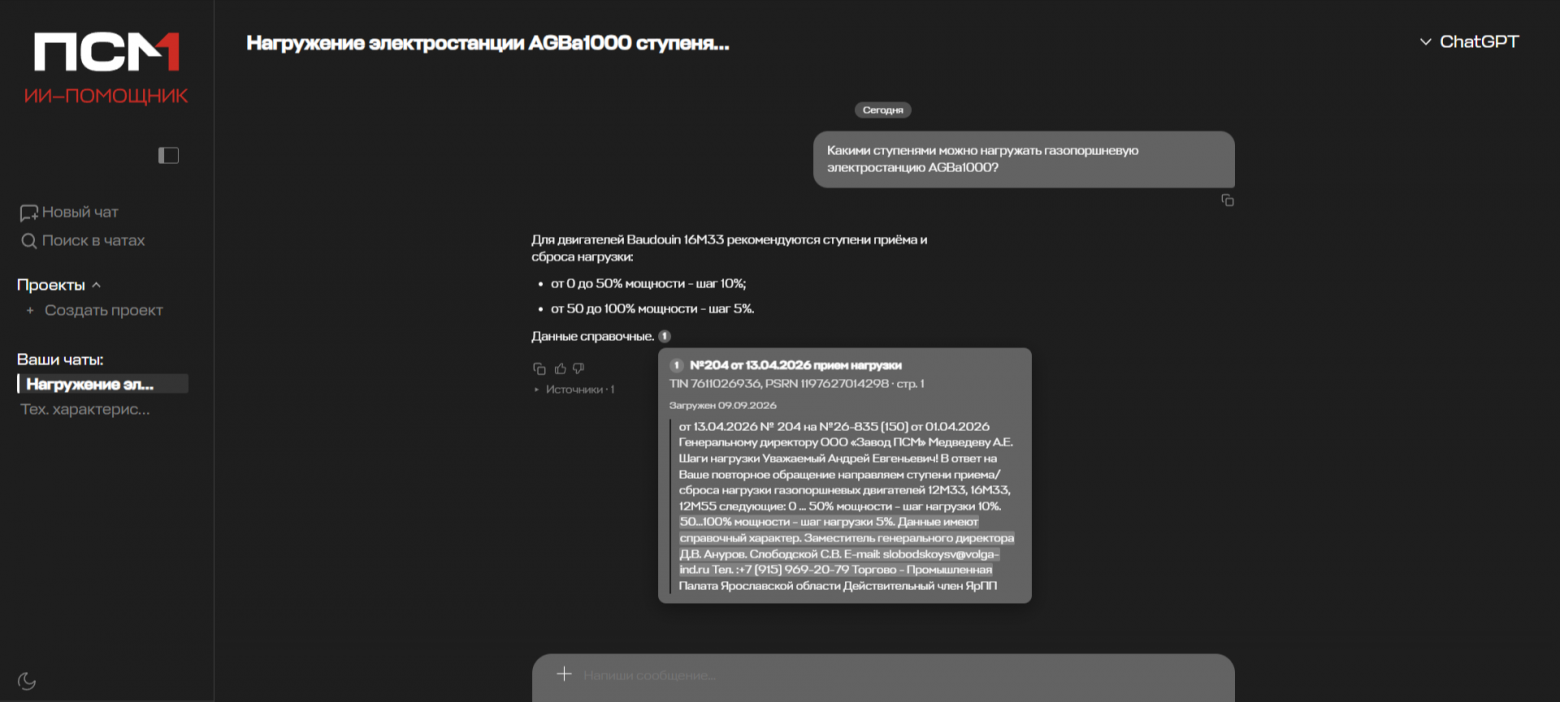
Второй вывод: папка с документами — ещё не база инженерных знаний. Нужны связи между моделями, комплектующими, исполнениями и версиями документации. Без них даже правильно найденная информация может оказаться бесполезной.
Кейс №3. Мы спросили AI про топливный бак газовой электростанции
Третий эксперимент особенно хорошо показывает разницу между поиском информации и пониманием задачи.
Тестировщик попросил рассчитать время непрерывной работы AGBa1000 на полном топливном баке при нагрузках 50, 75 и 100%.
AI нашёл расход природного газа для соответствующих режимов: 161, 229 и 294 м³/ч. Затем объяснил, что для расчёта не хватает объёма топливного бака, и даже составил формулы, в которых предложил разделить запас газа на часовой расход.
На первый взгляд может показаться, что система повела себя аккуратно: данных нет — значит, не выдумываем. Однако система пропустила ошибку на самом начальном этапе — в предпосылке самого запроса.
Наша установка работает на природном газе, который, согласно документации, подаётся от внешней магистрали. У неё в принципе нет и не может быть «топливного бака». Запрос объёма несуществующего резервуара и составление математических формул стали грубым дефектом ответа. Система безоговорочно приняла ложную предпосылку пользователя и начала строить расчет на вводных, которые здесь не применимы. Поэтому первая реакция инженера была бы другой: о каком топливном баке вообще идёт речь?
Только после нескольких уточнений пользователь получил практически полезный ответ: можно рассмотреть подключение станции к газопроводу, предварительно проверив параметры подачи газа и требования оборудования.
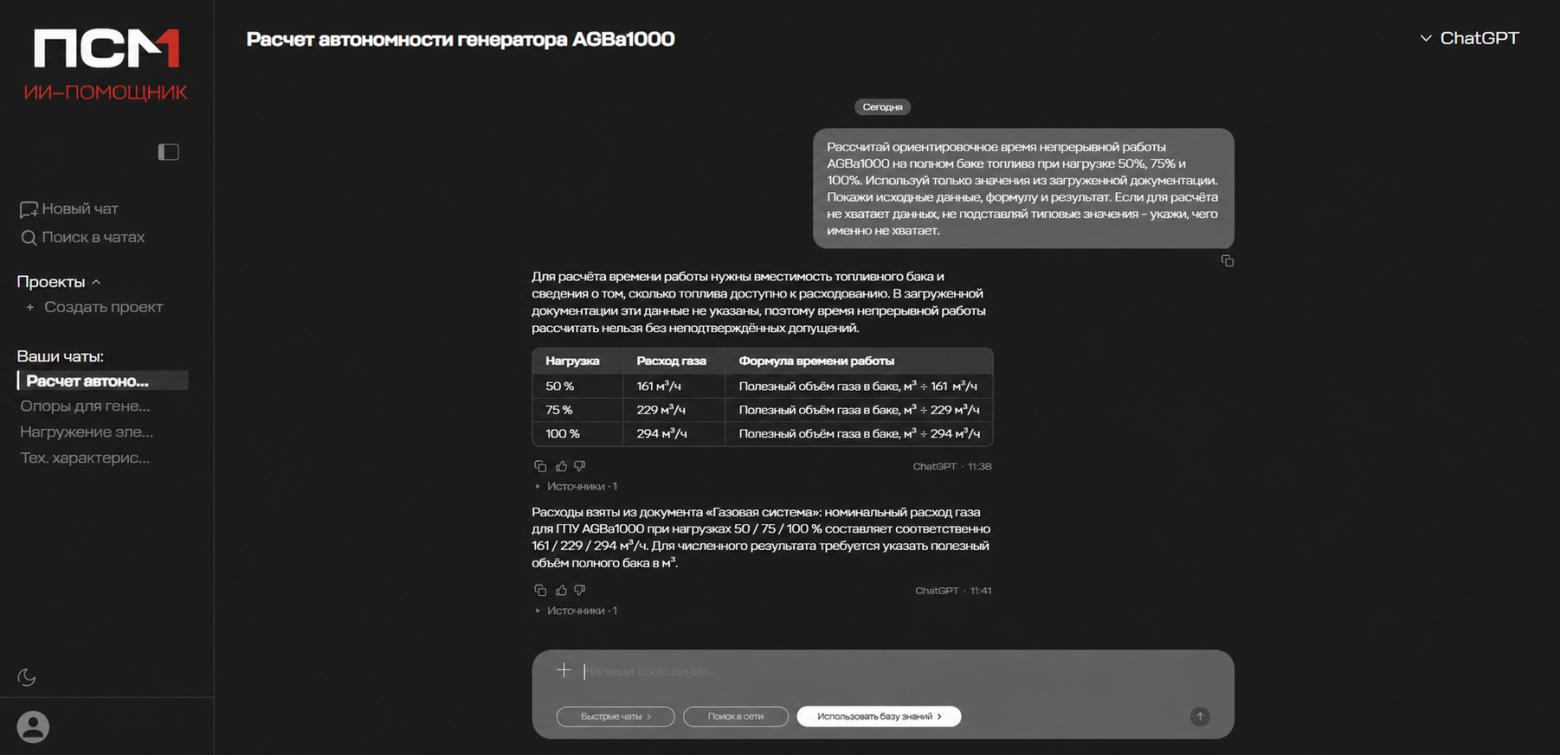
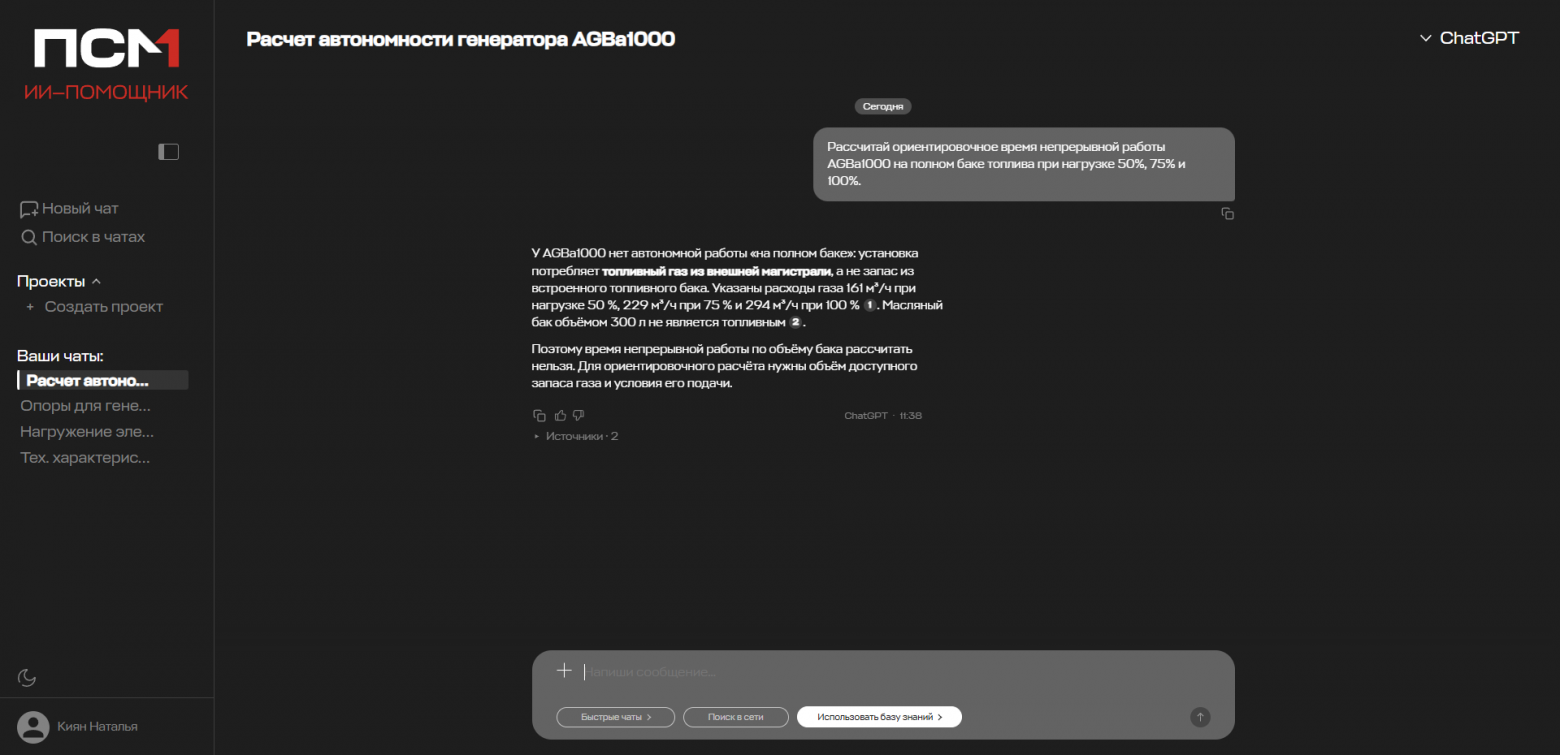
Получается парадокс. Система корректно извлекла расход топлива, не стала придумывать отсутствующие характеристики и при этом не смогла сразу помочь пользователю решить его задачу, потому что не указала на ошибку в самом запросе.
Этот случай особенно важен для нас, потому что корпоративный AI создаётся не только для опытных инженеров. Им должны пользоваться менеджеры, сотрудники сервиса и другие специалисты, которые не всегда знают технические нюансы и могут неправильно сформулировать вопрос.
Если ассистент требует от человека заранее понимать устройство оборудования и безошибочно ставить задачу, его практическая ценность снижается.
Третий вывод: AI-помощник должен замечать ошибочные предпосылки. Иногда лучший ответ в объяснении, почему считать предложенным способом будет неправильно.
Как объяснить ИИ противоречия в документации
Тестирование RAG привело нас к проблеме, с которой сталкивается любое предприятие — качество исходных данных.
Когда инженеры начали готовить эталоны и сверять базу знаний, выяснилось, что разные официальные заводские документы могут противоречить друг другу.
Два показательных примера:
Мощность в длительном режиме: в паспорте электростанции указано 1150 кВт, а в свежем документе производителя двигателя — 1280 кВт.
Регламент ТО: руководство по эксплуатации станции предписывает менять свечи зажигания каждые 1500 моточасов, а сервисная инструкция завода-изготовителя двигателя указывает интервал в 5000 часов.
Что должен отвечать AI, если в двух официальных документах из базы написаны разные вещи?
Выбрать более свежий файл? Взять то, что встречается чаще? Усреднить?
Ни один из этих вариантов недопустим. Единственное верное поведение системы — не пытаться угадать «правильную» цифру, а прямо подсветить конфликт:
«В руководстве по эксплуатации AGBa1000 (раздел 4, стр. 18) указан интервал 1500 моточасов. Однако в сервисной инструкции двигателя (ред. 2024 г., табл. 3) регламент составляет 5000 часов. Требуется подтверждение инженера».
Мы рассчитываем использовать такой поиск как инструмент первичного аудита документации: модель может быстро подсветить несовпадение цифр в разных файлах. Но устранять эти нестыковки всё равно приходится вручную, потому что система не знает и не может знать, какая из противоречащих спецификаций согласована под конкретный заказ.
Что уже исправили, а что ещё в работе
Результаты показали, что одной универсальной оценки точности недостаточно.
По таблицам и парсингу (кейс со 161 опорой)
Что произошло: Модель выдала несуществующее число из-за склейки столбцов в сканированном PDF-документе.
Причина: Парсер читал скан как сплошной текст, теряя границы ячеек и привязку строк к заголовкам.
Что уже сделали: Перешли к построчной индексации структурированных таблиц. Каждая строка теперь сохраняется в индекс вместе с шапкой таблицы как отдельный смысловой факт. В основном тесте это подняло долю правильных чисел в ответах с 70,8% до 78,3%.
Что в работе: Построчный парсинг решил проблему для «чистых» файлов (Excel, сверстанные PDF), но сложные графические сканы с чертежами и рукописными пометками всё ещё сбоят. Сейчас мы тестируем отдельный модуль анализа разметки, который перед отправкой в OCR валидирует геометрию сетки. Повторный прогон сканов с письмами производителей запланирован на следующий цикл тестов.
По иерархии оборудования (кейс со ступенями нагрузки)
Что произошло: Система нашла требования по двигателю, но не связала их с готовой электростанцией.
Причина: База знаний была «плоской» папкой файлов без метаданных о составе изделия.
Что уже сделали: Добавили в индекс граф связей оборудования: конкретное исполнение станции связано с марками установленного двигателя, генератора и контроллера. Поиск научился подтягивать документацию комплектующих по запросу о станции.
Что в работе: Настройка фиксации границ применимости. Модель должна добавлять оговорку: «Данные приведены для двигателя. Допустимость наброса нагрузки для комплектной ГПУ требует подтверждения». Пока этот механизм тестируется на контрольной выборке вопросов.
По смысловому контексту (кейс с баком для газа)
Что произошло: AI попытался рассчитать объем несуществующего топливного бака для станции, работающей от магистрального газопровода.
Причина: Отсутствие верификации входных предпосылок пользователя. Модель слепо искала ключевые слова «бак» и «расход».
Что уже сделали: Зафиксировали проблему и описали сценарии некорректных вопросов.
Что в работе: Разрабатываем валидатор запросов. Перед тем как запускать RAG-поиск, модуль сопоставляет ключевые сущности запроса с конструктивным профилем станции. Если в вопросе звучит «топливный бак», а в паспорте изделия указано «топливо — природный газ, питание от газопровода», система уточняет это, а не пытается подставить цифры в бессмысленные формулы.
Так можно ли доверить RAG работу инженера?
Пока нет, и таким образом ставить задачу в принципе неверно.
Наша цель в этом пилоте — дать сотрудникам инструмент быстрой и прозрачной навигации по заводской документации. Чтобы инструментом можно было безопасно пользоваться, он должен отвечать трем критериям:
Применимость сведений: ответ должен учитывать реальную комплектацию оборудования вместо абстрактных цифр из интернета или паспортов похожих узлов.
Прослеживаемость источника: любая цифра в ответе должна сопровождаться прямой ссылкой на документ, страницу и пункт технического описания, чтобы инженер мог проверить факт за 10 секунд.
Понимание границ: если в документации есть пробел, расхождение ревизий или физически некорректный вопрос — ассистент обязан прямо заявить об этом, а не пытаться сгенерировать правдоподобную догадку.
Пока система не гарантирует проверяемость каждого ответа до первоисточника, она остается внутренним экспериментальным сервисом.
Что дальше
Доработки пайплайна сейчас в самом разгаре. Как только мы закончим этот этап изменений, мы снова прогоним систему через наш зафиксированный контрольный набор из 188 вопросов. Это позволит на одних и тех же данных увидеть чистую динамику: сколько старых ошибок удалось закрыть, не появились ли новые регрессии и как изменился процент ложных отказов.
Во следующей статье покажем результаты этого повторного замера и разберем, где RAG всё ещё продолжает спотыкаться. А в отдельной публикации проведем строго контролируемый сравнительный тест нашего ассистента против публичных LLM на одинаковых инженерных вопросах.

Комментарии 0