Сотрудник пытается отправить заявку в ИТ-поддержку, но портал не открывается. Он пишет на почту, а через несколько минут выясняется, что войти в систему не могут и сами специалисты поддержки. Новые обращения зарегистрировать негде, история предыдущих недоступна, а привычные маршруты эскалации перестали работать.
Инженеры могут собраться в рабочем чате, пользователи — отправлять письма, а руководитель поддержки — обзванивать дежурных, но все равно управлять инцидентами без общей системы учета гораздо сложнее, чем кажется.
Привет, это команда SimpleOne ITSM. В этот раз своим опытом поделится эксперт-практик по управлению услугами SimpleOne Дмитрий Сёмин. Вместе разберем, что происходит при отказе ITSM-платформы, как организовать работу поддержки без нее и что необходимо подготовить заранее.
Что происходит с поддержкой при разных сценариях отказа
Недоступность сервис-деска не всегда означает полный отказ ITSM. Иногда перестает работать только портал самообслуживания или отдельная интеграция, а в других случаях поддержка теряет доступ ко всей платформе.
От масштаба сбоя зависит, сможет ли команда продолжить работу привычными способами или ей придется переходить на резервные процессы.
Что сломалось | Последствия для поддержки |
Портал самообслуживания | Пользователи не могут создавать заявки. Если интерфейс ITSM доступен, специалисты регистрируют обращения самостоятельно или через почту |
Почтовая интеграция | Письма не превращаются в заявки автоматически. На портале самообслуживания вывешивается уведомление об инциденте с указанием доступных на текущий момент способов обращения в ТП |
Корпоративная авторизация (SSO) | Пользователи и специалисты не могут войти в ITSM, если альтернативная авторизация не предусмотрена |
База данных ITSM | Возникают проблемы с чтением и сохранением обращений. Возможен полный отказ платформы |
Вся ITSM-система | Недоступны заявки, история инцидентов, маршрутизация и контроль SLA. Читаем почту вручную и помогаем пользователям |
Облачная инфраструктура | Вместе с ITSM могут перестать работать почта, мессенджеры и другие зависимые инструменты |
Особенно опасна ситуация, когда резервные инструменты зависят от той же инфраструктуры, что и ITSM. Инструкции по восстановлению хранятся в ее базе знаний, контакты дежурных — в корпоративном каталоге, а резервный журнал — в облачном документе. При масштабном отказе все три инструмента могут оказаться недоступны.
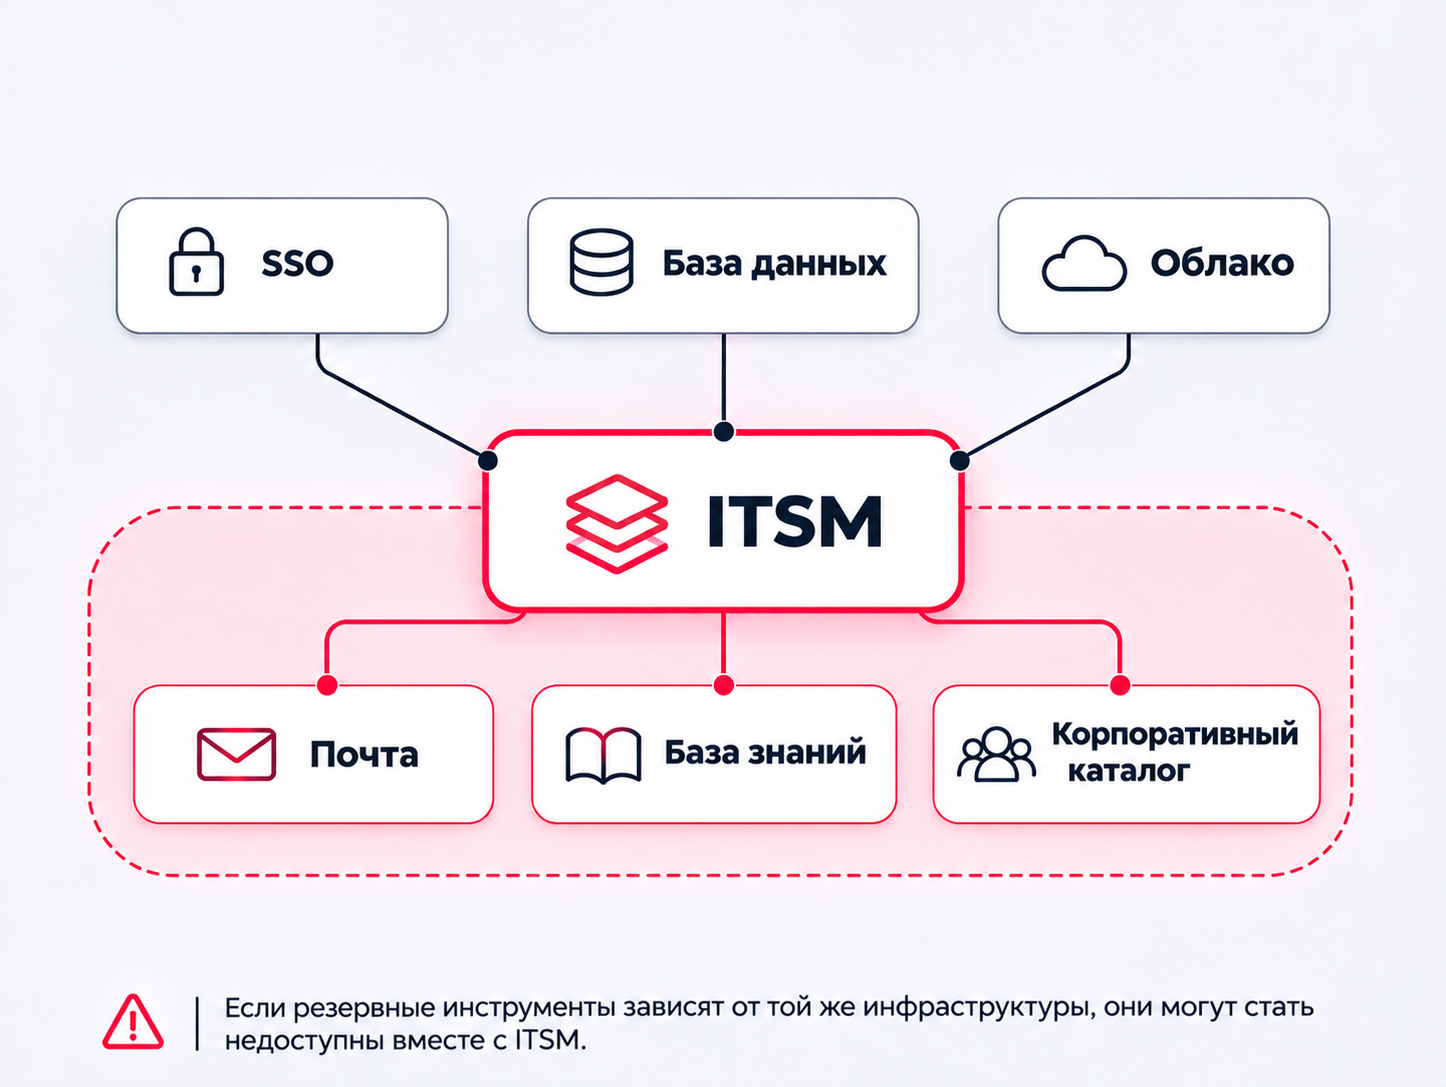
Поэтому нужно заранее определить, при каких сбоях поддержка продолжает работу в штатном режиме, а когда переходит на резервные процессы.
Как не потерять контроль над обращениями
При полном отказе ITSM поддержке нужен координатор резервного режима. Он организует работу специалистов, следит за распределением обращений и отвечает за эскалацию критичных инцидентов. Важно, чтобы команда заранее знала, кто принимает решения во время аварии и как передаются задачи между сменами, иначе обращения могут потеряться между специалистами, а критичные проблемы останутся без ответственных.
Предположим, ITSM полностью вышла из строя. Пользователи продолжают обращаться в поддержку, но заявки не регистрируются, а специалисты не видят историю предыдущих обращений.
Телефон и электронная почта помогут сохранить связь, но сами по себе не заменят систему учета. Поддержке по-прежнему нужно регистрировать обращения, назначать исполнителей и контролировать результаты работы.
Резервный канал приема обращений
Первое, что нужно предусмотреть, — независимый канал связи: отдельную почту, телефонную линию или мессенджер. Важно, чтобы он оставался доступным при отказе инфраструктуры, от которой зависит ITSM, включая системы авторизации.
Если ITSM размещена в облаке, резервную почту можно организовать на независимой инфраструктуре. Иначе масштабная авария может одновременно вывести из строя оба канала.
Также необходимо определить, какие обращения будут обрабатываться во время сбоя. При ручной регистрации нагрузка на поддержку возрастает, поэтому приоритет стоит отдавать инцидентам, которые останавливают критичные бизнес-процессы. Некритичные запросы на обслуживание можно отложить до восстановления системы.
Ручной журнал вместо очереди заявок
Для временного учета обращений необязательно разворачивать вторую ITSM. При ограниченном потоке заявок подойдет таблица или другой доступный команде инструмент.
Минимальная запись может выглядеть так:
Поле | Пример записи |
Временный номер | DR-001 |
Дата и время | 05.11, 10:45 |
Источник | Резервная почта |
Заявитель | Сотрудник финансового отдела |
Затронутая услуга | Корпоративная VPN |
Приоритет | Высокий |
Исполнитель | Дежурный сетевой инженер |
Статус | В работе |
Последнее действие | Проверяется доступность VPN-шлюза |
Конечно, у журнала должен быть ответственный за актуальность записей. Если обращения принимают несколько специалистов или смен, необходимо договориться о правилах присвоения номеров, обновления статусов и передачи незавершенных задач, иначе временная таблица быстро превратится в источник путаницы.
При этом резервный журнал должен храниться вне общей с ITSM зоны отказа, чтобы оставаться доступным во время аварии.
Как провести инцидент от регистрации до закрытия без ITSM
После регистрации обращения во временном журнале поддержке нужно организовать его обработку. Для этого достаточно сохранить основные этапы жизненного цикла инцидента.
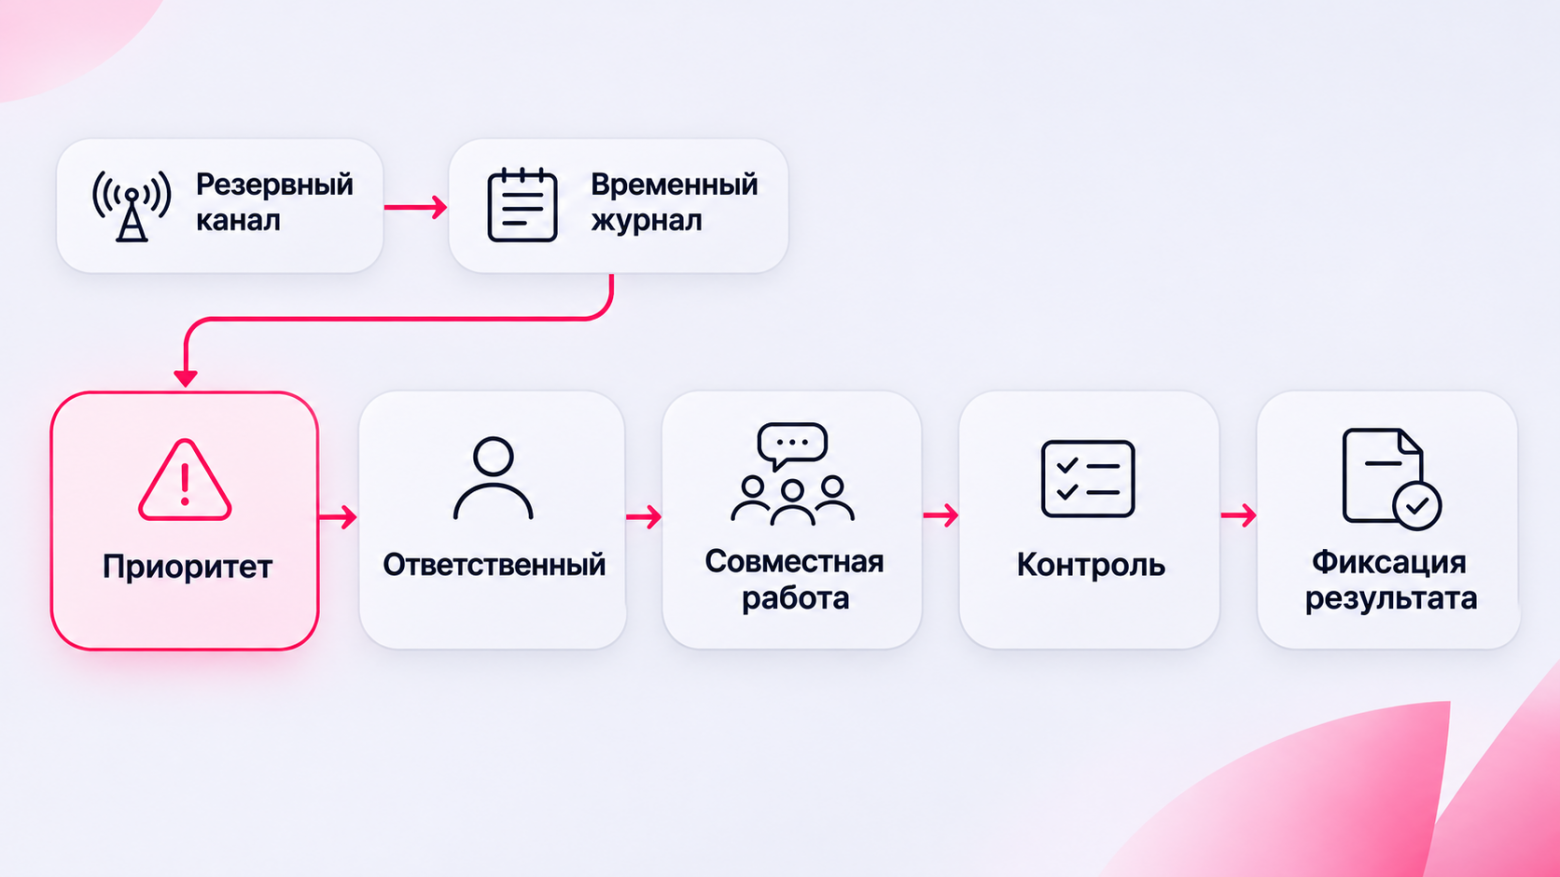
1. Определить приоритет
Приоритет определяют по влиянию на бизнес и срочности, а не по порядку поступления обращений. Сбой платежей важнее запроса на установку ПО. Но и потеря VPN у одного сотрудника может оказаться критичной, если именно он отвечает за срочный платеж.
Для таких ситуаций стоит заранее подготовить упрощенную матрицу приоритетов, которой специалисты смогут пользоваться без доступа к ITSM.
2. Назначить ответственного
Координатор назначает ответственного за каждый инцидент и фиксирует его в журнале. Даже если восстановлением занимаются несколько технических команд, у инцидента должен оставаться один ответственный за координацию работ.
При передаче обращения другому специалисту это изменение также фиксируют.
3. Организовать совместную работу
Если инцидент требует участия нескольких команд, можно использовать сворминг — совместную работу специалистов разных направлений. Для координации понадобится независимый от ITSM канал связи.
Обращения, связанные с одним массовым сбоем, не нужно связывать между собой: в разгар аварии на это не останется времени. Достаточно пометить их общей меткой, например «VPN-05.11», и при необходимости отфильтровать журнал по ней. Связь с основным инцидентом восстановят позже, при переносе записей в ITSM.
4. Контролировать выполнение
Координатор проверяет ход работ, актуальность статусов и необходимость эскалации. Частота проверок зависит от приоритета инцидента.
При массовом сбое пользователей удобнее информировать через независимую страницу статуса или резервный канал связи, а не отвечать каждому отдельно.
5. Зафиксировать результат
После восстановления услуги в журнале фиксируют:
время восстановления;
выполненные действия и обходные решения;
установленную причину, если ее удалось подтвердить;
экстренные изменения инфраструктуры, включая согласовавшего их специалиста и результат.
Эти сведения понадобятся при последующем переносе обращений в ITSM.
Сервис-деск восстановлен. Что делать с накопившимися заявками
После восстановления ITSM часть инцидентов уже может быть решена, другие останутся в работе, а некоторые пользователи успеют обратиться по нескольким резервным каналам.
Поэтому перед переносом данных нужно проверить их полноту, устранить дубликаты и восстановить историю действий. Давайте по шагам разберем алгоритм, по которому стоит действовать.
Шаг 1. Собрать обращения из всех резервных каналов
Команда сверяет временный журнал с резервной почтой, журналами звонков и сообщениями в мессенджерах. Например, за четыре часа вручную зарегистрировали 80 обращений. При сверке обнаружились еще семь необработанных писем и три звонка, которые специалисты не внесли в журнал.
Проверьте заявки, отправленные непосредственно перед отказом: часть из них могла не сохраниться. Отдельно учтите письма, накопившиеся за время простоя: после восстановления почтовая интеграция может создать по ним заявки, которые дублируют записи журнала.
Результат: полный список обращений, требующих проверки и переноса.
Шаг 2. Найти дубликаты и проверить статусы
Один пользователь мог сообщить о проблеме по телефону, почте и в мессенджере. Чтобы два специалиста не взялись за одну задачу, дубли нужно отслеживать еще во время ручной работы, при определении приоритета и назначении ответственного. Перед переносом записи все равно нужно сопоставить по заявителю, услуге, времени и описанию.
При этом десять сообщений от разных сотрудников о массовом отказе VPN не обязательно являются дубликатами. Такие обращения могут требовать отдельного учета, сохраняя связь с основным инцидентом. Также необходимо проверить актуальные статусы. Переносить уже решенные обращения как новые нельзя.
Результат: список с актуальными статусами и установленными связями между обращениями.
Шаг 3. Перенести записи в ITSM и восстановить историю действий
При переносе важно сохранить исходное время обращения, временный номер из журнала (например, в дополнительном поле или в описании заявки), исполнителя, приоритет и выполненные работы.
Возьмем инцидент DR-001: обращение поступило в 10:45, а к восстановлению ITSM в 14:00 все еще было в работе. Если система сохранит только время создания записи при импорте, отсчет начнется с 14:00, и реальное время ожидания пользователя потеряется, а отчетность окажется искажена. Обращения, которые уже решили во время аварии, переносить необязательно: они остаются в журнале. Если они нужны для отчетности, их переносят сразу как закрытые.
Исторические данные можно перенести через штатный импорт, API или дополнительные поля. Конкретные возможности зависят от ITSM. При этом важно сохранить фактическое время поступления, не подменяя техническую историю создания записи.
Отдельно необходимо восстановить сведения об экстренных изменениях инфраструктуры.
Результат: обращения зарегистрированы в ITSM, а история работы сохранена.
Шаг 4. Проверить полноту переноса и вернуться к штатной работе
После импорта нужно сверить количество обращений с учетом объединенных дубликатов. У каждого незакрытого инцидента должны быть актуальный статус, назначенный исполнитель и следующее действие.
Работу почтовых интеграций, маршрутизации, уведомлений и контроля SLA проверяют администраторы платформы. Поддержка же убеждается на тестовой заявке, что она дошла до нужной группы, а таймер SLA запустился. Доступный интерфейс еще не означает полного восстановления процессов.
После сверки временный журнал можно перевести в режим только для чтения и сохранить на срок, установленный внутренними правилами.
Результат: поддержка вернулась к штатной работе, а незавершенные обращения остались под контролем.
Что делать после переноса
После восстановления необходимо разобрать причины отказа и оценить работу резервных процессов. Если обращения терялись между почтой и журналом, стоит пересмотреть правила регистрации. Если перенос занял целый рабочий день — подготовить шаблон импорта или автоматизированную сверку.
Корректирующие действия фиксируют в ITSM, назначают ответственных и контролируют выполнение.
Как подготовить ITSM к возможным сбоям
Резервные каналы позволяют поддержке продолжать работу, но саму ITSM-платформу необходимо восстановить. Для этого нужен технический план.
Определить допустимое время простоя
В первую очередь устанавливают два показателя:
Показатель | Что означает |
RTO (Recovery Time Objective) | Максимальное целевое время восстановления системы после отказа |
RPO (Recovery Point Objective) | Максимально допустимый период потери данных |
Например, RTO в четыре часа означает, что платформу планируют восстановить за это время, а RPO в 15 минут допускает потерю данных не более чем за последние 15 минут перед сбоем.
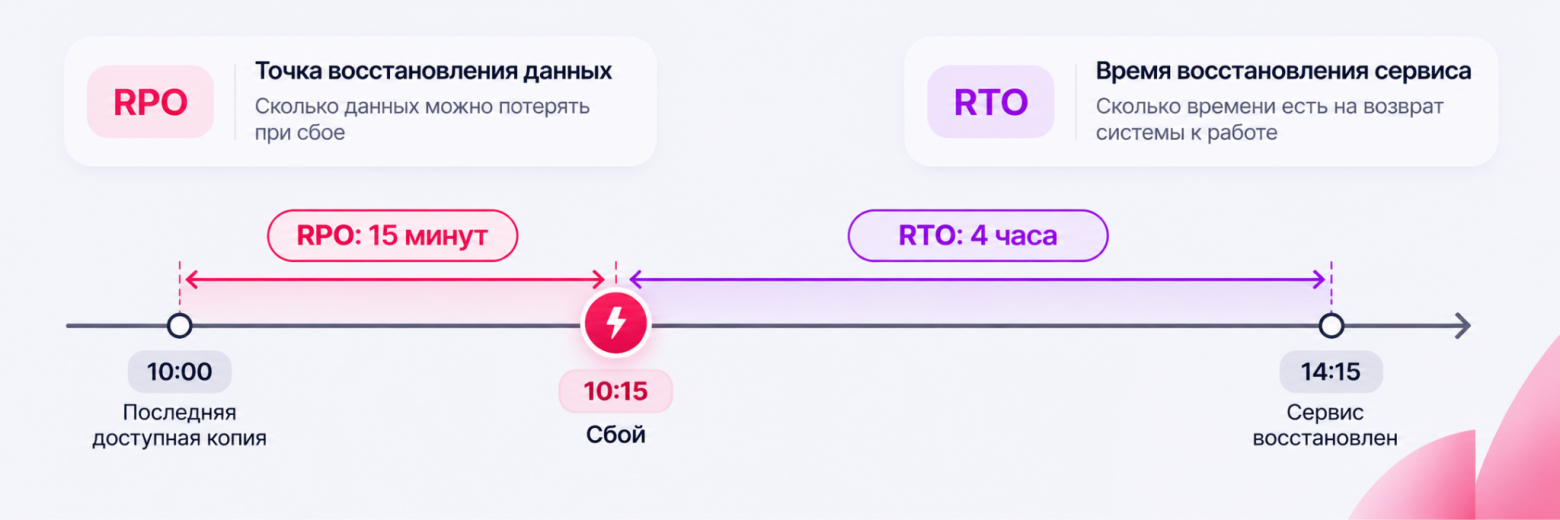
Значения согласовывают с бизнесом с учетом критичности услуг, нагрузки на поддержку и затрат на резервирование.
Найти зависимости и точки отказа
Даже исправная ITSM может оказаться недоступной из-за отказа авторизации, сети, базы данных или других зависимых компонентов.
При подготовке к аварии стоит проверить:
Компонент | Что проверить |
Авторизация | Можно ли войти в ITSM при отказе корпоративного SSO |
Резервные копии | Хранятся ли они независимо от основной инфраструктуры |
Каналы связи | Останутся ли доступны резервные коммуникации и инструкции |
Инфраструктура | Нет ли общих точек отказа у основной и резервной площадок |
Модель размещения также влияет на восстановление. При on-premise ответственность за инфраструктуру несет организация или ее подрядчик. В облаке часть задач выполняет провайдер, но гарантии зависят от договора и архитектуры сервиса.
Подготовить сценарий восстановления
Наличие резервных копий еще не гарантирует соблюдение RTO. Восстановление базы может занять час, но развертывание приложения, настройка сети и запуск интеграций потребуют дополнительного времени.
Поэтому план должен определять:
Источник восстановления: где хранятся резервные копии.
Инфраструктуру: где будет запущена ITSM.
Ответственных: кто принимает решение о переключении.
Последовательность: в каком порядке восстанавливаются компоненты.
Проверку: как подтвердить целостность данных, доступ пользователей и работу интеграций.
Для критичных систем можно предусмотреть заранее подготовленный резервный экземпляр, если позволяют архитектура и бюджет.
Проверить план на практике
Проверять нужно два сценария:
Техническое восстановление: запуск ITSM из резервной копии или переключение на резервную инфраструктуру.
Работу поддержки: прием, распределение и обработку обращений без доступа к платформе.
По итогам испытаний фактическое время восстановления и потерю данных сравнивают с RTO и RPO. Если требования не выполнены, корректируют процедуру или архитектуру резервирования.
Чек-лист: готов ли ваш сервис-деск к отказу
Проверьте, сможет ли поддержка продолжать работу при недоступности ITSM.
Определены допустимое время простоя и требования к восстановлению?
Есть резервные копии и проверенный порядок восстановления?
Предусмотрен независимый канал приема обращений?
Контакты дежурных и инструкции доступны вне ITSM?
Подготовлен временный журнал регистрации заявок?
Назначены ответственные за распределение обращений и эскалацию?
Есть способ информировать пользователей без ITSM?
Определен порядок переноса накопившихся обращений?
Резервные процессы хотя бы раз проверялись на практике?
Каждый отрицательный ответ указывает на потенциальный риск. Чтобы выявить слабые места, попробуйте обработать несколько тестовых обращений без доступа к ITSM. Это покажет, какие резервные инструменты действительно работают.
Резюме
Отказ ITSM-системы не обязательно останавливает ИТ-поддержку. Обращения можно принимать через независимые каналы, регистрировать во временном журнале и распределять между специалистами вручную.
Для этого необходимо заранее определить допустимое время простоя, подготовить резервные инструменты, распределить ответственность и проверить порядок восстановления.
Главное — план действий на случай отказа ITSM должен храниться за ее пределами. Иначе в момент аварии открыть инструкцию будет так же сложно, как зарегистрировать новый инцидент.



Комментарии 0