Меня зовут Василий, и я руковожу командой тестирования систем хранения данных (СХД) в АЭРОДИСК. Мы проверяем, как программный движок и аппаратные платформы работают под нагрузкой и при отказах: разные слои, профили нагрузки и сбои. На каждом слое свое узкое место, поэтому одного генератора нагрузки мало.
Генератор нагрузки создает поток запросов и показывает, сколько система выдает. Нам нужны еще три ответа: где предел, что будет при отказе и не врет ли сам замер. Поэтому у нас свой инструмент: методика должна жить в инструменте, а не в голове дежурного. В статье разберем, почему хорошего среднего недостаточно, как выбрать момент для измерения и по каким правилам решаем, пройден ли тест.
Почему приложение тормозит при хорошем среднем
Приложение обычно отвечает быстро, но иногда надолго замирает. Пользователь видит редкие медленные запросы, а в отчете - приличное среднее. Причина может быть в системе хранения: среднее арифметическое скрывает небольшую долю медленных операций. В этом смысле хвост виляет собакой: редкие операции определяют впечатление, хотя в среднем все выглядит ровно.
Сначала посмотрим на пример, потом на условия замера и только затем на правила приемки. Так будет понятнее, откуда берутся требования.
Что скрывают три медленные операции
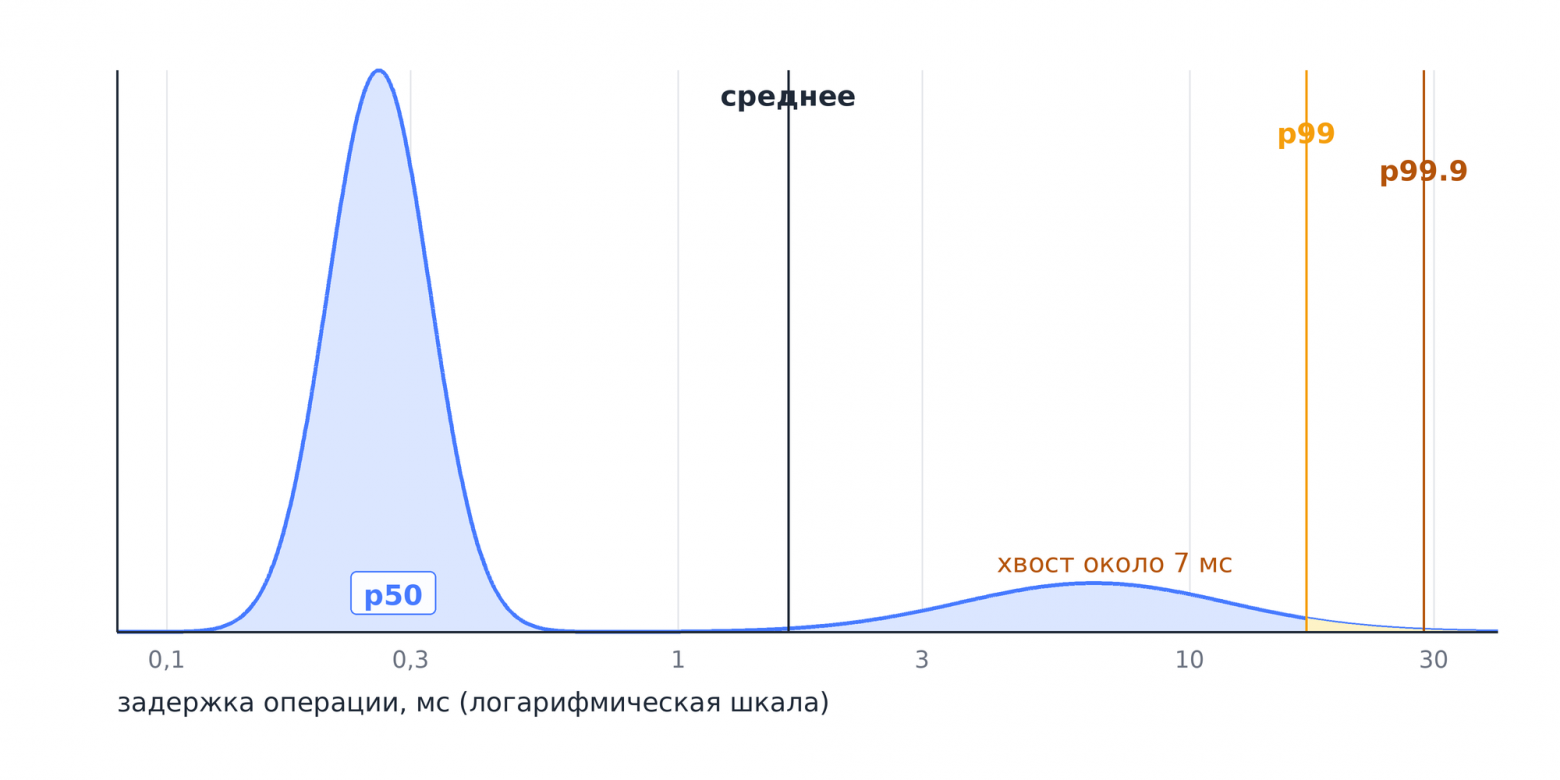
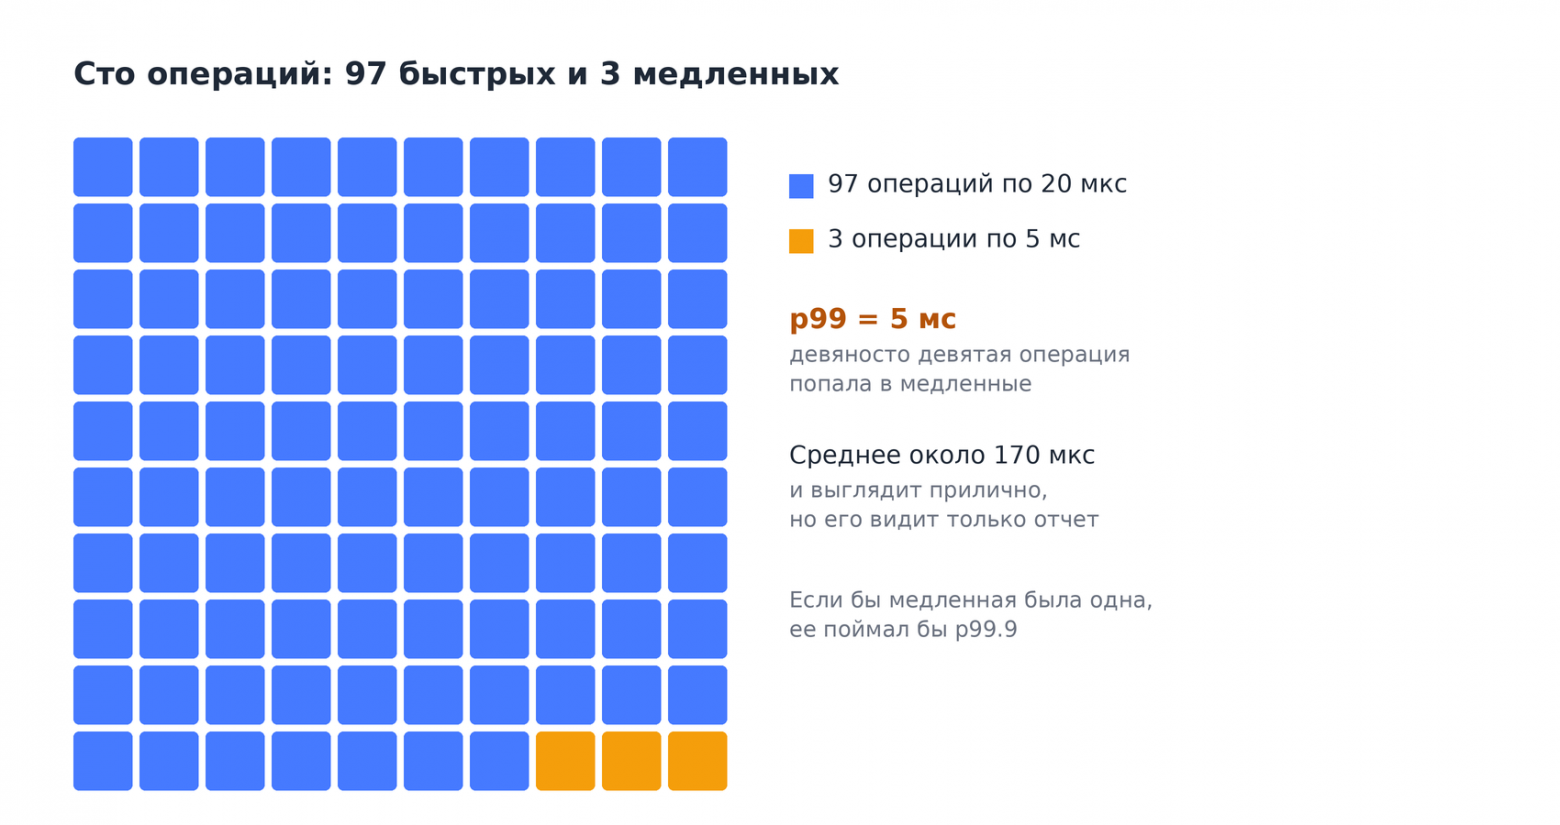
Возьмем 100 операций: 97 по 20 мкс и 3 по 5 мс. Медиана делит поток пополам: половина операций быстрее, половина медленнее. p99 - перцентиль: порог, в который уложились 99% операций.
Что смотрим | Значение |
|---|---|
Среднее арифметическое | около 170 мкс |
Медиана (p50) | 20 мкс |
p99 | 5 мс |
Среднее выглядит прилично, но пользователь ждет 5 мс в трех случаях из ста. Почему p99 равен 5 мс? Расположим операции по возрастанию. Три медленные операции попали в конец ряда, поэтому 99-я операция занимает 5 мс. Это значение и есть p99 при выбранном способе расчета. Медиана показывает типичное ожидание, но не показывает редкие провалы.
Если медленная операция одна из ста, p99 остается на 20 мкс, а ее ловит p99.9. Для такой оценки нужны тысячи измерений: на сотне операций p99.9 - это одна операция, и результат будет грубым. Поэтому в отчете оба перцентиля: p99 ловит частые всплески, p99.9 - редкие.
Перцентили считаем по каждому измерению, а не по усредненным за секунду значениям. Если сначала усреднить задержку по секунде, а потом взять перцентиль, хвост исчезнет: среднее арифметическое сгладит выброс. Поэтому храним сами замеры и считаем перцентили уже из них.
Когда результатам теста можно доверять
После старта система некоторое время работает иначе: заполняется кэш, меняется нагрузка на внутренние компоненты. Поэтому мы повторяем тест с одинаковыми настройками и смотрим, насколько отличаются результаты. Близость повторов называют сходимостью. Здесь два вопроса. Насколько сильно отличаются последние повторы? Продолжают ли результаты постепенно расти или падать?
Если ответы нас не устраивают, для сравнения еще рано: цифры описывают переходный процесс, а не установившийся режим. Установившийся режим, его еще называют устойчивым, - состояние, когда результаты повторов перестали уплывать. По методике SNIA мы берем окно последних 5 повторов (раундов) и проверяем два условия. Разброс - разница между максимумом и минимумом - не больше 20% от среднего по окну. Тренд - наклон линейного приближения за все окно - не больше 10%.
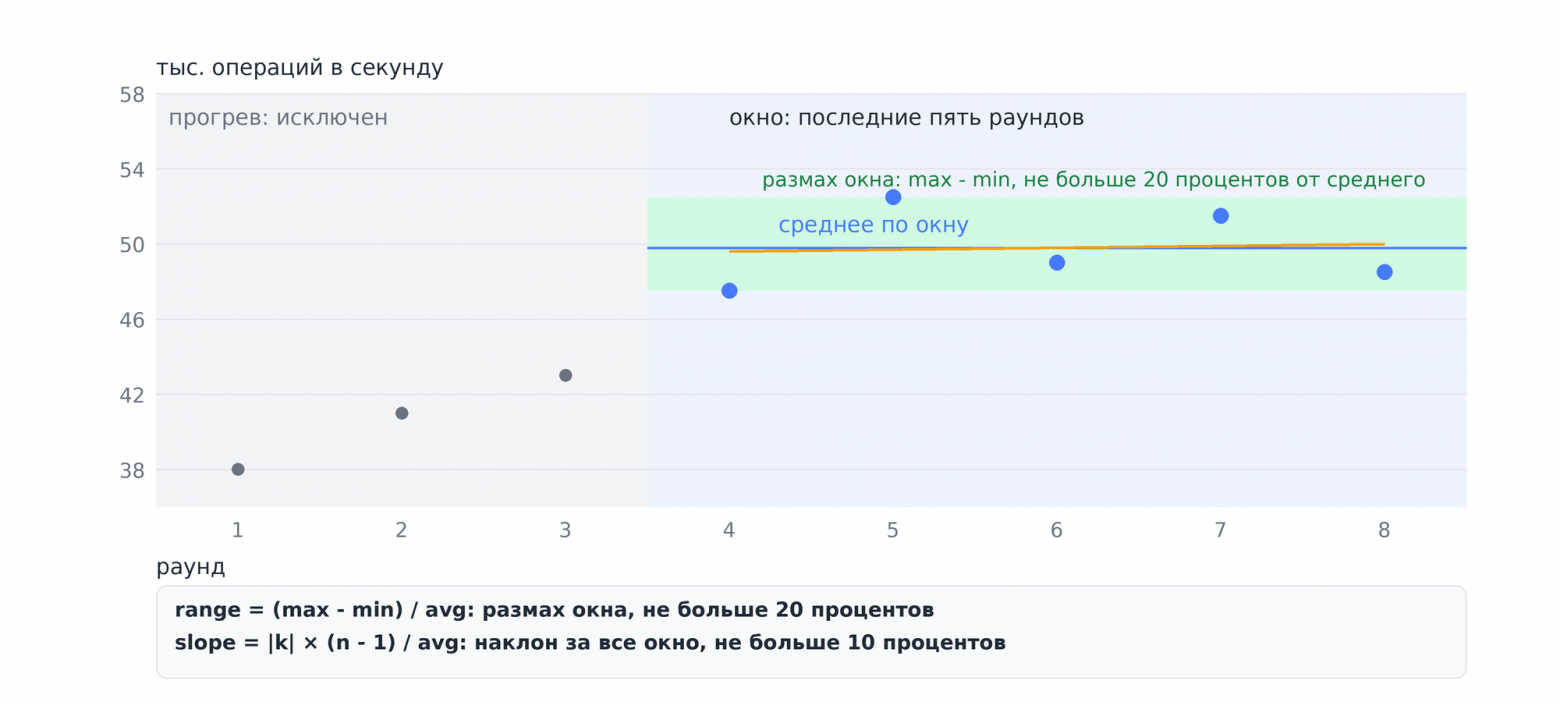
Если сходимости нет, строка про сходимость получает «не годен», а остальные строки остаются в отчете справочно. Эталон - сохраненный контрольный результат, снятый в устойчивом режиме; поэтому цифра из переходного процесса с ним несравнима. Быстрый режим на 2-6 повторов нужен для проверки гипотез, а не для приемки. Формулы и точные определения - в подробностях.
Как решаем, что тест пройден
Приемка - это проверка, соответствует ли система заранее согласованным требованиям. Критерии записываем в план до прогона. Иначе получается подгонка: сначала померили, потом решили, что «плюс 20% нормально». В основной проверке четыре вопроса.
Что проверяем | Зачем |
|---|---|
Скорость и задержку | Система должна выполнять требования под нагрузкой |
Ошибки и разрывы соединений | Хорошая скорость не компенсирует сбои |
Отдельные машины, создающие нагрузку | Общий результат может скрывать проблему одной машины |
Полноту измерений | Отсутствие данных нельзя считать успешной проверкой |
Каждую строку проверяет инструмент, а итог приемки собирается по худшему узлу. Хост - машина, которая создает нагрузку; стенд - все хосты вместе. Если хотя бы один хост не прошел, стенд не годен. Хостов не всегда 10 - это пример на схеме. Отдельно проверяем минимумы по всему стенду: если суммарные операции ниже плана, прогон не пройдет, даже когда все хосты по отдельности прошли.
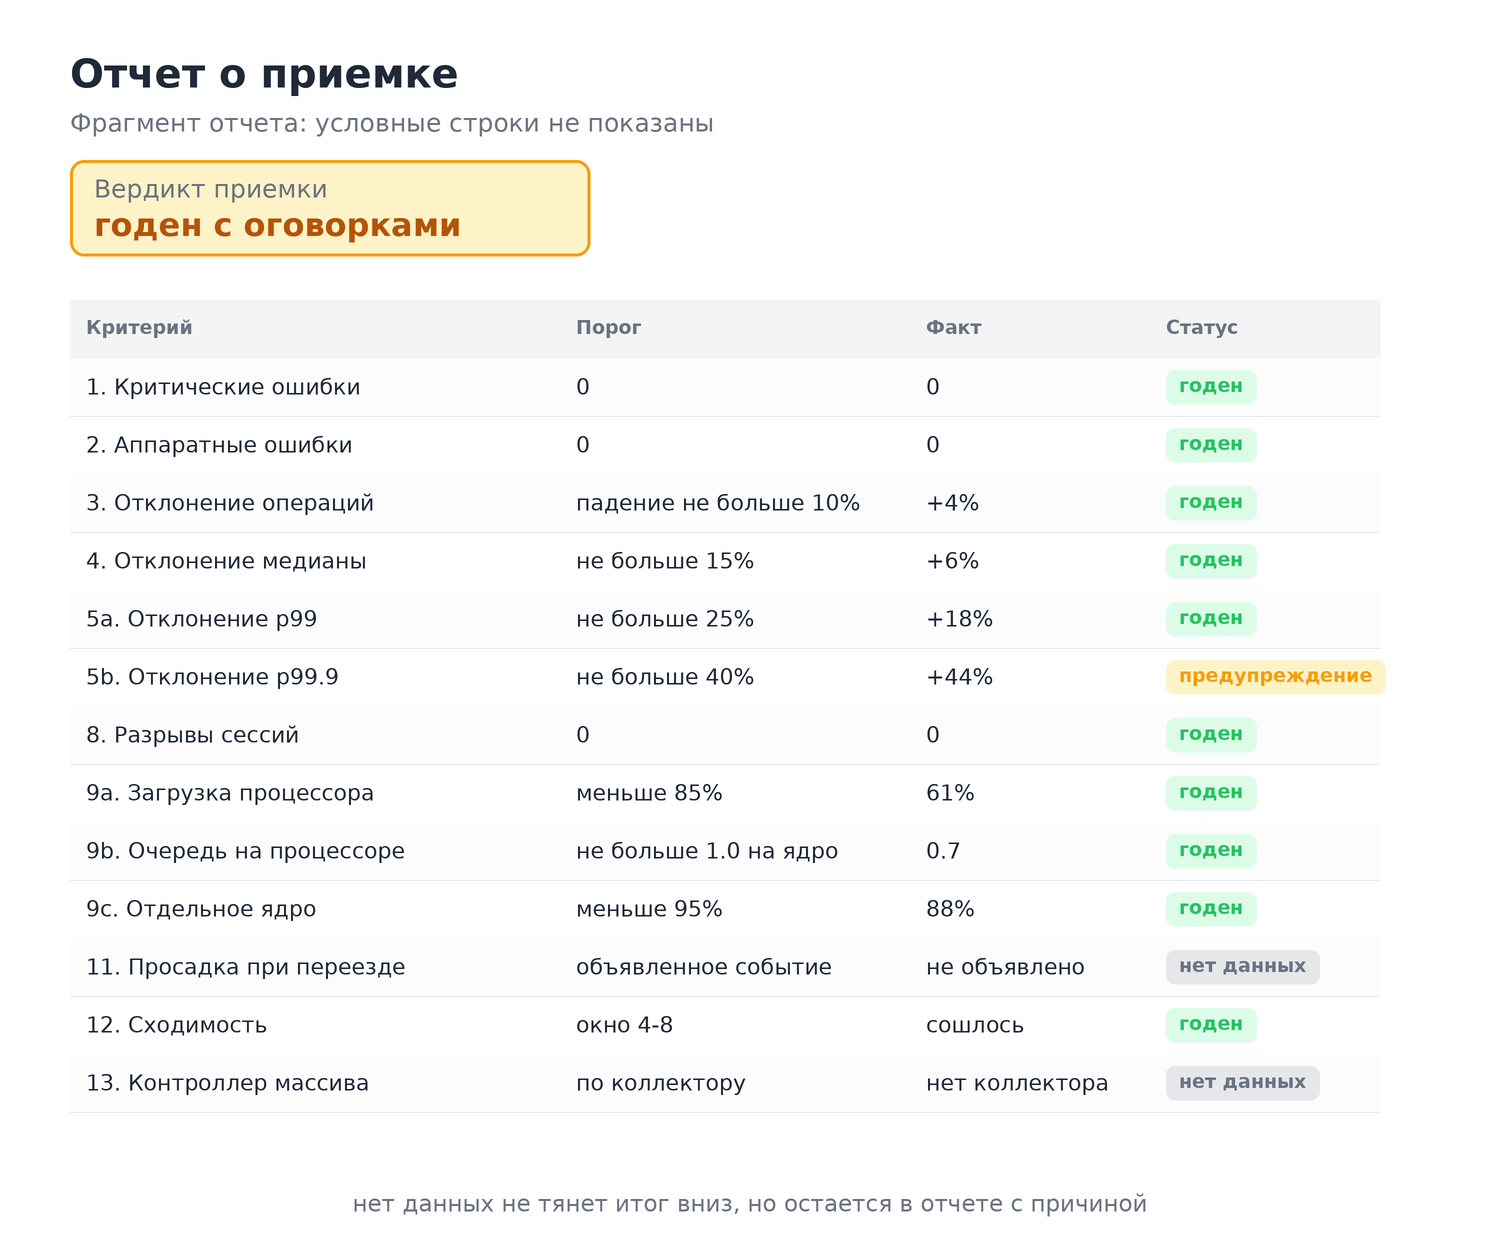
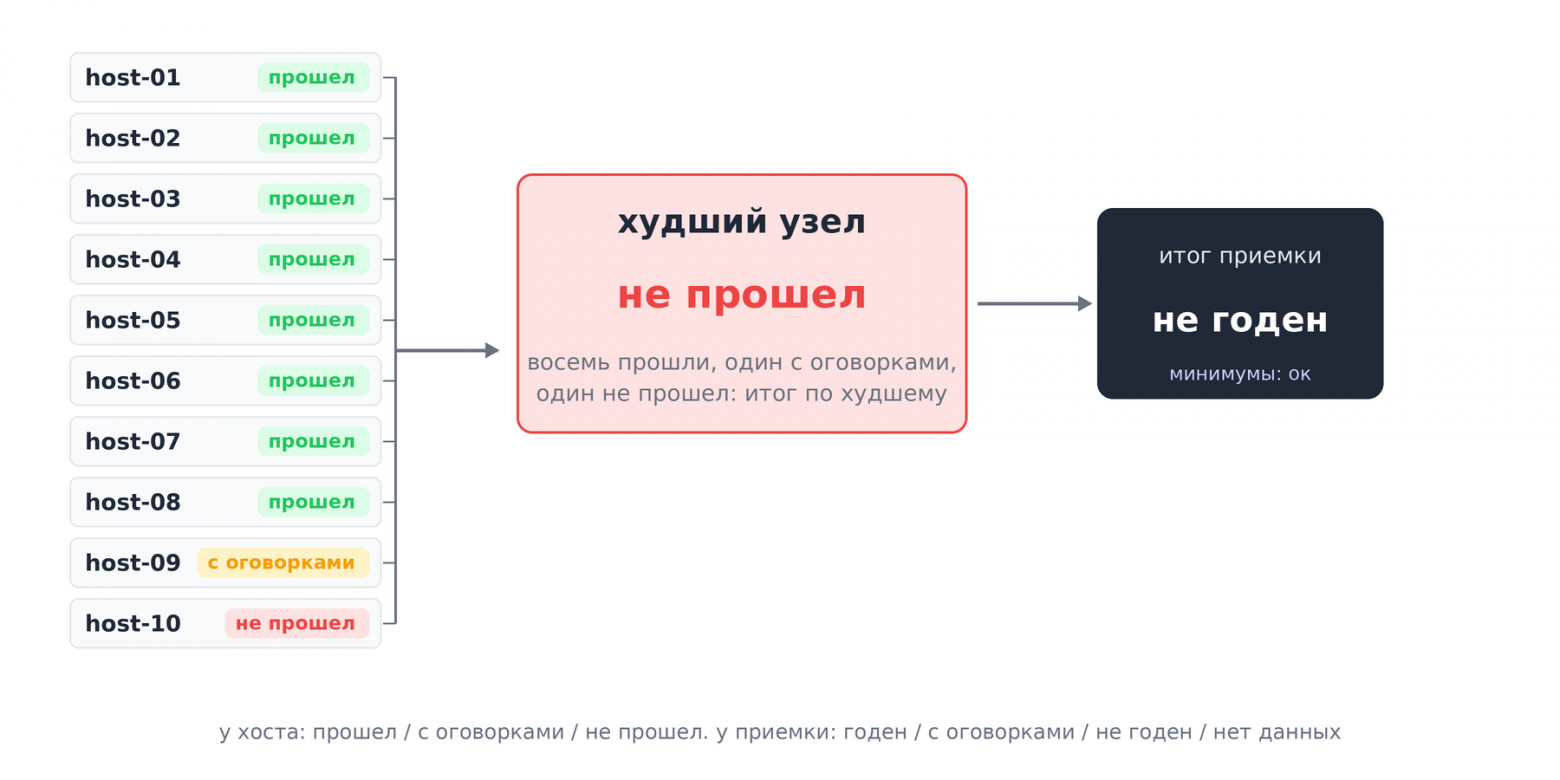
Полные 18 строк с порогами и тяжестью - в подробностях. Это правила инструмента, а не универсальные требования ко всем СХД: пороги согласуются под задачу.
Что делаем, если данных не хватает
Отсутствие ошибок и отсутствие сведений об ошибках - разные результаты. Если счетчик не удалось прочитать, мы не записываем ноль. В отчете остается «нет данных» с причиной.
Три случая. Проверка не нужна для этого теста. Нужные показатели не удалось собрать. Запланированное действие не подтверждено. Если проверка обязательна, положительного итога остальных проверок недостаточно: нужны данные или повтор.
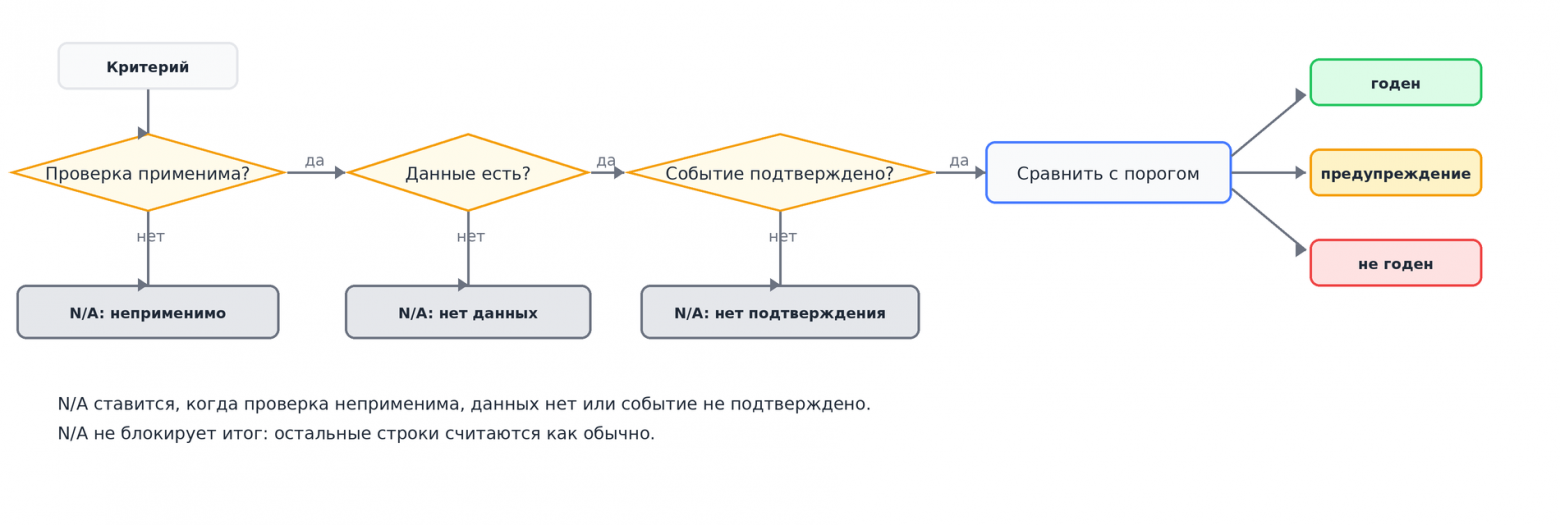
Если событие состоялось, наблюдение работало и простоя не было, это измеренный ноль и основание для «годен». Если события не было или нет подтверждения, засчитывать «годен» не за что: строка получает N/A с причиной. Обозначение N/A в отчете значит «нет данных».
N/A не блокирует приемку: когда остальные строки прошли, итог будет «годен». Для критичного критерия такой N/A считайте ручным блокером: инструмент покажет причину, но решение останется за человеком. По таким строкам мы чиним коллекторы и добавляем критерии, а причина в отчете остается, чтобы через месяц было понятно.
Что можно применить у себя
Зафиксируйте критерии и допуски до прогона.
Прогрейте систему, считайте перцентили по отдельным замерам и проверяйте сходимость по окну.
Соберите итог по худшему узлу, ведите список N/A и описание окружения эталона.
В нашей работе есть три ограничения. В методике максимум 25 раундов, в оценщике по умолчанию 10: система, которой нужно 15 раундов, получит «не сошлось» там, где по методике прогон еще шел бы. Окружение эталона заполняем минимально: прошивку и топологию инструмент сам не собирает. В минутных бакетах p99 усредняется, поэтому короткий пик в длинной истории может потеряться.
Подробности для специалистов
Полные критерии приемки11 строк относятся к любому прогону, но данные для них могут отсутствовать - тогда строка получает N/A. Еще 7 включаются, когда есть данные или объявленное событие.
Критерий | Порог по умолчанию | Если нарушен |
|---|---|---|
Критические ошибки системы | 0 | не годен |
Аппаратные ошибки | 0 | не годен |
Падение операций или полосы против эталона | не больше 10% | не годен |
Отклонение медианы (p50) | не больше 15% | не годен |
Отклонение p99 | не больше 25% | не годен |
Отклонение p99.9 | не больше 40% | предупреждение |
Разрывы сессий | 0 | не годен |
Загрузка процессора | меньше 85% | не годен |
Очередь на процессоре | не больше 1.0 на ядро | не годен |
Загрузка отдельного ядра | меньше 95% | не годен |
Сходимость устойчивого режима | сошлось | не годен |
Коллектор - компонент, который собирает показатели системы.
Критерий | Когда включается | Если нарушен |
|---|---|---|
Суммарное отклонение по слоям | при прогоне по нескольким слоям | сравнивается с согласованным порогом |
Деградация в длительном тесте | в длительном прогоне | не годен |
Ошибки команд iSCSI | при счетчиках сессий | не годен |
Ошибки ввода-вывода устройства | при счетчиках устройства | не годен |
Температурный троттлинг NVMe | при счетчиках троттлинга | не оценивается, пока счетчиков нет |
Просадка при переезде или перестройке | когда событие объявлено | не годен, если простой выше порога |
Загрузка контроллера массива | когда стоит коллектор | не годен, если очередь выше предела |
Превышение p99 дает «не годен», а p99.9 - предупреждение. p99.9 называют сверххвостом: это самые редкие операции. На коротком прогоне таких операций мало: p99.9 шумит, и блокирующий критерий ловил бы случайные выбросы. Но рост p99.9 может показать изменения, еще незаметные по p99, поэтому игнорировать его нельзя.
Отдельно от критериев работает политика расхождения часов: если часы агентов расходятся сильнее допустимого, прогон можно предупредить, исключить из сравнения или прервать.
Для окна из n раундов:
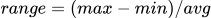
<= 0.20
и
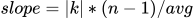
<= 0.10.
Наклон k считается линейным приближением по точкам окна и нормируется на все окно, а не на один раунд. Размах в 20% не означает симметричную полосу плюс-минус 10%: при среднем 100 точки 96 и 116 дают размах 20%, хотя верхняя выше +10%.
Настройка порогов
acceptance:
  p50_deviation_max_pct: 15
  p99_deviation_max_pct: 25
  # абсолютный порог задается договором; здесь пример
  p99_absolute_ms: 20
  p999_deviation_max_pct: 40
  throughput_deviation_max_pct: 10
  cpu_busy_max_pct: 85
  per_core_busy_max_pct: 95
  runq_len_max_ratio: 1.0
sync_barrier:
  drift_policy: warn
  offset_limit_ms: 50
Ошибки и разрывы сессий здесь не настраиваются: их порог всегда ноль. Абсолютный порог p99 заменяет процентный, а не добавляется к нему. Порог расхождения часов по умолчанию 50 мс, целевая точность привязки - 30 мс по p99.
Сравнение с эталоном
У сравнения с эталоном два разных вопроса. Первый: годна ли система. Это приемка, она сравнивает замер с контрольным и смотрит отклонения: медиана (p50) 15%, p99 - 25%, p99.9 - 40%, пропускная способность - 10%. Второй: не стало ли хуже между сборками. Допуски там строже: 2% по операциям и полосе, 5% по задержке. Сборки сравнивают на одном стенде и в одном окружении: шум меньше, порог строже.
storload baseline diff --a baseline.json --b run.json --iops-tol 2 --lat-tol 5Флаги –iops-tol и –lat-tol задают допуски в процентах: 2 по операциям и полосе, 5 по задержке. Отклонение больше - сравнение вернет «не годен».
Эталон сохраняем командой, и в описание окружения попадают только движок нагрузки и режим. Версию ядра, прошивку массива, топологию и размер кэша инструмент сам не собирает: их вписывает инженер. Забыть про окружение - и начнется разбор «стало хуже», а причина в обновленной прошивке.
Что происходит с историей
Для длительных прогонов замеры прореживают: посекундные данные хранятся горячими 6 часов, дальше сворачиваются в минутные бакеты, то есть сводные записи за минуту, с разрезом по устройству, агенту и раунду. Средние инструмент считает по числовым метрикам, максимум по ядрам сохраняет как максимум: он и ловит насыщение. Прогон на 30 дней дает около 2.6 млн секундных замеров, после сворачивания - около 43 тыс. бакетов: примерно 7 МБ вместо 400 МБ.
Следующий шаг - хранить в бакете гистограмму (HDR или t-digest), а не среднее: такие гистограммы можно объединять и оценивать общий перцентиль с ограниченной точностью; это лучше, чем усреднять готовые p99. Пока не сделано; для свежих данных есть горячее окно.
Итог
Хвост виляет собакой, но поводок держит инженер: критерии, сходимость и вердикт по худшему узлу. Инструмент автоматизирует эти решения, но не примет их за вас. Когда после замера остается вопрос «А точно ли все хорошо?», значит, чего-то из этого не было.
Что дальше и как с нами говорить
Следующая статья - про воспроизводимость, потом - про диагностику падений. Ждем ваших комментариев. Если вы тестируете СХД и наступали на похожие грабли, расскажите: чужие грабли дешевле своих.
Источники
SNIA, Solid State Storage Performance Test Specification 2.0.2 - правила устойчивого состояния и окно измерения.
Brendan Gregg, The USE Method - порядок проверки ресурсов, на который опираются критерии по процессору и очереди.


Комментарии 0