Расскажу реальную историю из компании, которая создавала OCS с поддержкой параллельного чарджинга. Начнём с теории — без неё сложно понять, насколько серьёзна проблема. А в конце — эксперимент: один из способов решения задачи параллельного чарджинга на CAS и сравнение с распространённым подходом, который используется в OCS сегодня.
Что такое параллельный или многосервисный чарджинг
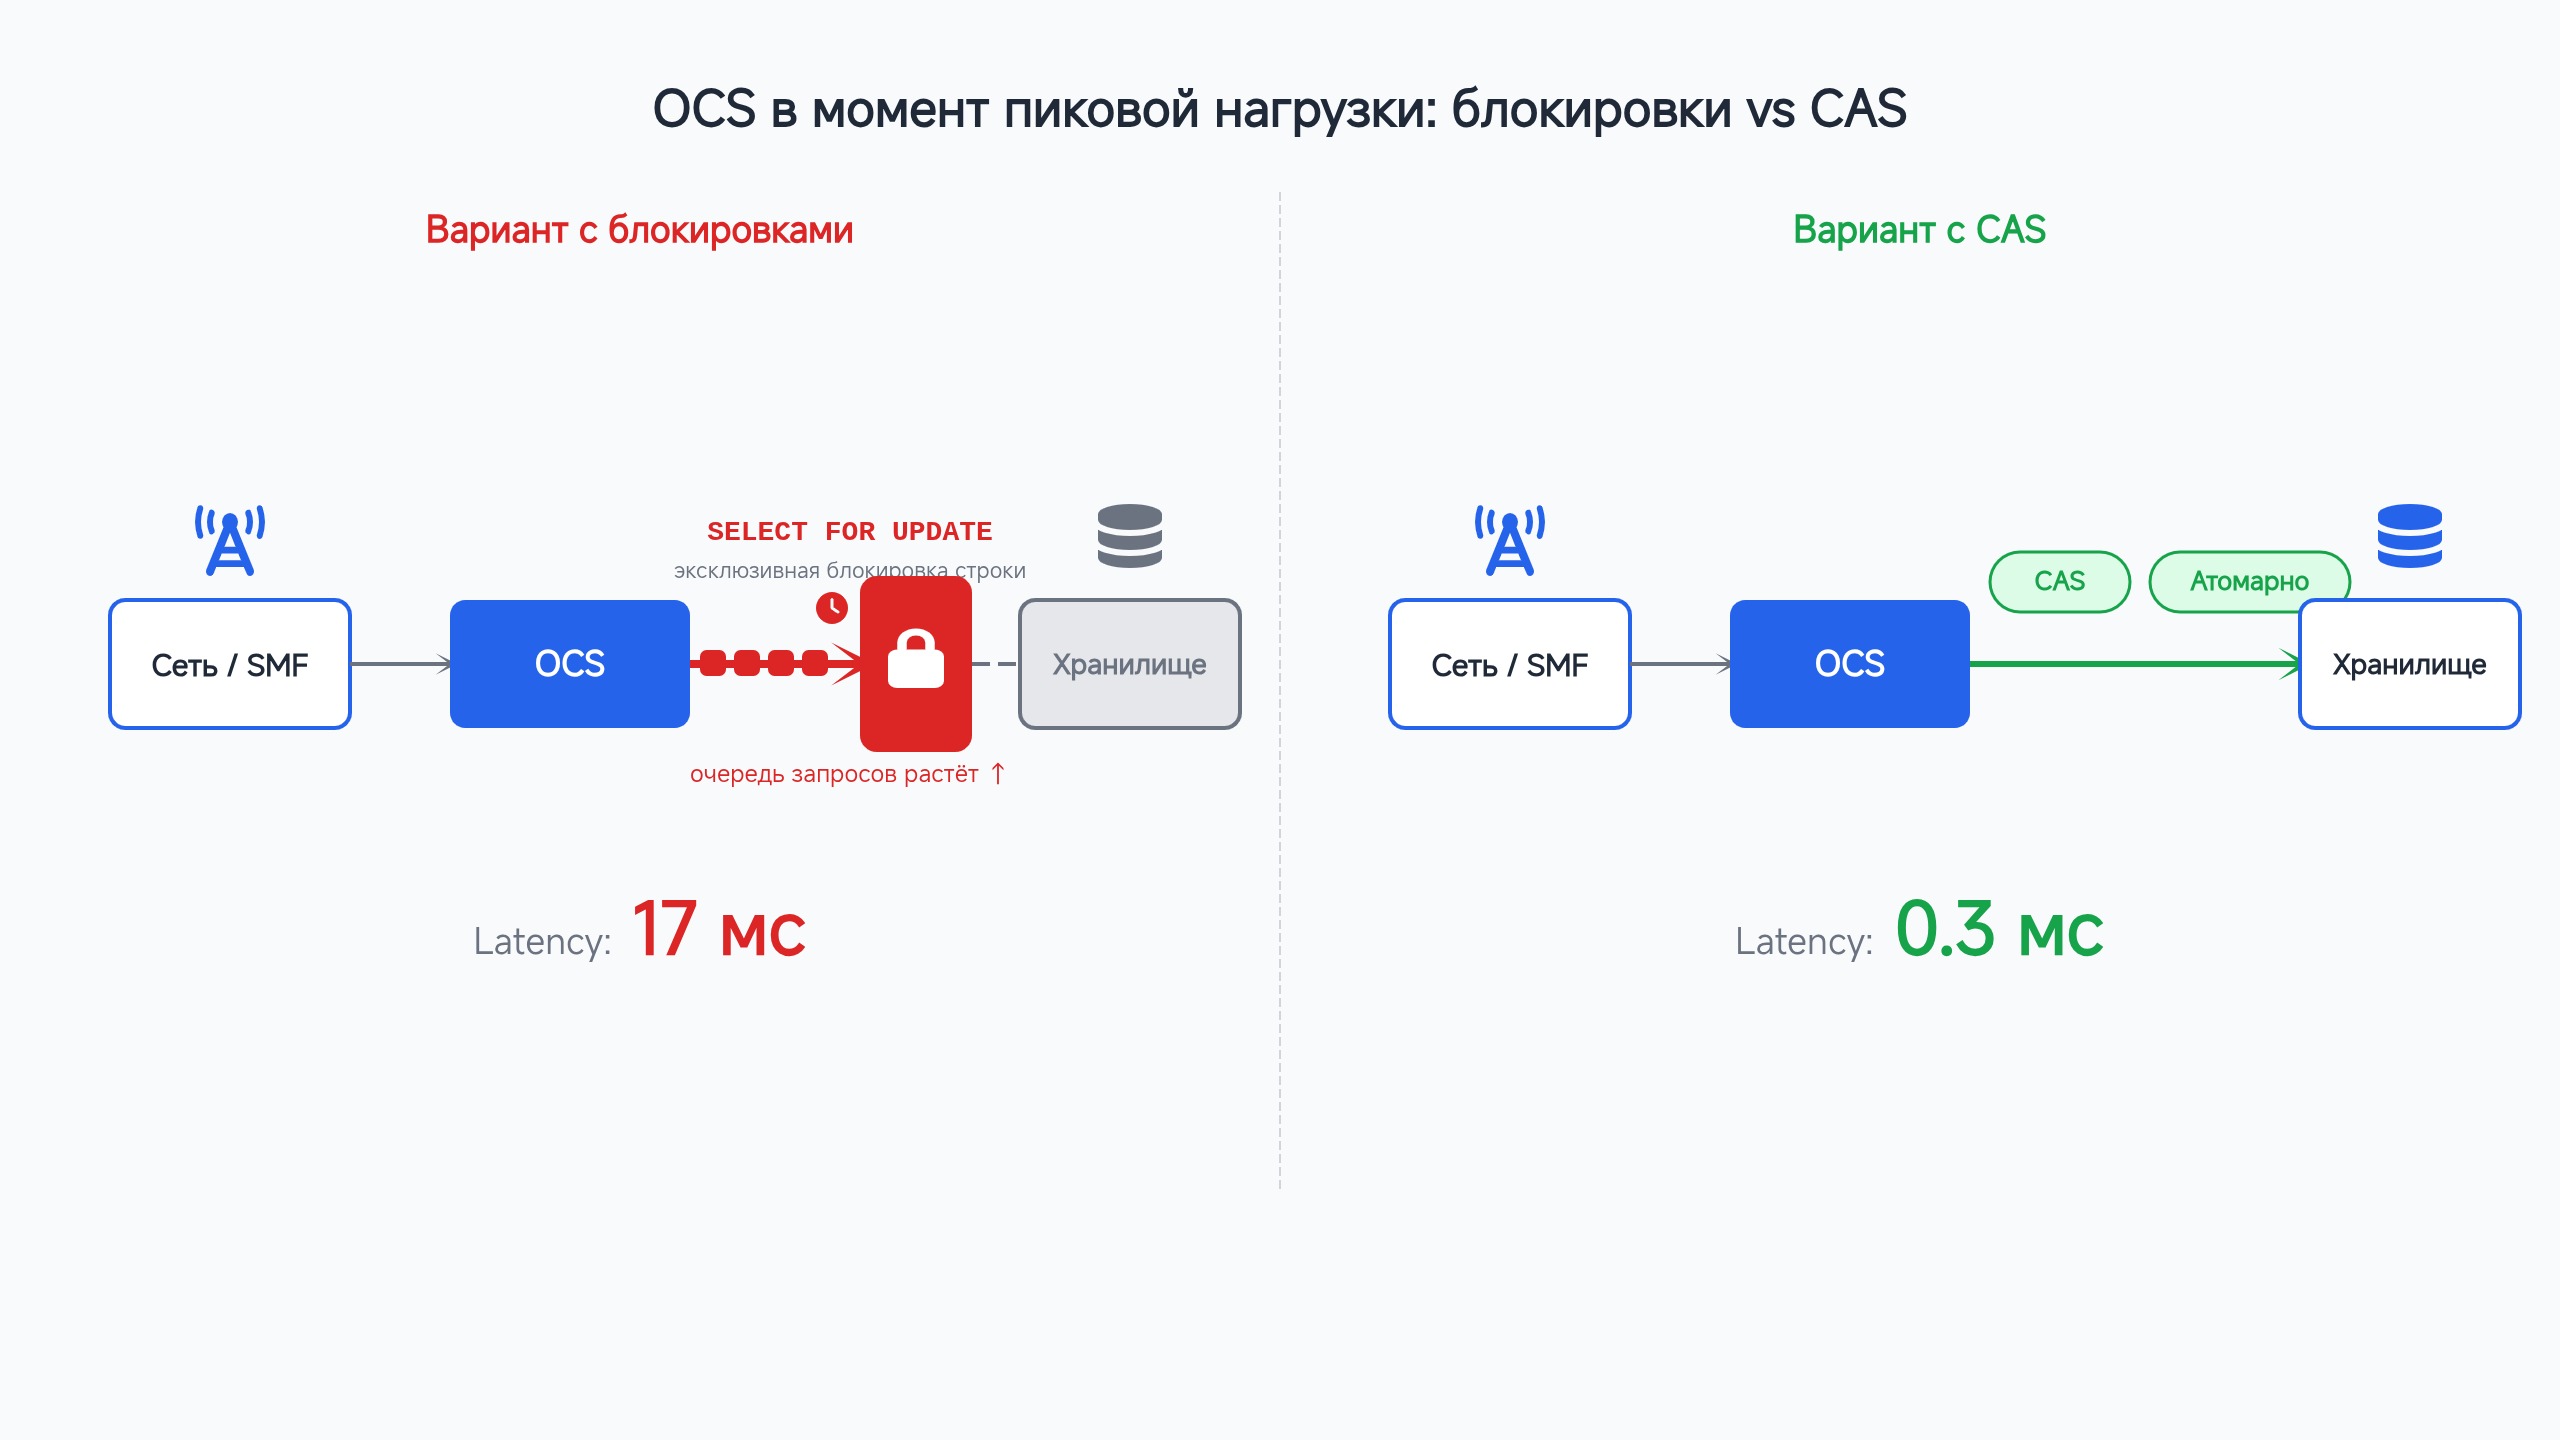
Параллельный (многосервисный) чарджинг — это когда у одного абонента сразу несколько сервисов тратят общий баланс: например, на телефоне крутится видео, фоном качается обновление, а умные часы передают телеметрию. Каждый сервис хочет свою порцию квоты, и система должна быстро решить, сколько можно выделить, чтобы суммарно не уйти в минус. Обычно в базе данных для этого ставят временную блокировку строки с балансом: пока один запрос её обрабатывает, остальные ждут своей очереди.
При большом числе одновременных запросов эта очередь быстро разрастается, и ответы начинают приходить с заметной задержкой — иногда задержки доходят до секунд. Подобные задержки плохо влияют как на 4G, так и на 5G сети. Нередко подобные задержки приводят к повторным запросам со стороны сети и это может превратиться в лавину запросов. В сетях 5G ситуация ещё жёстче: квоты обновляются чаще, всплески нагрузки случаются одновременно у многих абонентов, и такие задержки уже ломают качество сервиса.
Подходы к решению
Чтобы не зависеть от очередей, баланс держат как специальную ячейку, которую можно менять без блокировок: система сразу пытается «зарезервировать» нужную сумму, и если в этот момент кто‑то другой тоже что‑то списывает, она просто мгновенно пробует ещё раз. Каждый сервис работает со своей отдельной записью, поэтому их запросы не мешают друг другу. Возврат неизрасходованной квоты делают через такую же быструю операцию, а чтобы случайно не вернуть деньги дважды при сбоях, используют простую проверку состояния — «уже закрыто» или «ещё активно». В итоге вместо ожидания в очереди система делает короткие повторные попытки, и даже при десятках параллельных сервисов задержки остаются минимальными.
Family charging или общая группа абонентов
К этой же группе задач относится и семейный кейс: у группы абонентов (например, членов семьи) общий баланс, но при этом действуют разные квоты — кому‑то положен безлимитный интернет, кому‑то — ограниченный пакет минут, а ребёнку — отдельный лимит трафика. Система должна одновременно учитывать и общий остаток, и персональные ограничения: когда один абонент расходует свою квоту, это уменьшает общий баланс, доступный всей группе, но не должно позволять другим участникам превысить свои лимиты. При параллельных запросах от разных членов семьи ситуация усложняется: несколько человек могут одновременно исчерпать свои квоты или израсходовать баланс основного аккаунта, при этом система обязана корректно обработать все эти запросы без конфликтов и заблокировать сервис при достижении нуля на балансе, оставив работать только то, что не зависит от баланса. Подход с быстрыми атомарными операциями и отдельными записями по каждому лимиту здесь работает так же: общий баланс уменьшается при резервировании, персональные квоты отслеживаются независимо, а проверка «хватает ли остатка в семье» происходит в рамках той же мгновенной операции без долгих блокировок.
Немного реальный кейс: что происходит внутри
Для упрощения будем использовать Diameter-терминологию. Аналогичные примитивы есть в сетях 5G.
Старт сессии: CCR‑I (Credit‑Control‑Request Initial)
Всё начинается с чистого листа. Абонент включает передачу данных на смартфоне или пытается позвонить. Для простоты рассмотрим только ocs часть, остальное аутентификация, привязка к соте, установка bearer'а не будем рассматривать вообще, но для чарджинга история начинается именно здесь.
Сетевой элемент (SMF в 5G, PGW в 4G) фиксирует попытку абонента выйти в сеть и отправляет в OCS пакет CCR‑I (Initial). В запросе — идентификатор абонента (MSISDN / IMSI), запрашиваемый сервис и размер первой порции квоты. Это не просто формальность: от ответа OCS зависит, пустят ли абонента в сеть вообще, или ответят - недостаточно средств на счете.
Что происходит в классической БД. OCS открывает транзакцию, проверяет по таблице абонентов, существует ли аккаунт и активен ли баланс. Далее INSERT новой активной сессии в таблицу сессий и эксклюзивное обновление (SELECT * FROM subscribers WHERE id = '123' FOR UPDATE) общего кошелька. Если абонент семейный или корпоративный, база блокирует не одну запись, а сразу несколько: родительский баланс, дочерний лимит, как минимум две строки.
Первый CCR‑I отрабатывает и OCS отправляет ответ CCA‑I. Шлюз получает CCA‑I с выданной квотой, сессия открыта, интернет побежал, звонок состоялся.
Абонент пошёл дальше: на смартфоне пошло видео, с ноутбука через модем отправили кучу фоток в VK, а умные часы параллельно спрашивают погоду, кроме того долгий звонок еще не закончен. Несколько устройств привязаны к одному аккаунту и потребляют баланс из одного кошелька. Локальные квоты расходуются быстро, поэтому сети необходимо отправлять новые запросы в сторону OCS такие как «а могу ли я продолжить использовать сеть дальше?»:
CCR‑U #1 от смартфона: «у меня видео в 4K, докинь хотя бы 50 МБ».
CCR‑U #2 от ноутбука: «файл на докачку, дай 100 МБ, а то не смогу скачать».
CCR‑U #3 от часов: «Я тут погоду решил обновить, мне не хватает 2 МБ».
В случае корпоративных или групповых аккаунтов количество CCR‑U может быть больше, но это не меняет того что будет происходить внутри.
Что в этот момент происходит в RDBMS:
OCS пытается ответить на все запросы разом, но проблема в том что мастер баланс один и с него надо списать, при этом отвечать всем надо быстро, иначе сеть решит что CCR‑U потерян и необходимо послать повтор.
Все потоки OCS, обрабатывающие эти CCR‑U, одновременно выполняют SELECT * FROM subscribers WHERE id = '123' FOR UPDATE. Поток № 1 успевает первым — и захватывает эксклюзивную блокировку строки абонента, ему повезло. Потоки № 2 и № 3 стоят и ждут, пока первый поток закончит свою работу и отдаст ресурс. Самое интересное происходит на стороне мониторинга. Количество транзакций растет, количество пакетов пришедших из сети растет, но процессор не потребляется, потому что все просто ждут. Усугубляет кейс, то что CCR‑U приходят в разные ноды OCS и эти ноды никак не связаны.
Что произойдет дальше, думаю, понятно всем - может образоваться лавина, из за того, что не все CCR‑U были отвечены вовремя.
Подобное поведение наблюдалось многократно и было сломано много копий на этом.
Потенциальные решения и все что было опробовано нами на кейсах реального заказчика
В том чарджинг-проекте, где я работал, мы это проверяли на трех базах данных, Oracle, Apache Ignite, Google Spanner. Скажу сразу, что приемлемо работал только Oracle, "остальные справлялись как то" и этот кейс был отмечен как "не работает" или "работает нестабильно и непредсказуемо".
Небольшое отступление
SELECT FOR UPDATE — очевидный антипаттерн, и мы это тоже пробовали. Отказаться от него — разумное и здравое решение, но, как оказалось, очень сложно реализуемое
Отказаться от
SELECT FOR UPDATEэто разумное и здравое решение, но как оказалось что очень сложно реализуемоеВариант через SELECT и optimistic locking не сработал. Идея понятная: читать строку, проверять версию, обновлять с условием и ретраить при конфликте. Но у каждой попытки есть side effect — сам SELECT, и при высокой конкуренции на горячей строке нода большую часть времени тратила на перечитывание данных. Чем больше конфликтов, тем больше чтений — и производительность ноды проседала именно в тот момент, когда нужно отвечать быстро. Кроме того подобное поведение влияло на соседние запросы, что приводило к росту задержек.
Event Sourcing. Суть: не удерживать блокировку на строку баланса, а писать в отдельную таблицу события «списано N единиц», «возвращено M единиц», а текущий баланс вычислять как сумму списаний и возвратов. Писать в append‑only журнал можно без конфликтов — это его главный плюс. Проблема в чтении: реальный баланс ты знаешь только на момент вычисления баланса, а к моменту применения твоего события конкурентные списания уже могли изменить остаток. Фактически система оперирует устаревшим значением и допускает уход в минус — на величину до суммы конкурентных резервов. Вполне рабочий подход, но не для OCS, так как минус означает потраченные деньги оператора, нужен компромисс, который ни один заказчик не был готов принять. А реализация — суммы, snapshot’ы, компенсирующие события — была настолько сложной, что её стоимость легко перевешивала выгоду от решения.
Следующий кандидат — взять Redis или Apache Ignite и держать баланс там, делая списание атомарными операциями этих систем. Идея выглядит привлекательно: у обеих систем быстрые инкременты и декременты в памяти. Но перечеркнул всё один нюанс: для чарджинга нужна не просто арифметика, а условное списание — «уменьшить на N, только если текущий остаток ≥ N», где проверка и запись — один неделимый шаг. Готового CAS ни Redis, ни Ignite не предоставляют. Если списывать вслепую — баланс может уйти в минус: один запрос вычтет больше, чем было, и все последующие апдейты получат отказ, хотя на счете фактически достаточно денег. Если сначала проверить остаток, а потом списать — это уже два шага, и между ними конкурент успеет изменить баланс: получаем ровно ту же гонку, от которой пытались уйти
Локальные блокировки выглядели заманчиво: держать состояние на одной ноде и блокировать локально — казалось, это избавит от тяжёлых распределённых блокировок. Но в распределённой системе эта идея упиралась в непреодолимое: нельзя гарантировать, что все CCR‑U от абонента попадут на одну ноду. Без такой гарантии локальные блокировки не решают проблему конкуренции, а только усложняют архитектуру. Приходится добавлять алгоритмы задержки и умную маршрутизацию, чтобы направить запросы куда надо. А любое искусственное замедление бьёт по латентности: не успел ответить вовремя — прилетел retry, и лавина запросов нарастает. В итоге мы снова приходим к той же проблеме, от которой пытались уйти.
Данные: 100 000 аккаунтов, из них 20% — семейные/мастер‑аккаунты с родительской привязкой. Баланс каждого аккаунта инициализирован на уровне 10 000 единиц.
Нагрузка: эмулятор генерирует поток событий CHARGE (10–500 единиц) и ROLLBACK (не более суммы последнего списания), распределяя их равномерно по случайным аккаунтам — без подбора «горячих» сценариев. Конкуренция возникает естественно: списание за дочерний аккаунт уходит на баланс мастер‑аккаунта, поэтому 20% мастер‑аккаунтов принимают основную часть всех списаний — модель семейного/корпоративного баланса сама создаёт конкуренцию.
Логика резервирования: для каждого события система определяла, является ли аккаунт мастер‑аккаунтом, и выполняла условное списание: «уменьшить баланс, только если остаток больше или равен запрашиваемой суммы». Это гарантирует отсутствие отрицательного баланса без дополнительных проверок.
Многопоточность: движок обрабатывал события несколькими потоками, читая их из очереди. Для ускорения разрешения связей «аккаунт‑родитель» использовался динамический кеш: при промахе обращение шло в БД один раз, далее данные брались из кеша, это разгружало базу.
Атомарность: в режиме PostgreSQL атомарность обеспечивалась одним условным
UPDATE ... WHERE balance >= ?на уровне БД. В режиме HurriCache — нативными CAS‑операциями на уровне ядра кеша.Метрики: замерялись throughput (ops/sec) и latency (avg, p50, p95, p99) в течение 60 секунд после прогрева. Отдельно учитывались отказы «недостаточно средств» (корректная бизнес‑логика) и технические ошибки.
Инфраструктура: PostgreSQL запускался в Docker‑контейнере, доступ через JDBC. HurriCache работал в кластерном режиме(3 ноды по 2 вокера на каждой ноде); для чистоты эксперимента дисковый I/O из горячего пути был исключён. Сразу оговорюсь что single node тоже проверялся результаты сравнимы с кластером.
Проблема блокировок строк реальна. PostgreSQL пытается выполнять атомарные обновления через условный SQL (
UPDATE ... WHERE balance >= ?), но «под капотом» движок базы данных всё равно захватывает эксклюзивные блокировки строк и сбрасывает транзакционный лог (WAL) на диск. С ростом конкуренции очереди лавинообразно растут, утягивая хвостовую latency (p99) за 120 миллисекунд — а это гарантированные таймауты в сетях 4G/5G и, как следствие, повторные запросы.CAS в оперативной памяти меняет правила игры. HurriCache полностью исключает дисковый ввод‑вывод и блокировки потоков из горячего пути. Конкуренция разрешается на уровне аппаратных атомарных инструкций CAS за микросекунды. Результат — предсказуемый профиль latency: даже на уровне p99 ответы укладываются в 1,3 миллисекунды, а пропускная способность масштабируется почти линейно.
Эксперимент
Реальные метрики продакшна раскрыть не могу — они под NDA. Поэтому я собрал эмулятор, воспроизводящий эту нагрузку (сам прототип писался с помощью ИИ, вся логика и методика — мои). Ниже — условия и результаты.
Чтобы сравнение было корректным, оба режима запускались на идентичном железе и с одинаковой логикой чарджинга. Тесты проводились последовательно на одной машине: сначала режим PostgreSQL, затем HurriCache — это исключает влияние сетевой вариативности и конкуренции за CPU между разнородными сервисами.
Стенд: Intel Core i9-11900K (8 ядер / 16 потоков), 128 ГБ RAM, Ubuntu 26.04. JDK OpenJDK 25.0.5. Эмулятор, PostgreSQL 16 (Docker, postgres:16-alpine, доступ через JDBC, конфигурация по умолчанию) и узлы HurriCache работали на одной машине; тесты запускались последовательно.
Метрика | PostgreSQL (4 потока) | HurriCache (4 потока) | PostgreSQL (8 потоков) | HurriCache (8 потоков) |
Throughput | 230,6 ops/sec | 14 570,1 ops/sec (~63x) | 463,2 ops/sec | 22 605,8 ops/sec (~49x) |
Latency avg | 17 338 µs (~17,3 мс) | 272 µs (~0,27 мс) | 17 267 µs (~17,2 мс) | 352 µs (~0,35 мс) |
Latency p50 | 806 µs | 215 µs | 877 µs | 293 µs |
Latency p95 | 111 479 µs (~111 мс) | 517 µs (~0,51 мс) | 103 299 µs (~103 мс) | 646 µs (~0,64 мс) |
Latency p99 | 120 599 µs (~120 мс) | 1 144 µs (~1,14 мс) | 120 072 µs (~120 мс) | 1 258 µs (~1,25 мс) |
Ошибки | 0 | 0 | 0 | 0 |
Интерпретация результатов
Вместо вывода
Проблема реальна, и многие решают её с переменным успехом. Но в нашем случае решение оказалось не в том, чтобы «переехать» на другую базу или добавить слой кеша, отказаться от транзакций (мы переезжали на Google Spanner и Apache Ignite, но проблема никуда не делась, а стреляла очень непредсказуемо). Оно было в том, чтобы перестать пытаться удержать состояние в виде строки, которую все хотят заблокировать.
После проведенного эксперимента результаты очевидны: мы пришли к модели, где каждая операция — это быстрый атомарный CAS, который либо проходит, либо мгновенно повторяется. Именно это позволило держать десятки параллельных CCR-U на одном аккаунте без очередей и без лавины ретраев.
Комментарии 0