Привет, Хабр! Меня зовут Андрей Бирюков. Я — независимый эксперт в области ИТ и ИБ, преподаю в учебных центрах и пишу статьи и книги.
На тему сравнения микросервисов и монолита написано множество статей, и во многих из них преимущество отдаётся микросервисам, что вызывает вполне заслуженное недовольство части читателей.
Но архитектура ИТ‑систем — это не религия и не маркер «современности», а инструмент с разной ценой владения. Микросервисы решают организационную проблему (много команд, зрелый домен, потребность в независимых релизах), а не техническую.
И если у вас этой проблемы нет, то вы платите распределённую цену за несуществующую выгоду.
В этой статье мы рассмотрим критерии, скрытые издержки и правила, которые помогут принять решение без холивара и без лишних седых волос.
Когда начинать с монолита (и не стесняться этого)
Монолит, при всех его кажущихся недостатках, представляет собой рациональный выбор по умолчанию для большинства новых проектов. Microsoft говорит об этом прямо: монолитная архитектура может быть разумным первым шагом, особенно для proof‑of‑concept и MVP.
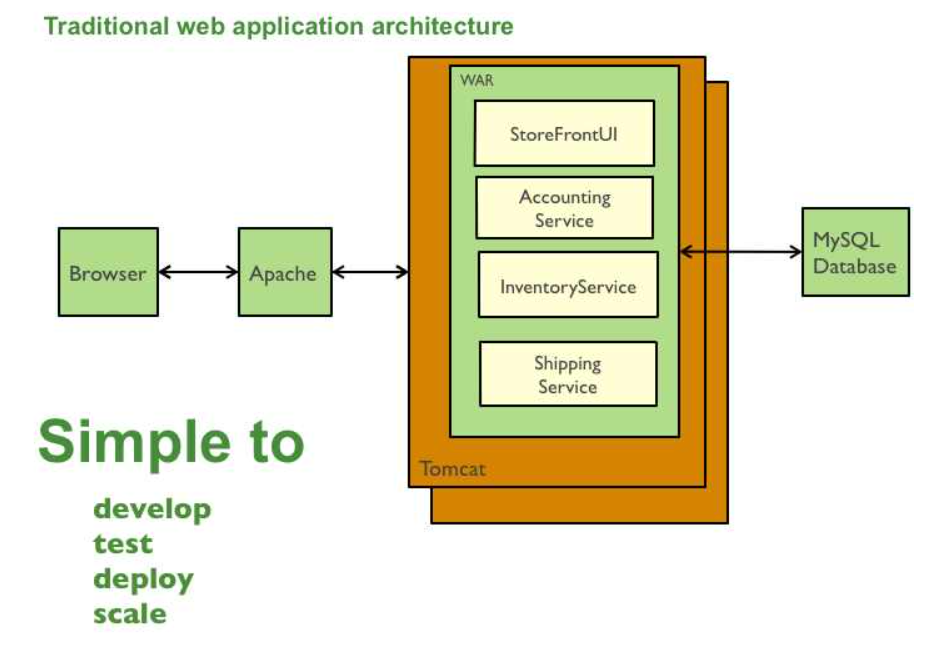
Так, если у вас команда 15–20 инженеров, то монолитная архитектура подойдёт вам лучше всего. Исследования показывают, что при командах меньше 20–30 человек накладные расходы на координацию микросервисов часто перевешивают выгоды.
Также, если границы вашего проекта ещё не определены чётко, то выделять сервисы по ним — риск получить в итоге гарантированный распределённый монолит. Помимо этого, монолит даёт самый быстрый маршрут от идеи до работающего продукта. На этом пути не надо тратить ресурсы на конвейер CI/CD, observability, service mesh, управление секретами
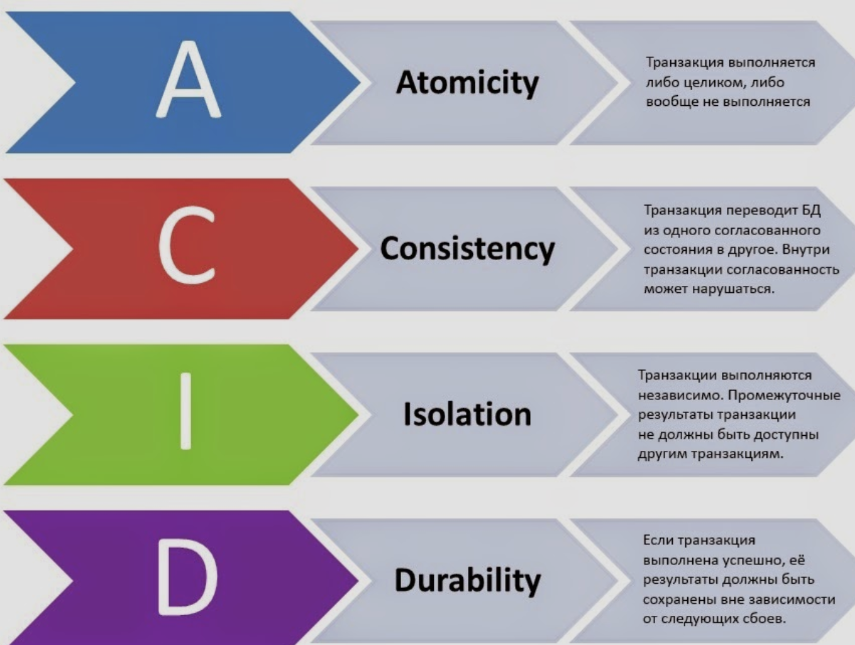
и другие модные плюшки.Монолит хорошо подойдёт там, где нагрузка ещё не упёрлась в потолок, нет измеренного bottleneck, который требует независимого масштабирования одного компонента, и бизнес‑логика требует ACID‑транзакций между сущностями (финансы, склад, заказы).
Но здесь важно сделать одно уточнение: «монолит» не означает «лапша». Модульный монолит имеет явные границы модулей внутри одного деплоя. Это часто недооценённая золотая середина, так как вы получаете простоту эксплуатации монолита и готовые швы для будущего выделения сервисов, если/когда это понадобится.
Итак, с монолитом разобрались. Теперь давайте рассмотрим преимущества микросервисов.
Когда сразу проектировать микросервисы (и не обманываться)
Надеюсь, прочтение предыдущего параграфа не привело читателя к мысли о том, что всё нужно строить только на монолите. Это, конечно же, не так. Микросервисы начинают окупаться при совпадении нескольких условий — не «одного», а именно комбинации.
У вас должно быть несколько (три и более) команд с разными циклами релизов, которые не блокируют друг друга общим пайплайном, так как независимый деплой — это главный выигрыш микросервисов. Помимо этого, вы должны понимать, где у вас находится узкое место в конкретном домене. Например, один компонент требует на порядок больше ресурсов, чем остальные (обработка видео vs личный кабинет).
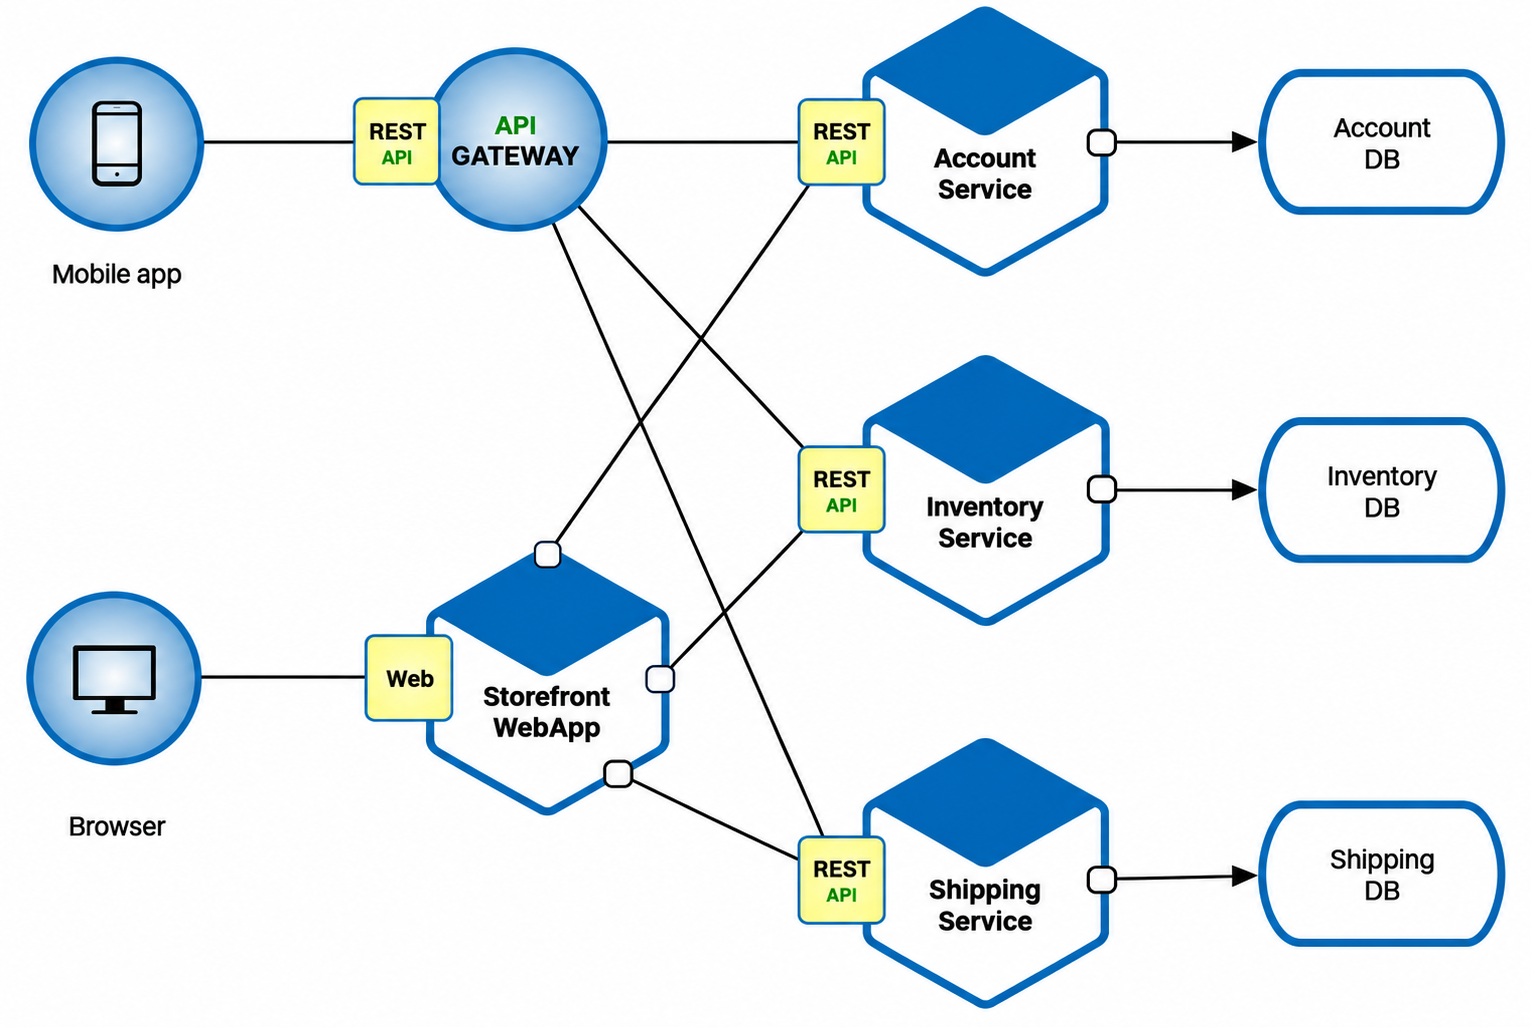
Для вас критична изоляция отказов, то есть падение платёжного модуля не должно ронять каталог. Но помните: это лечится и на уровне процессов/пулов, и в монолите.
При этом домен должен быть достаточно зрелым, границы должны быть понятны, и вы не должны менять их каждые две недели.
Ну и должна быть платформенная зрелость, заключающаяся в наличии CI/CD на каждый сервис, distributed tracing, централизованных логов, service discovery и управления конфигурацией.
Но если вы отвечаете «да» на вопрос «хотим микросервисы», но не можете назвать ни одного измеренного bottleneck или организационного трения, которое они решают, — это преждевременная декомпозиция. «Возврат монолита» в 2025–2026 — это не отказ от распределённых систем, а коррекция именно преждевременной и организационно необоснованной декомпозиции.
Скрытые издержки или что не пишут в презентациях
А теперь давайте поговорим о тех недостатках, которые есть у каждой из архитектур, и начнем с монолита.
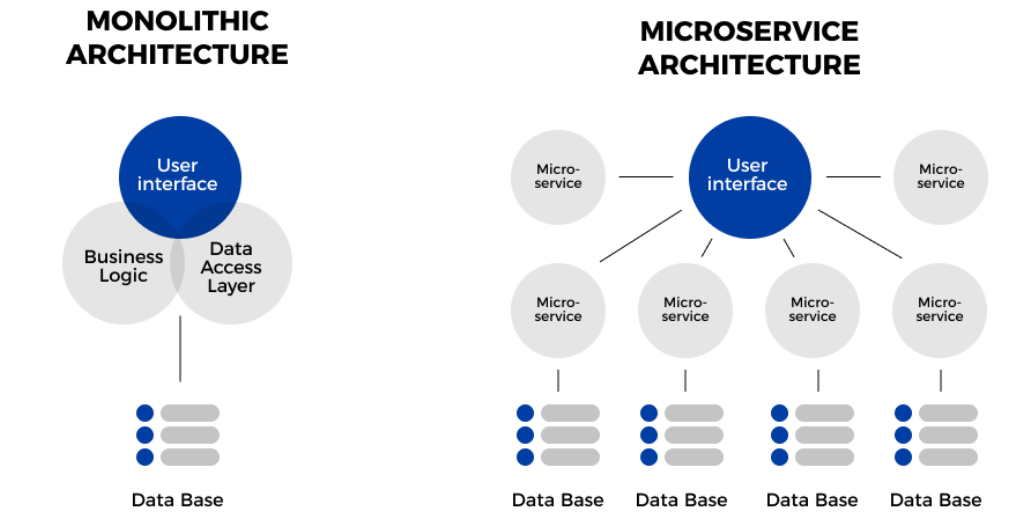
Первая проблема — связанность релизов. Любое изменение приводит к пересборке и деплою всего. Со временем это превращается в «религиозный» пайплайн, где одна команда ждёт другую. И это не техническая проблема, а организационная, и она проявляется при росте команды.
«Не откладывай на завтра то, что можно сделать послезавтра» — именно так звучит вторая проблема: иллюзия в стиле «потом отрефакторим».
Без дисциплины границы модулей размываются, и через год выясняется, что «выделить сервис» означает «переписать половину кода», потому что модули обросли скрытыми связями через общие таблицы и утилиты.
Ещё одной серьёзной проблемой является необходимость выполнять масштабирование целиком. Например, если 10% кода — это горячий путь, вы масштабируете все 100%. Это дорого и неэффективно, но это измеримая проблема. Но пока она не измерена, она не будет аргументом.
В результате мы рискуем получить монстра как результат ошибки проектирования на старте. Российская практика показывает, что системы превращаются в «монстров» не потому, что они монолиты, а потому что на старте архитекторы не заложили границы и не подумали о сопровождении.
Теперь давайте поговорим о микросервисах.
Здесь серьёзной проблемой является вызов метода по сети. Дело в том, что вызов в памяти занимает наносекунды, а вот сетевой вызов — уже миллисекунды, плюс сериализация, аутентификация, повторы, таймауты, частичные отказы. Всё, что в монолите было бесплатно, здесь становится, по сути, отдельным проектом.
Также в микросервисах технический долг растёт быстрее. Так, промышленное исследование показало, что плотность технического долга в микросервисах значительно увеличивается со временем, тогда как в изученном монолите она оставалась стабильной или снижалась. Скорость роста долга прежде всего связана с количеством сервисов.
Помимо этого, не стоит забывать и о стоимости облака и observability. Межсервисный трафик, sidecar‑прокси, распределённая трассировка, логирование — всё это счёт, который растёт незаметно. Для небольшой команды это может оказаться неподъёмным.
Из‑за сложности микросервисной архитектуры отладка зачастую становится археологией. Так, один запрос может проходить через 5 сервисов, а воспроизвести инцидент локально почти невозможно без зрелой observability. Соответственно, время на отладку растёт непропорционально.
Наконец, есть сложности деплоя: работа с API‑контрактами, версионированием и обратной совместимостью становится достаточно объёмной задачей, которую кто‑то должен выполнять. И часто это те же люди, что пишут код.
Как не уйти в избыточность и не накопить долг
Теперь давайте поговорим о балансе при выборе архитектуры. Здесь всегда начинайте с модульного монолита, если нет явных причин для обратного. Как уже упоминалось выше, модульный монолит — это не «монолит, который потом станет микросервисами». Это полноценная архитектура, которая, с одной стороны, даёт простоту эксплуатации одного деплоя, а с другой — сохраняет границы через интерфейсы модулей и позволяет выделить сервис позже по готовому шву, а не переписывать всё.
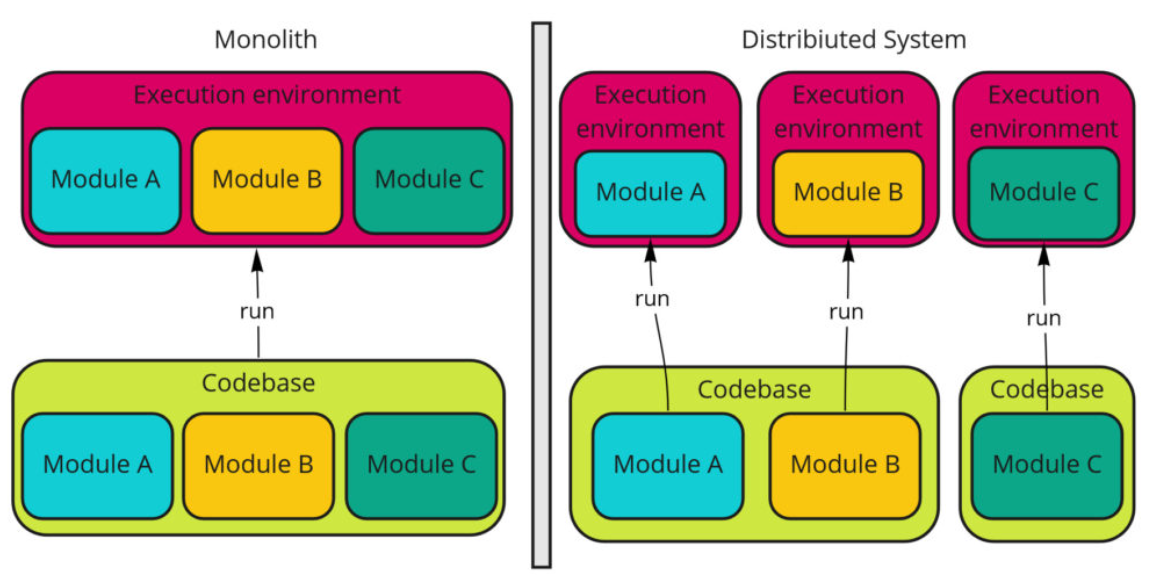
Далее, выделяйте сервис только по измеренной причине — не «потому что модно», а потому что:
команда X не может релизить независимо от команды Y (организационная причина);
компонент Z требует 10 x ресурсов по сравнению с остальными (техническая причина);
отказ компонента W должен быть изолирован по требованиям бизнеса (риск‑причина).
Если ни одной из этих причин нет, то такой сервис и не нужен, даже если очень хочется нарисовать стрелочки.
Не забывайте считать совокупную стоимость владения, а не только стоимость разработки. Монолит дешевле в разработке, но может стать дорогим в масштабировании и координации. Микросервисы дороже в разработке, инфраструктуре и observability с первого дня. Точка безубыточности обычно лежит там, где организационное трение монолита начинает стоить дороже, чем распределённая сложность. И для большинства случаев это не стартап на 5 человек.
А ещё важно помнить, что «распределённый монолит» — это, пожалуй, худший из миров. Например, если вы разделили сервисы, но они деплоятся вместе (или блокируют друг друга), при этом у них общая база данных и изменение в одном требует синхронного изменения в другом, то вы получили все минусы микросервисов без плюсов, то есть это не промежуточное состояние, а технический долг, который нужно целенаправленно устранять (либо обратно укрупнять).
Ну и преждевременная декомпозиция — это, по сути, такой же технический долг, как и отсутствие границ. Только он дороже: вы платите за него инфраструктурой, latency и когнитивной нагрузкой команды. «Мы потом выделим сервисы, когда будет нужно» — это плохая стратегия, если вы не заложили границы. Но подход «мы сразу сделаем микросервисы на всякий случай» будет ещё хуже.
Хотите проверить свои знания в архитектуре ПО? Пройдите вступительный тест и узнайте, какие темы стоит подтянуть.
Итоги
Итак, для принятия решения вам нужно определиться с тем, сколько команд будет работать над системой в ближайший год:
Если одна‑две, то лучше использовать монолит; если три и больше — микросервисы.
Если вы сейчас не можете точно назвать границы проекта, то лучше использовать монолит. Помимо этого, ответьте на вопрос: есть ли люди/бюджет на платформенную инженерию? Для применения микросервисов подойдёт только утвердительный ответ.
Ну и напоследок нужно понять, что для вас важнее на ближайшие 6 месяцев: скорость выхода или независимость релизов? Монолит подойдёт в первом случае.
Важно понимать, что хорошая архитектура не та, которая «выглядит современно на схеме», а та, которую команда может развивать без страха, эксплуатировать без героизма и менять без переписывания с нуля.
Монолит с чёткими границами и дисциплиной часто оказывается более «микросервисным» по духу (слабая связность, сильная инкапсуляция), чем десять сервисов, которые деплоятся вместе и ходят в одну базу.
Выбор архитектуры требует понимания того, как разные технологии ведут себя под нагрузкой и какие компромиссы стоят за каждым решением. Если хотите систематизировать знания и развить архитектурное мышление, присмотритесь к курсу «Архитектор программного обеспечения».
А углубиться в одну из технологий для построения отказоустойчивых систем можно на бесплатном открытом уроке:
23 ноября в 20:00. «NoSQL в бою: как Cassandra помогает строить отказоустойчивый бэкенд». Записаться
Другие вебинары ноября собрали в дайджесте мероприятий.


Комментарии 0